AI-søgning
Sådan vælger du en platform til AI-synlighed: tjekliste til 2026
14 kriterier, de spørgsmål du skal stille til demoen, advarselstegn og en skabelon til at vurdere platforme til AI-synlighed. Plus en faktatjekket shortlist med 8 værktøjer.
 Magnus Windeløv19. okt. 2026 · 21 min. læsning
Indhold
Vælg den platform, der fortæller dig, hvorfor AI vælger en konkurrent, og hvad du kan gøre ved det. Den skal dække de modeller og markeder, dine kunder bruger, og hvert tal skal kunne spores tilbage til rigtige svar.
De fleste værktøjer til AI-synlighed kan vise dig en score. Langt færre kan forklare den, og endnu færre hjælper dit team med at ændre den. Det er netop her, de fleste fejlkøb sker.
Jeg har købt marketingsoftware i ti år og har siddet på begge sider af bordet: in-house i SaaS- og e-handelsvirksomheder og for mere end 30 kundebrands i et bureau. AI-synlighed er den sværeste kategori, jeg har skullet vurdere. Tallene ændrer sig hver dag, alle leverandører tæller forskelligt, og demokontoen ser altid godt ud.
Derfor er denne guide den tjekliste, jeg selv ville ønske mig. Du får de 14 kriterier, der skiller platformene ad, de spørgsmål, du skal stille til en demo, advarselstegnene, en skabelon til vurdering, som du kan kopiere, og en shortlist med otte platforme, som vi har holdt op mod deres egne offentlige sider.
Én ting skal du vide først: Jeg arbejder i 3RD, som er med på listen. For at vise, hvordan hvert kriterium ser ud i praksis, bruger jeg skærmbilleder fra et demo-workspace. Det er et sportstøjsbrand, der måles i forhold til seks konkurrenter i Danmark, Sverige, Storbritannien og USA, på syv AI-modeller og 207 prompts. Brandnavnene er sløret, og tallene er ikke kunderesultater.
Det korte svar
Hvis du kun læser ét afsnit, så læs dette.
- Overvågning er blevet standardvare. Alle seriøse platforme sender prompts til AI-assistenter og tæller, hvor ofte brands bliver nævnt. Betal ikke ekstra for et dashboard.
- De reelle forskelle ligger tre steder: hvordan svarene bliver indsamlet, om platformen forklarer, hvorfor du taber, og hvem der klarer arbejdet efter diagnosen.
- Priserne er svære at sammenligne. Hver leverandør tæller en ”prompt” på sin egen måde. Regn alle tilbud om til svar pr. måned, før du sammenligner.
- Lav en pilot, før du skriver under. Kør 20–40 af dine egne kundespørgsmål i mindst to uger på dine rigtige markeder. En demokonto siger intet om din kategori, og et par dages data siger meget lidt om noget som helst.
Her er, hvad det betyder i praksis.
Det skal du have klar, før du taler med leverandører
Brug en time på det her først. Så bliver alle demoer kortere, og alle tilbud kan sammenlignes.
- Dine 20 mest værdifulde kundespørgsmål. Skriv dem, som en kunde ville spørge en AI-assistent: ”Hvad er det bedste lønsystem til en virksomhed med 50 ansatte i Danmark?” – ikke ”lønsystem”. Det bliver dine pilot-prompts.
- Dine markeder. Skriv hvert land og sprog op, du sælger på. Danmark på dansk og Danmark på engelsk er to forskellige markeder, fordi AI svarer forskelligt på hvert sprog.
- De AI-assistenter, dine kunder bruger. ChatGPT er næsten altid med. Tilføj Google AI Overviews, hvis du er afhængig af Google-søgning, Copilot, hvis du sælger til virksomheder, der kører meget på Microsoft, og Perplexity eller Claude, hvis dine kunder er tekniske.
- Fem konkurrenter. Vælg de brands, du taber aftaler til – ikke kun de største navne i branchen.
- Hvem der skal klare arbejdet. Skriv navnene på dem, der skal handle ud fra resultaterne, og hvor mange timer om ugen de har. Det afgør mere end nogen featureliste, hvilken slags platform du har brug for.
Sådan ser opsætningen ud i et demo-workspace: 207 kundespørgsmål for et sportstøjsbrand, samlet i otte emner og målt i Danmark, Sverige, Storbritannien og USA.
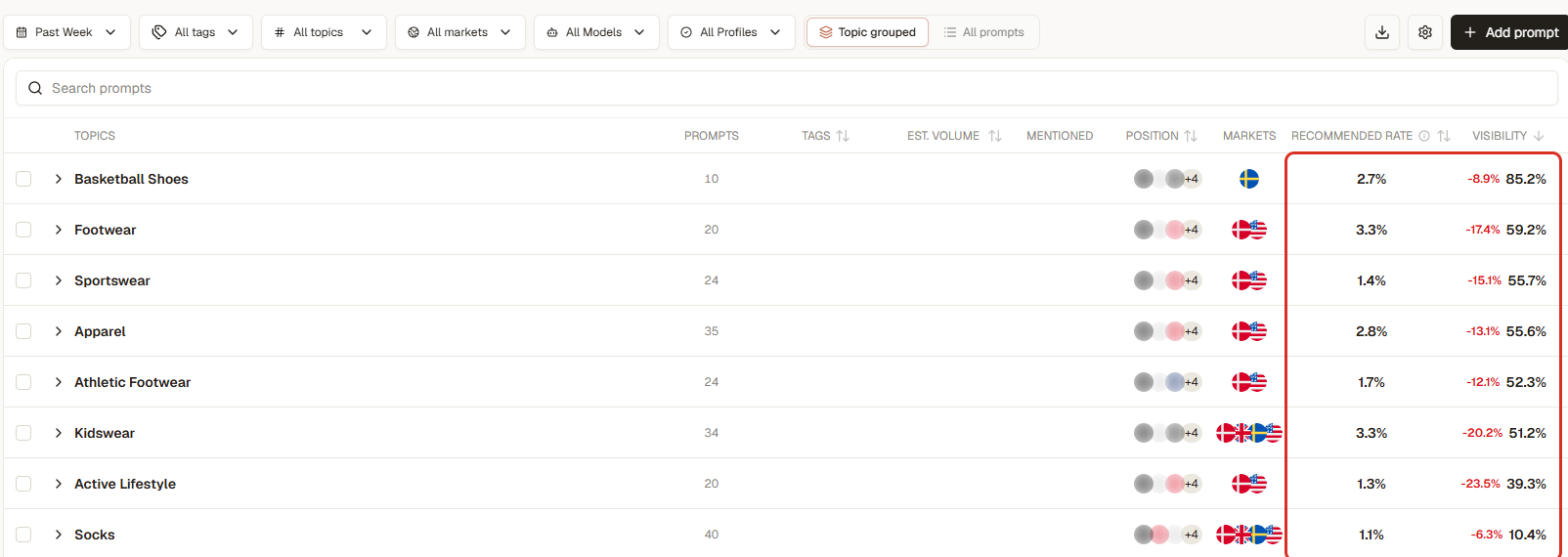
Kundespørgsmål samlet i emner – fra basketballsko med 85,2 % synlighed til strømper med 10,4 %. Hvert emne måles pr. marked. Demo-workspace; brandnavne er sløret.
De 14 kriterier, der skiller platformene ad
Kriterierne står i den rækkefølge, du møder dem som kunde: Kan jeg stole på dataene? Forklarer platformen resultatet? Kan vi omsætte det til handling? Og passer den til vores virksomhed?
Kan du stole på dataene?
1. Hvordan svarene bliver indsamlet. Platformene henter AI-svar på en af to måder. Nogle sender spørgsmålene gennem hver AI-udbyders API (application programming interface). Andre opsamler svarene fra den chat-brugerflade, folk faktisk bruger. Svar fra brugerfladen kan indeholde ting, som API-svar ikke har, fx shoppingkort eller live websøgning. API-svar er lettere at køre i stor skala og på mange markeder. Ingen af metoderne er forkert. Det vigtige er, at leverandøren fortæller dig, hvilken metode den bruger til hver model.
2. Hvilke AI-modeller der er med, og hvilke du kan slå til. Bed om den præcise liste pr. abonnement. Mange platforme reklamerer med ni eller flere AI-motorer, men har kun to til fire med i de billigste abonnementer. Tjek, at du kan skifte modeller senere, for kundernes adfærd ændrer sig.
Kriteriet betyder mere, end de fleste tror, for forskellige assistenter vælger forskellige vindere. I samlede 3RD-data fra 60 brands var den mest synlige konkurrent et andet brand på forskellige assistenter for 37 af dem (62 %) – med de samme prompts. Inden for det enkelte brand var forskellen mellem den bedste og den dårligste assistent 16 procentpoint i median (83 brands).
Sådan ser det ud i et demo-workspace. I den seneste uge blev sportstøjsbrandet nævnt i omkring 60 % af svarene i ChatGPT, men kun i omkring 20 % i Google AI Mode – på de samme spørgsmål.
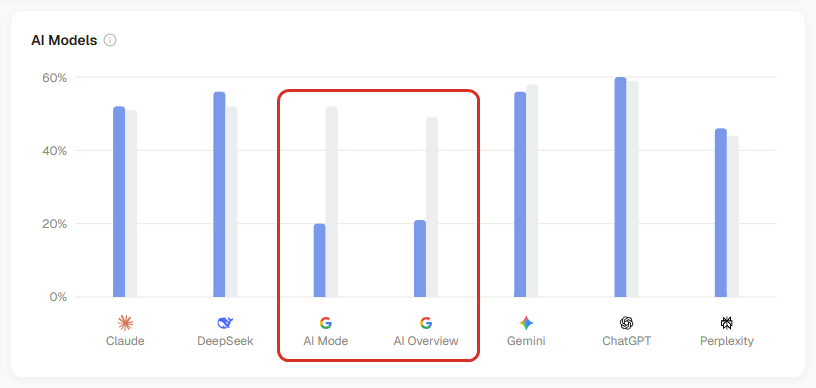
Synlighed pr. model: omkring 60 % i ChatGPT og omkring 20 % i Google AI Mode og AI Overviews. Demo-workspace; brandnavne er sløret.
3. Markeder og sprog. Spørg, hvordan platformen definerer et marked. Et godt svar er ét land og ét sprog, målt hver for sig, hvor AI-modellen får markedet som kontekst. Et svagt svar er ”Vi understøtter mere end 50 lande” uden et ord om sprog.
4. Hvordan prompts bliver talt. Det er her, det meste af forvirringen om priser opstår. Én leverandør tæller en prompt én gang, uanset hvor mange modeller den kører på. En anden tæller den én gang pr. model. En tredje tæller den én gang pr. model og pr. marked. Bed hver leverandør om at opgøre det sådan her:
svar pr. måned = spørgsmål × modeller × markeder × kørsler pr. måned
5. Hvor ofte der køres, og hvor meget svarene svinger. AI-modeller arbejder med sandsynligheder. Det samme spørgsmål kan få et andet svar i morgen. En platform, der kun kører hvert spørgsmål én gang om ugen, kan ikke skelne en reel ændring fra støj.
Hvor stor er støjen så? I samlede data fra 111 brands og 732.000 AI-svar svingede medianbrandets daglige synlighed 12,5 procentpoint mellem bedste og dårligste dag på en måned – uden at der var ændret i dets prompts. For 7 ud af 10 brands lå mindst én enkelt dag mere end 5 procentpoint fra brandets gennemsnit over 30 dage. Små prompt-sæt svingede mere: Brands med færre end ca. 100 svar om dagen svingede omtrent dobbelt så meget som brands med 230 eller flere.
En trend over 90 dage gør støjen synlig. De daglige kurver hopper op og ned, og når en AI-udbyder skifter modellen bag en assistent, knækker serien.
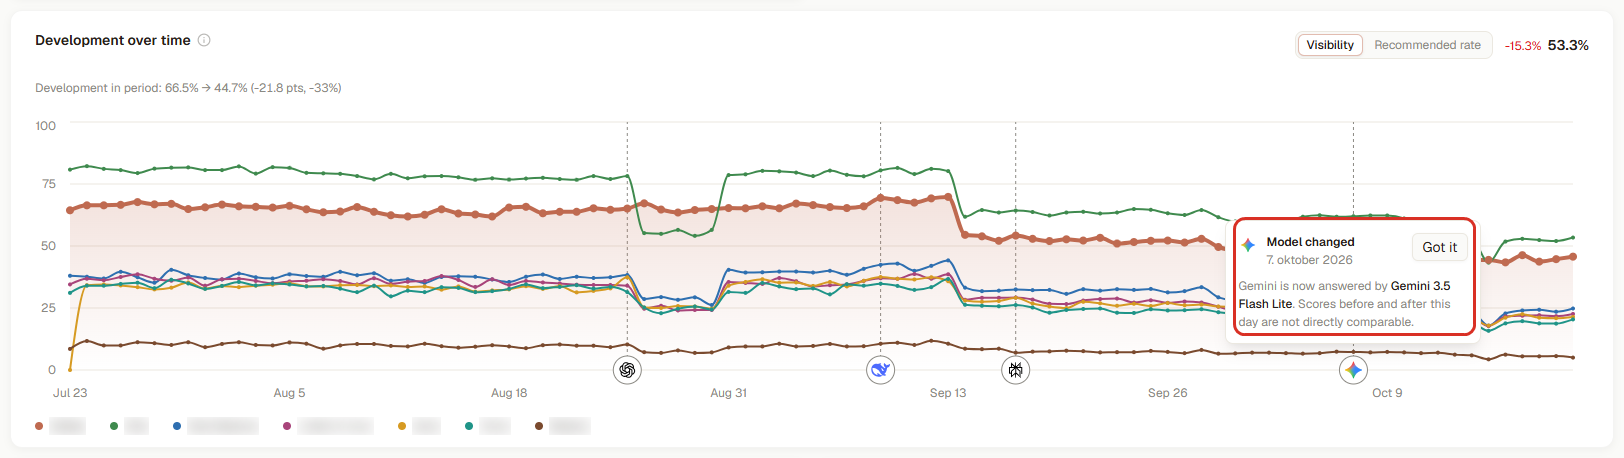
Tre måneders daglig synlighed. Scoren svinger fra dag til dag, og markeringen ”Model changed” den 7. oktober viser, hvor Gemini skiftede modelversion. Scorerne før og efter kan derfor ikke sammenlignes direkte. Demo-workspace; brandnavne er sløret.
Spørg derfor om to ting: hvor ofte hvert spørgsmål bliver kørt, og hvordan platformen viser dig, om en ændring er reel. Et godt svar indeholder daglige kørsler og en måde at markere modelskift på.
6. Sporbarhed. Hver score skal kunne åbnes, så du ser de faktiske svar og de kilder, AI henviste til. Kan du ikke klikke dig fra ”synligheden faldt 8 procentpoint” til de svar, der ændrede sig, kan du heller ikke forklare tallet for din CMO. Tjek også, at scoren viser sit grundlag. I et demo-workspace står sportstøjsbrandets 44,5 % for den seneste uge som 4.051 omtaler i 9.105 svar, og brandet er nævnt på 172 af 207 prompts. Det siger langt mere end en procentsats alene, fordi du kan se, hvor mange data der ligger bag.
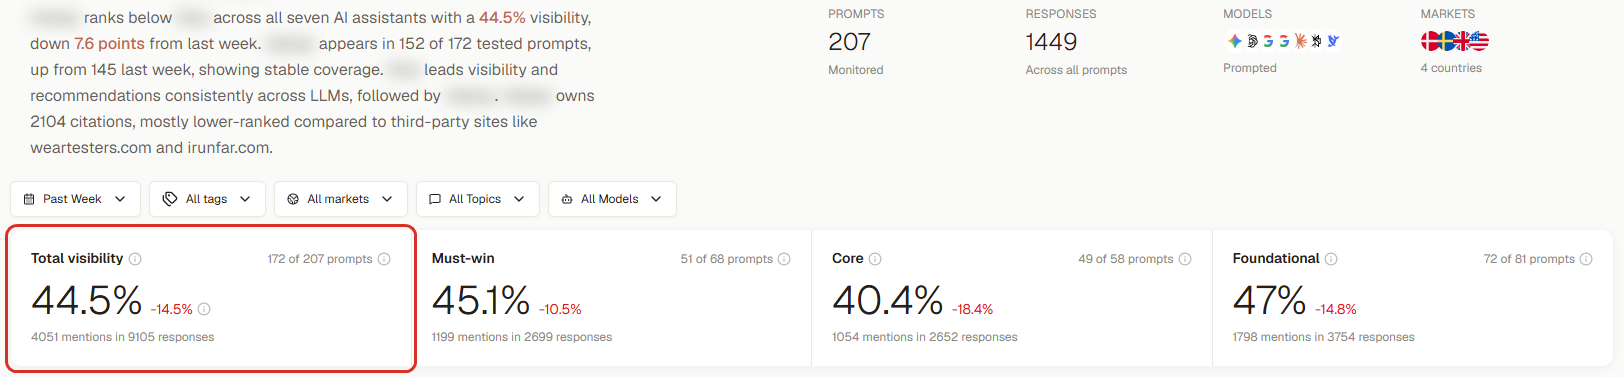
Overblik over synligheden for den seneste uge: 44,5 % med grundlaget 4.051 omtaler i 9.105 svar og en opdeling pr. prompt-niveau. Demo-workspace; brandnavne er sløret.
Forklarer platformen, hvorfor du ikke bliver valgt?
7. En diagnose – ikke kun en beskrivelse. En score fortæller, hvor du står. En diagnose fortæller, hvorfor AI vælger en konkurrent: en manglende sammenligningsside, en liste på et eksternt site, der nævner dem og ikke dig, eller en side, AI ikke kan læse. Bed leverandøren vise en diagnose for en rigtig konkurrent i din kategori.
Sådan ser en diagnose i klart sprog ud i et demo-workspace. I Danmark ligger sportstøjsbrandet på 43,4 %, mens lederen ligger på 49,3 %. Brandet mangler altså i omtrent 6 ud af 10 AI-svar. Diagnosen giver tre årsager i almindelige ord: Sidernes kvalitet begrænser, hvordan AI henviser til brandet. Dækningen i de medier, AI læser, er ujævn. Og kunder, der spørger AI, møder lederen først.
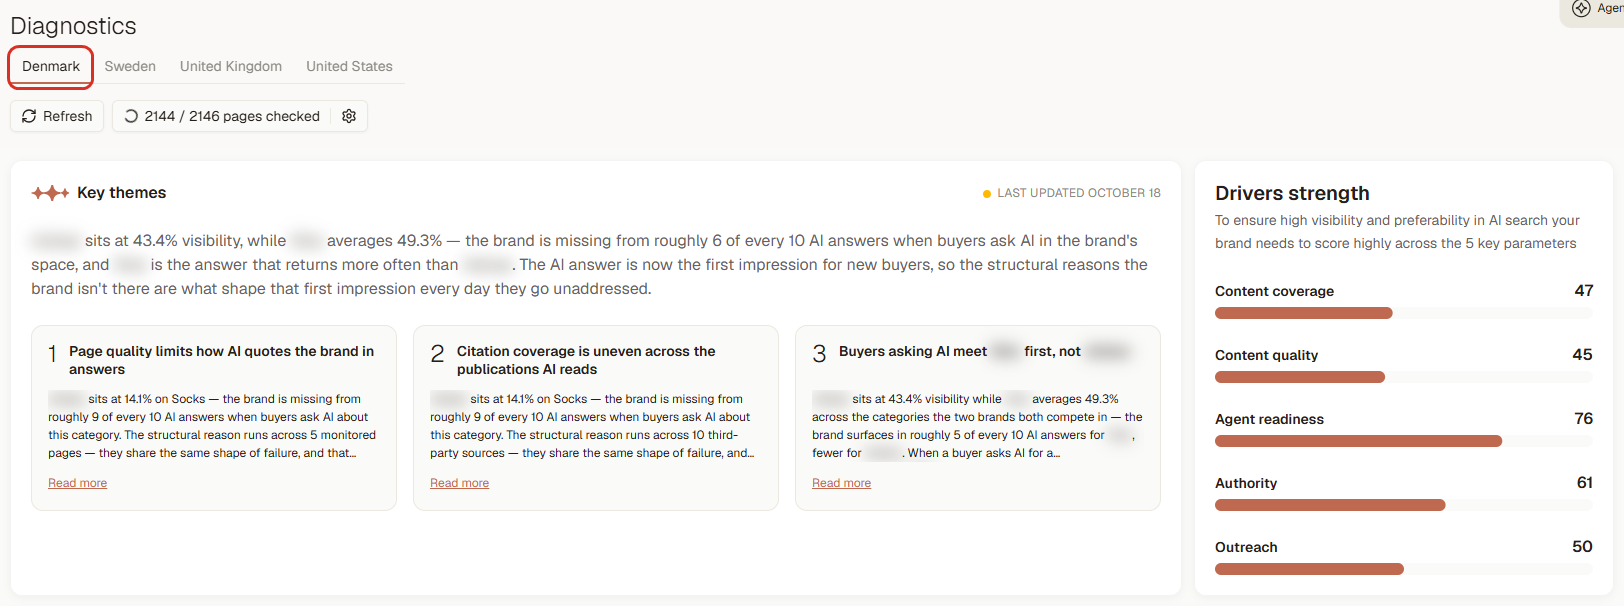
En markedsdiagnose for Danmark: hovedtemaerne bag scoren i klart sprog ved siden af de fem faktorer. Demo-workspace; brandnavne er sløret.
En god diagnose tjekker også dit eget website. I demo-workspacet dækker rapporten Agent readiness 2.144 af 2.146 sider og finder 15 problemer. To af de fire områder, Reachable og Actionable, er markeret som Critical. AI-agenter kan ikke finde ud af, hvordan man køber, fordi købsknappen kun virker via JavaScript. Produkterne mangler identifikatorer som GTIN eller SKU. Og 1.315 sider mangler sidetitel eller beskrivelse. Det er almindelige problemer, og de er lette at overse uden et tjek.
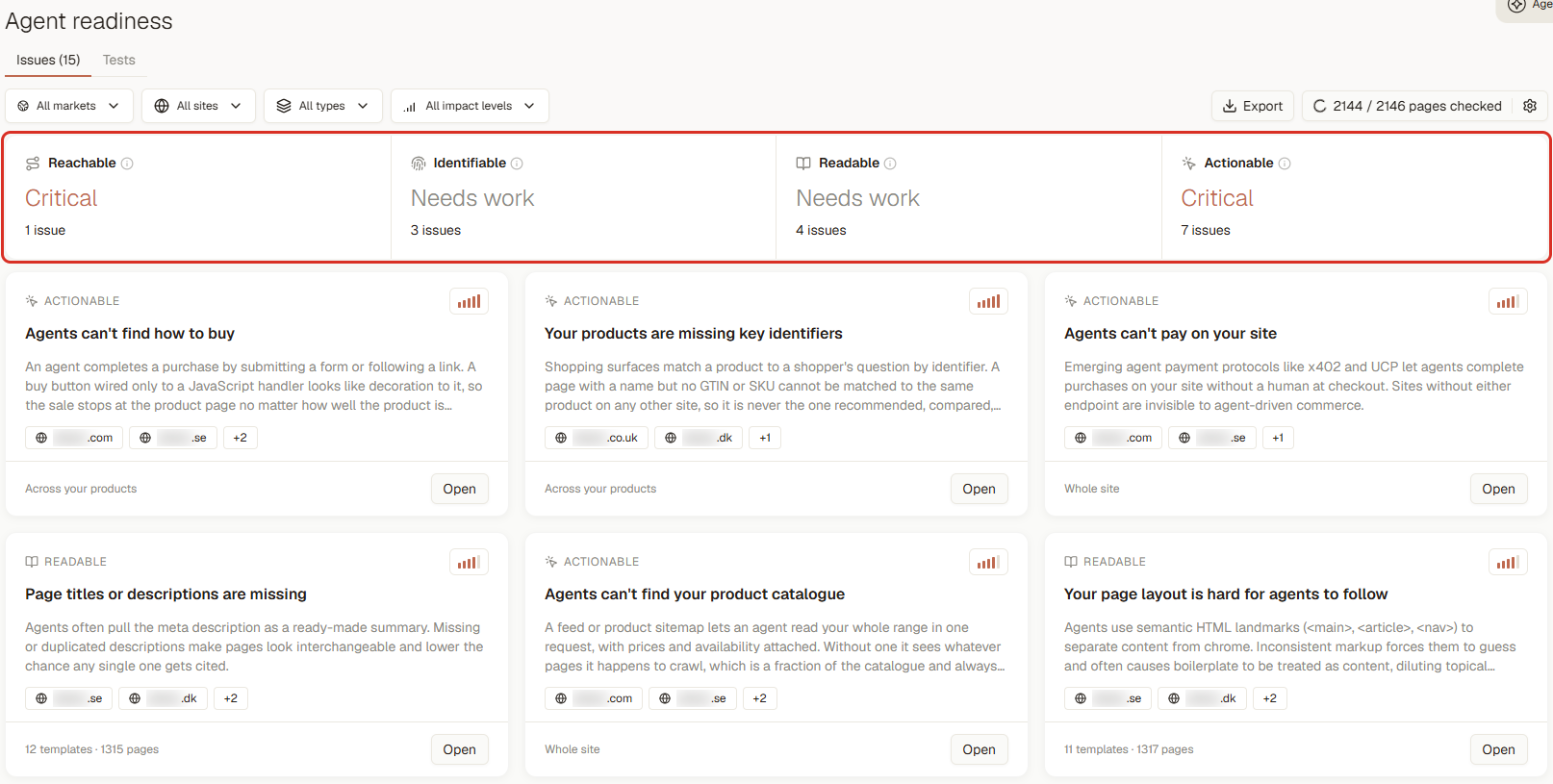
En Agent readiness-rapport, der viser de problemer på sitet, som forhindrer AI-agenter i at nå frem til, læse eller købe på sitet. Demo-workspace; brandnavne er sløret.
Én advarsel: Teknisk adgang er sjældent det største problem. I samlede data fra 60 brands var medianscoren for crawlbarhed 99 ud af 100, og crawlbarhed var ikke den svageste faktor for et eneste af de 54 brands, hvor alle fem faktorer var målt. For 42 af dem var autoritet eller indholdskvalitet flaskehalsen. Hvis en leverandør lægger ud med ”vi fikser din crawlbarhed”, så spørg, hvad den ellers finder.
8. Kildehenvisninger og kilder. AI-svar læner sig op ad de sider, de henviser til. Du skal kunne se, hvilke sider der henvises til, om de er egne kilder eller eksterne kilder, og hvilke eksterne sider der nævner dine konkurrenter, men ikke dig. Den liste er din outreach-plan.
9. Anbefalet eller bare nævnt. At stå på en liste og at blive anbefalet er to forskellige resultater, og forskellen er stor. I samlede 3RD-data fra 60 brands og 494.000 tjekkede svar blev medianbrandet nævnt i 19,8 % af svarene, men kun anbefalet frem for alternativerne i 0,2 %. Det svarer til omkring én anbefaling for hver 65 omtaler, og en fjerdedel af brandene (15 af 60) blev slet ikke anbefalet i løbet af måneden.
3RD definerer det strengt: Svaret skal vælge dig frem for alternativerne, og det tæller ikke at stå først på listen. Stil hver leverandør to spørgsmål: Skelner værktøjet mellem nævnt og anbefalet? Og er spørgsmål med dit brandnavn holdt ude af målingen? Et spørgsmål, der nævner dit brand, puster tallet op.
Kan dit team omsætte det til handling?
10. Fra diagnose til en prioriteret plan. Spørg, hvad du får efter diagnosen. En liste med generelle råd (”tilføj FAQ-schema”) er ikke en plan. En plan kobler hver opgave til et mål, en gruppe prompts og en forventet effekt, så det mest værdifulde arbejde kommer først.
11. Hvem der klarer arbejdet, og hvad der er automatiseret. Platformene falder i tre grupper:
- Kun overvågning: Du får data, og dit team eller bureau klarer resten.
- Udkast med godkendelse: Platformen skriver udkast til sider, briefs eller outreach, og et menneske tjekker og publicerer.
- Selvstændig udførelse: Agenter udfører opgaverne for dig og publicerer nogle gange direkte.
Ingen af dem passer til alle. Et team med en stærk indholdsfunktion vil måske kun have dataene. Et marketingteam på to personer har måske brug for udkast. En virksomhed i en reguleret branche kan have krav om, at et menneske godkender hver ændring. Beslut, hvad du har brug for, før demoen.
12. Måling af effekt. Når dit team har lanceret en ændring, kan du så se, om den virkede? Kig efter en før-og-efter-måling for netop de prompts, arbejdet var rettet mod. Den skal holdes op mod prompts, du ikke har rørt, og holdes adskilt fra det estimat, der blev lavet på forhånd.
Kontrolgruppen er vigtig, fordi en enkelt før-og-efter-måling næsten er plat eller krone. I samlede 3RD-data så vi på 117 afsluttede opgaver, hvor synligheden på de prompts, opgaven var rettet mod, blev sammenlignet med en kontrolgruppe af samme brands urørte prompts. 29 % steg mere end 5 procentpoint i forhold til kontrolgruppen, 26 % faldt mere end 5, og 44 % holdt sig inden for 5 procentpoint. Det betyder ikke, at arbejdet ikke virker. Men en platform uden kontrolgruppe kan ikke fortælle dig, hvilket af resultaterne du fik. Regn med dage til uger, fra du publicerer, til du kan måle en ændring, for AI-modellerne crawler og lærer igen i deres eget tempo.
Passer platformen til din virksomhed?
13. Rapportering og adgang til data. Din CMO vil have én side, ikke en rundvisning i et dashboard. Tjek, om der er faste rapporter, CSV-eksport, et API og en connector til jeres BI-værktøj. Er trafik fra AI vigtig for dig, så tjek, hvilke analyseværktøjer der kan kobles på (fx GA4 eller Adobe Analytics), og i hvilket abonnement.
Trafik fra AI er værd at spørge til, for klik kan komme fra kildehenvisninger såvel som fra omtaler. Spørg, hvad det kræver at sætte op. I 3RD er det ét trin: Du forbinder din GA4-property. Indtil da viser trafikvisningen en side, hvor du kan forbinde. Når den er forbundet, står sessioner og brugertal fra AI-assistenter ved siden af din synlighed i det samme dashboard.
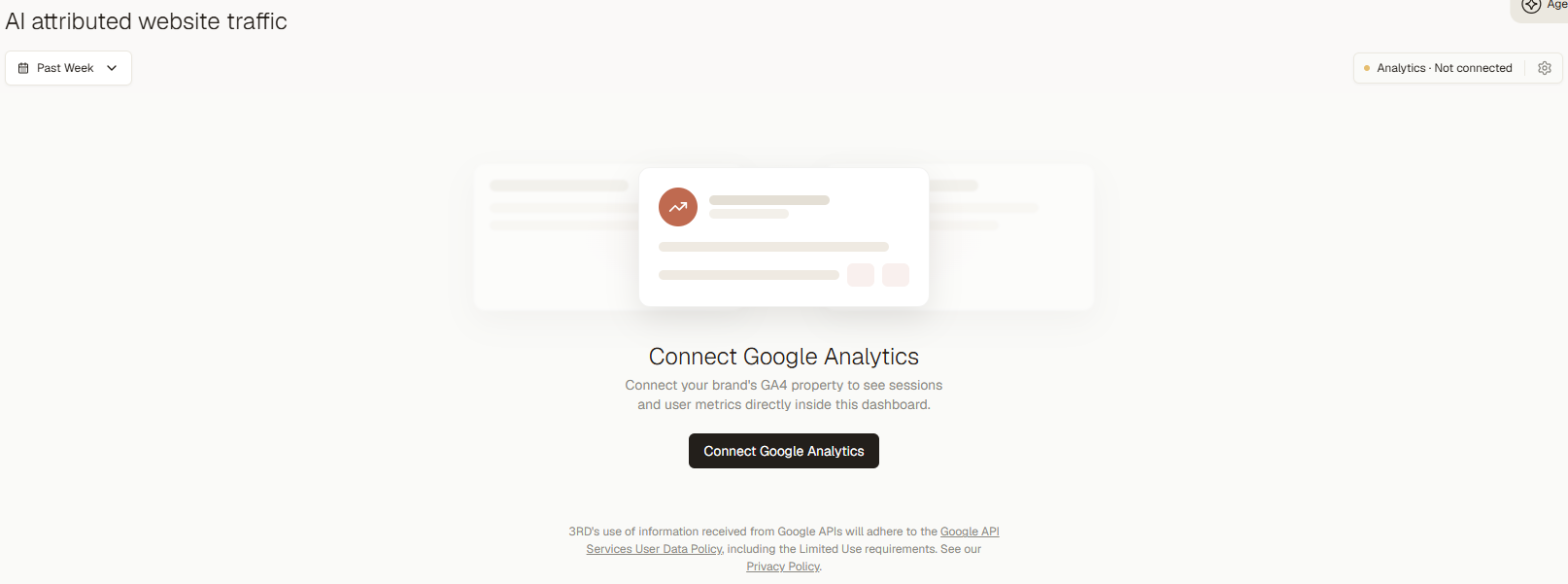
Før GA4 er forbundet, beder trafikvisningen om din property. Derefter vises sessioner fra AI ved siden af synligheden. Demo-workspace; brandnavne er sløret.
14. Sikkerhed, dataplacering og kommercielle vilkår. Spørg, hvor data bliver opbevaret, hvilke AI-udbydere der behandler dem, og om dine data bliver brugt til at træne offentlige modeller. Spørg også, hvilke certificeringer leverandøren har i dag – og hvilke den kun ”arbejder hen imod”. Spørg, om single sign-on (SSO) er muligt, og i hvilket abonnement. Tjek til sidst, om priserne er offentlige, og om en prøveperiode kan køre på dine egne prompts.
Spørgsmål, du skal stille til hver demo
Brug dem ordret. En stærk leverandør svarer på hvert af dem på under et minut.
- ”Vis mig et svar om en af vores konkurrenter og de kilder, AI henviste til.”
- ”Hvordan indsamler I svar fra ChatGPT: via API, fra brugerfladen eller begge dele?”
- ”Hvis jeg måler 30 spørgsmål på 3 modeller på 2 markeder, hvor mange prompts er det så i jeres prismodel?”
- ”Hvor ofte bliver hvert spørgsmål kørt, og hvordan viser I mig, at en ændring er reel og ikke støj?”
- ”Hvorfor vinder vores største konkurrent dette spørgsmål? Vis mig dokumentationen.”
- ”Skelner I mellem at blive nævnt og at blive anbefalet?”
- ”Hvad sker der helt konkret efter diagnosen? Hvem skriver siden, og hvem publicerer den?”
- ”Når vi har lanceret en rettelse, hvor kan jeg så se, om den rykkede tallet i forhold til de prompts, vi ikke rørte?”
- ”Kan jeg eksportere de rå svar og kildehenvisninger?”
- ”Hvor bliver vores data opbevaret, og hvilke certificeringer har I i dag?”
- ”Kan vi få en prøveperiode på vores egne spørgsmål og markeder, før vi skriver under?”
Advarselstegn
- Én samlet global score uden filtre. Det samme brand kan ligge på 50 % i én model og 30 % i en anden på de samme spørgsmål. Et gennemsnit skjuler den model, hvor du taber.
- ”Søgevolumen” for prompts. Ingen platform har reel søgevolumen for AI-prompts. En efterspørgselsscore er altid et estimat, og leverandøren bør forklare, hvordan den er bygget.
- Råd, der kunne passe på enhver virksomhed. Nævner anbefalingerne ikke dine konkurrenter, dine sider og de relevante kilder, er de ikke skrevet til dig.
- Ingen adgang til svarene. Viser leverandøren kun grafer, kan du ikke efterprøve noget.
- Før-og-efter-”beviser” uden kontrolgruppe. Som opgavedataene ovenfor viser, går en rå før-og-efter-måling op omtrent lige så tit, som den går ned.
- Løfter om omsætning. Ingen platform kan i dag koble organisk AI-synlighed til omsætning, for de fleste AI-svar fører ikke til et klik. En leverandør, der lover det, gætter.
- En demo, der kun bruger et eksempelbrand. Bed om at se din egen kategori, eller tag en prøveperiode.
En skabelon til vurdering, som du kan kopiere
Vægt hvert kriterium efter din situation, giv hver leverandør 1–5 point, og gang op. Vægtene herunder passer til et mellemstort marketingteam, der sælger på flere europæiske markeder. Tilpas dem, så de passer til dig.
|
Kriterium |
Vægt (1–3) |
Leverandør A |
Leverandør B |
Leverandør C |
|---|---|---|---|---|
|
1. Metode til indsamling af svar |
2 |
|
|
|
|
2. Modeller dækket, og om de kan skiftes |
2 |
|
|
|
|
3. Markeder og sprog |
3 |
|
|
|
|
4. Klar optælling af prompts |
2 |
|
|
|
|
5. Kørselsfrekvens og udsving |
2 |
|
|
|
|
6. Sporbarhed til svarene |
3 |
|
|
|
|
7. Diagnose af, hvorfor du taber |
3 |
|
|
|
|
8. Kildehenvisninger, egne og eksterne kilder |
2 |
|
|
|
|
9. Anbefalet eller nævnt |
2 |
|
|
|
|
10. Prioriteret plan |
3 |
|
|
|
|
11. Hvem klarer arbejdet |
3 |
|
|
|
|
12. Målt effekt med kontrolgruppe |
2 |
|
|
|
|
13. Rapportering og adgang til data |
2 |
|
|
|
|
14. Sikkerhed og vilkår |
2 |
|
|
|
|
Vægtet total |
|
|
|
|
En pilot på to uger, der afgør valget
To uger er minimum. Når det månedlige udsving i median er 12,5 procentpoint, kan et par dages data pege i begge retninger.
- Dag 1: Læg de samme 20–40 kundespørgsmål ind i hver platform på din shortlist – på de samme markeder og de samme modeller.
- Dag 2–7: Reager ikke på de daglige tal. Læs svarene, og tjek, at platformene genkender dit brand og dine konkurrenter korrekt. Er dit brandnavn kort eller også et almindeligt ord, så tjek det grundigt. Ellers kan sider, der ikke har noget med dig at gøre, blive talt med som omtaler.
- Dag 8: Bed hver platform om de tre vigtigste grunde til, at en konkurrent slår dig, med dokumentation.
- Dag 9–14: Følg én anbefaling fra hver platform, og notér, hvor lang tid det tog dit team.
- Dag 14: Vurder hver leverandør med skabelonen ovenfor. Som regel er det de timer, dit team sparer, der afgør det.
Shortlisten: otte platforme til AI-synlighed sammenlignet
Oplysningerne kommer fra leverandørernes egne pris- eller produktsider, tjekket 18.–19. oktober 2026. Hvor en leverandør ikke oplyser noget, står det i tabellen. Priserne ændrer sig tit, så tjek dem, før du køber. Vil du se de samme værktøjer opdelt efter type af team, så læs alternativer til Profound i 2026.
|
Platform |
AI-modeller (offentligt oplyst) |
Startpris (offentligt oplyst) |
Markeder |
Ud over overvågning |
Prøveperiode |
|---|---|---|---|---|---|
|
Profound |
Op til 9 på Enterprise; 3 i prøveperioden |
Ikke oplyst (Enterprise efter aftale) |
1 region og 1 sprog i prøveperioden; efter aftale på Enterprise |
Agenter skriver udkast og publicerer i dit CMS efter godkendelse |
Gratis: 50 prompts, dagligt i 7 dage |
|
Peec AI |
3 pr. abonnement, flere mod betaling |
85 €, 205 € og 425 € om måneden for 50, 150 og 350 prompts (tjekket 18. okt.) |
Flere lande fra Pro |
Anbefalede handlinger, gap-analyse, indholdsoptimering |
Ikke oplyst på prissiden |
|
Otterly |
4 inkluderet (ChatGPT, AI Overviews, Perplexity, Copilot); Gemini, AI Mode og Claude som tilkøb |
Fra 29 $ om måneden (15 prompts) til 489 $ (400 prompts) |
Understøtter flere lande |
Anbefalinger og GEO-audits af URL'er |
Ikke oplyst på prissiden |
|
Semrush AI Visibility Toolkit |
Omtaler fra ChatGPT, Google AI, Gemini og Perplexity |
99 $ om måneden pr. domæne ved årlig betaling; 25 målte prompts |
Ikke oplyst på prissiden |
AI Visibility Score, share of voice, sentiment og en site-audit til AI-søgning i Semrush-pakken |
7 dages Semrush-prøveperiode; ikke oplyst for toolkittet |
|
Scrunch |
ChatGPT, Claude, Gemini, Perplexity, AI Mode, AI Overviews, Meta |
300 $ om måneden uden binding (250 $ ved årlig betaling), 350 egne prompts |
Ikke oplyst |
Audits af sider; AXP, en AI-venlig version af dit website |
7 dage, intet kort |
|
AthenaHQ |
5 i gratisversionen; 11 på Starter |
Gratisversion (300 credits); Starter 295 $ om måneden (3.600 credits) |
Én region og ét sprog på Starter; flere regioner på Enterprise |
Agent til indholdsoptimering, on-page- og off-page-handlinger |
Gratisversion |
|
KIME |
2 (Explorer), 3 (Core), alle på Enterprise |
99 € om måneden (50 prompts); 399 € (200 prompts) |
Ubegrænset antal lande og sprog |
AWX-agenter udfører opgaver for dig (10 eller 30 om måneden) |
7 dage |
|
3RD |
Op til 2, 3 eller 4 afhængigt af abonnement; op til 13 på Enterprise |
99 € om måneden (40 prompts); 299 € (100); 499 € (300); 84 €, 254 € og 424 € ved årlig betaling |
1 marked på Starter; alle markeder fra Pro; et marked er ét land på ét sprog |
Diagnose af, hvorfor AI vælger en konkurrent, Playbooks med prioriterede opgaver, og 3RD Agent skriver udkast, som du godkender |
7 dage, intet kort |
Hvem passer de hver især til?
- Profound passer til store virksomheder, der vil have bred dækning af AI-motorer og en komplet pakke af arbejdsgange, og som kan købe gennem en salgsproces. Priserne er ikke offentlige, så sæt tid af til en forhandling.
- Peec AI passer til teams, der vil have enkel og billig måling med flere modeller i hvert abonnement. Du får flere svar pr. euro end hos de fleste platforme på listen.
- Otterly passer til små teams og marketingfolk, der arbejder alene, og som vil have den laveste startpris med GEO-audits inkluderet.
- Semrush AI Visibility Toolkit passer til teams, der allerede lever i Semrush. Med 25 målte prompts er mængden dog lille.
- Scrunch passer til teams, der vil måle mange prompts og have en version af deres website rettet mod AI-agenter.
- AthenaHQ passer til teams, der vil starte gratis og prøve mange modeller via et system med credits.
- KIME passer til teams, der vil lade agenter udføre opgaver, uden at et menneske skriver udkast til hver enkelt.
- 3RD passer til marketingteams, der vil vide, hvorfor AI vælger en konkurrent, og have en prioriteret plan med udkast, som teamet selv tjekker, før noget går live. 3RD måler hvert land-sprog-par som et marked for sig. Det er vigtigt for europæiske brands, der sælger på flere sprog.
Eksempel: Sådan vurderer du 3RD med tjeklisten
Sådan kan du teste 3RD ud fra kriterierne i løbet af den syv dage lange prøveperiode. Gør det samme med alle platforme på din shortlist.
- Læg dine spørgsmål og markeder ind. Tilføj dine 20 kundespørgsmål, giv dem niveauet Must-win, Core eller Foundational, og vælg dit marked. Forbind Google Search Console, så får du forslag til spørgsmål ud fra de søgninger, du allerede er synlig på. (Kriterium 3 og 4.)
- Læs svarene – ikke kun scoren. Åbn Conversations, så ser du hvert AI-svar, hvor dit brand optræder, og hvilke kilder der blev henvist til. Hver score viser sit grundlag, fx ”4.051 omtaler i 9.105 svar”. (Kriterium 5 og 6.)
- Find ud af, hvorfor du taber. Åbn Diagnose. Den sammenligner dig med de konkurrenter, du måler, og kobler hvert fund til dokumentation – fx en konkurrents sammenligningsside, der bliver henvist til i de fleste svar, og som du ikke har noget tilsvarende til. (Kriterium 7 og 8.)
- Omsæt det til en plan. Opret en Playbook med ét mål. I demo-workspacet hedder en dansk Playbook ”Increase visibility score to 27% for active lifestyle - Must-Win prompts”, og udgangspunktet er 11 %. 3RD laver opgaver med en forventet effekt, så de opgaver, der flytter mest, ligger øverst. (Kriterium 10.)
- Bed 3RD Agent om at tage næste skridt. Spørg ”Hvad skal vi rette først?”, og bed den derefter skrive et udkast til siden. Hver ændring vises som et kort, du kan redigere, godkende eller afvise. Intet går live, før du har godkendt det, og det er stadig dig, der publicerer. (Kriterium 11.)
- Tjek, hvordan effekten bliver målt. Hver afsluttet opgave viser, hvad der faktisk har rykket sig på de prompts, den var rettet mod, i forhold til brandets øvrige prompts – holdt adskilt fra den forventede effekt. (Kriterium 12.)
Begrænsningerne er de her: 3RD's billigste abonnement dækker ét marked og to AI-modeller. Trafik fra AI via GA4 eller Adobe Analytics følger med Growth. 3RD er endnu ikke SOC 2- eller ISO 27001-certificeret. Kontrollerne følger de to standarder, og data opbevares i EU-regioner. SAML single sign-on kan sættes op for Enterprise-kunder efter aftale. Se Sikkerhed.
Det overser de fleste sammenligninger: Lederen skifter fra model til model
På tværs af 60 kundebrands i 3RD var den mest synlige konkurrent et andet brand på forskellige assistenter for 62 % af dem – med de samme prompts.
Demo-workspacet viser, hvor meget ét brands egne tal kan skille sig ad fra assistent til assistent. Synligheden er fra den seneste uge. Anbefalingsraten kommer fra 3RD Agents svar i det samme workspace.
|
AI-model |
Demobrandets synlighed |
Demobrandets anbefalingsrate |
|---|---|---|
|
ChatGPT |
omkring 60 % |
ikke oplyst |
|
Claude |
omkring 52 % |
3,8 % |
|
DeepSeek |
omkring 56 % |
3,7 % |
|
Gemini |
omkring 56 % |
0,3 % |
|
Google AI Mode |
omkring 20 % |
0,3 % |
Samme spørgsmål, meget forskellige tal. Gemini nævner brandet tit, men anbefaler det næsten aldrig. Google AI Mode gør ingen af delene. Det giver to pointer, uanset hvilken platform du køber:
- Stol ikke på én samlet score. Den skjuler den model, hvor du taber.
- Mål de modeller, dine kunder bruger. En platform med færre modeller, der matcher dine kunder, er bedre end en med mange, der ikke gør.
Om dataene
Skærmbillederne og eksemplerne (Overblik, Diagnose, graf pr. model, Agent readiness, skærmen til at forbinde trafikdata og tabellen pr. model) kommer fra et demo-workspace for et sportstøjsbrand, hvor brandnavnene er sløret. De er ikke kunderesultater. Kundedataene er samlede og anonymiserede 3RD-data fra 19. september til 18. oktober 2026. Daglige udsving bygger på 111 brands og 732.000 AI-svar. Uenighed mellem modeller, anbefalet i forhold til nævnt og scorer for faktorerne bygger på op til 60 brands, højst tre pr. kundeorganisation. Opgavernes effekt bygger på 117 afsluttede opgaver med kontrolgruppe fordelt på 44 brands (februar til oktober 2026). Datagrundlaget har en overvægt af nordiske brands. Ingen brands, domæner eller prompts er nævnt. Der er tale om observationsdata, ikke et kontrolleret eksperiment.
FAQ
Hvad er forskellen på en platform til AI-synlighed og et GEO-værktøj? Det er stort set den samme kategori. ”AI-synlighed” beskriver det, der bliver målt: hvor meget du fylder i AI-svar. GEO (generative engine optimization) beskriver arbejdet med at forbedre det. De bedste platforme gør begge dele: De måler, forklarer og hjælper dig med at handle.
Hvor mange prompts har vi brug for? Start med 20–40 værdifulde kundespørgsmål pr. marked. Det er vigtigere at dække dine Must-win-spørgsmål end at have mange, men meget små sæt giver meget støj. I vores data svingede brands med færre end ca. 100 svar om dagen omtrent dobbelt så meget fra dag til dag som brands med 230 eller flere. Gang op med modeller og markeder, så ser du det reelle forbrug i hver leverandørs prismodel.
Hvilke AI-modeller skal vi måle? Dem, dine kunder bruger. For de fleste B2B- og B2C-brands betyder det ChatGPT plus Google AI Overviews eller Gemini og derefter Copilot, Perplexity eller Claude afhængigt af målgruppen. Resultaterne varierer meget fra model til model: I vores data var der 16 procentpoint mellem medianbrandets bedste og dårligste assistent.
Kan nogen platform garantere, at vi kommer med i ChatGPT? Nej. AI-modellerne vælger selv svarene og ændrer dem over tid. En platform kan vise dig, hvorfor du ikke bliver valgt, og hjælpe dig med at rette årsagerne: manglende sider, svag omtale på eksterne sites og sider, AI ikke kan læse.
Hvor længe går der, før vi ser resultater? Regn med, at der går fra få dage til nogle uger, fra du publicerer en ændring, til den kan ses i AI-svarene. AI-modellerne crawler og lærer nemlig igen i deres eget tempo. Følg trenden over flere uger frem for det daglige tal, og sammenlign de prompts, du har arbejdet med, med dem, du ikke har rørt.
Næste skridt
Skriv dine 20 kundespørgsmål ned i dag, og prøv 3RD gratis med dem. Eller sammenlign 3RD med andre platforme.
Head of Marketing