AI-søgning
Sådan omsætter du AI-synlighedsdata til en prioriteret ugeplan
En trin-for-trin-metode til at prioritere dine huller i AI-synlighed, sende hver opgave til det rigtige team og løse 3–5 opgaver om ugen mod ét mål.
 Magnus Windeløv19. okt. 2026 · 18 min. læsning
Indhold
Vælg ét mål, og skriv alle de prompts ned, hvor du mangler. Find årsagen til hvert hul, og prioriter opgaverne efter kommerciel værdi i forhold til indsats. Løs derefter tre til fem opgaver om ugen.
De fleste teams, der måler deres AI-synlighed, har allerede dataene. Det, de mangler, er skridtet fra dashboardet til selve arbejdet. En synlighedsscore fortæller dig, at du ikke bliver nævnt. Den fortæller ikke, hvad du skal gøre på mandag, hvem der skal gøre det, eller hvad der kommer først.
Tag et demo-workspace som eksempel. Et sportstøjsbrand bliver fulgt i forhold til seks konkurrenter i Danmark, Sverige, Storbritannien og USA – på syv AI-modeller og 207 prompts. I den seneste uge blev brandet nævnt i 44,5 % af AI-svarene og lå nr. 2 ud af syv brands. Alene i kolonnen ”Skal gøres” ligger der 77 opgaver. Uden en metode til at vælge de næste tre er tavlen bare støj.
Den metode får du her. Du kan bruge den i et regneark. Undervejs viser jeg, hvordan hvert trin ser ud i 3RD med det samme demo-workspace – også de dele, softwaren ikke klarer for dig.
Det korte svar
En brugbar plan for AI-synlighed består af fem dele:
- Ét mål. Et tal, du vil nå for en bestemt gruppe prompts på ét marked inden en bestemt dato.
- En liste over huller. Alle de prompts i gruppen, hvor du mangler, og hvem der bliver nævnt i stedet.
- En årsag til hvert hul. Siden mangler, siden er for svag, crawleren er blokeret, der er ingen omtale fra andre, eller AI blander dig sammen med nogen.
- En prioriteret opgaveliste. Hver opgave har en ansvarlig, en klar definition af, hvornår den er færdig, og en score.
- En fast ugerytme. Hver uge bliver en lille portion opgaver løst, og du måler på udviklingen over tid.
Sådan arbejder de fleste teams i dag: Nogen tjekker ChatGPT i hånden, tager et skærmbillede af et svar og skriver ”lav mere indhold om X” på en liste med gode råd. Men en liste med gode råd er ikke en plan. Den har ingen rækkefølge og ingen ansvarlig, og du kan ikke se, om den virkede.
Resultatet er et team, der godt ved, at det skal gøre noget, men ikke ved, hvor det skal begynde. Resten af guiden giver dig startstedet.
Det skal du have på plads først
Sørg for, at disse fem ting er på plads, før du bygger planen.
|
Det skal du bruge |
Hvorfor |
Minimum |
|---|---|---|
|
Et sæt prompts, du følger |
Planen kan kun rette det, du måler |
10–15 prompts, du går op i, formuleret som dine kunder spørger |
|
Prompts inddelt efter værdi |
Et hul på et købsspørgsmål betyder mere end et hul på en definition |
Must-win, Core og Foundational |
|
En baseline over tid |
Ét enkelt tjek er støj |
Mindst to ugers svar, dagligt eller næsten dagligt |
|
Data om kildehenvisninger |
De viser, hvilke kilder AI stoler på, og hvilket team der skal lukke hullet |
De URL'er, AI henviser til, delt op i egne og eksterne kilder |
|
Én ansvarlig |
Når alle har ansvaret, bliver intet færdigt |
Én navngiven person plus hjælpere fra indhold, web og PR |
To af dem bliver oftest sprunget over.
Inddelingen. I 3RD's metode er en Must-win-prompt et spørgsmål, der bliver stillet tæt på en beslutning, fx ”Hvilken platform skal en mellemstor bank bruge til X?”. En Core-prompt former shortlisten, og en Foundational-prompt bygger AI's forståelse af din kategori. De anbefalede mål for synlighed er 75 %, 50 % og 35 %. Uden inddelingen ser alle huller lige vigtige ud, og planen fyldes med nemme opgaver, der ikke flytter meget.
Baselinen. AI-svar svinger langt mere fra dag til dag, end de fleste teams regner med. Vi har set på 111 brands, som vi følger, og 732.000 AI-svar fra 19. september til 18. oktober 2026. For medianbrandet var der 12,5 procentpoint mellem månedens bedste og dårligste dag – uden at der var ændret i brandets prompts. For 7 ud af 10 brands lå mindst én enkelt dag mere end 5 procentpoint fra brandets gennemsnit over 30 dage. Bygger du planen på ét skærmbillede, jagter du støj.
Jo færre prompts, jo større udsving. Brands med færre end ca. 100 svar om dagen svingede omtrent dobbelt så meget som brands med 230 eller flere. En god tommelfingerregel: Jo færre prompts du følger, jo længere baseline har du brug for.
Trin 1: Sæt ét mål
Skriv målet som én sætning med fem dele: et nøgletal, en gruppe prompts, et marked, AI-modellerne og en dato.
Øg synligheden fra 11 % til 27 % på Must-win-prompts om lønsystemer i USA på ChatGPT og Gemini inden udgangen af 1. kvartal.
Hold målet smalt. Et mål som ”øg vores AI-synlighed” kan du ikke prioritere ud fra, og det skjuler fremskridtet. Et smalt mål på kommercielle prompts viser hurtigere bevægelse, og du lærer, hvad der virker for netop dit brand.
Gode første mål:
- Must-win-prompts på dit største marked
- Ét emne, hvor en enkelt konkurrent dominerer
- Den AI-model, dine kunder bruger mest
I 3RD starter en Playbook netop med den ene sætning.
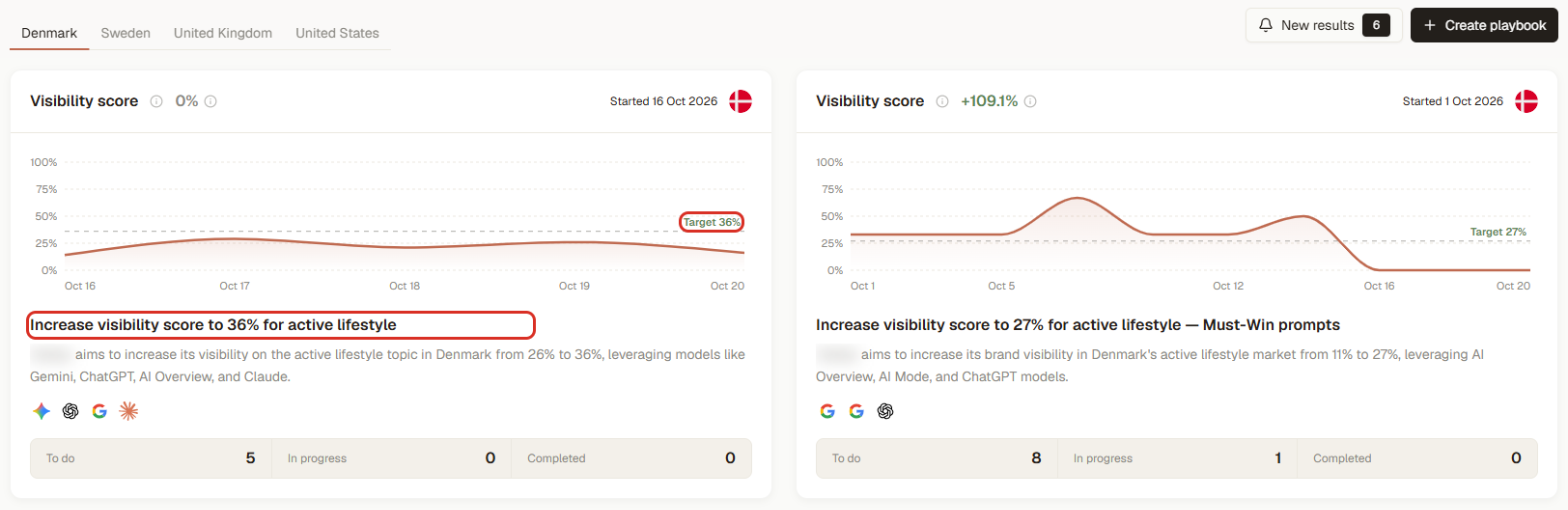
To Playbooks for Danmark, bygget op om hvert sit mål: fra 26 % til 36 % for aktiv livsstil og fra 11 % til 27 % for emnets Must-win-prompts. Demo-workspace; brandnavne er sløret.
I demo-workspacet handler de danske Playbooks om ét emne: aktiv livsstil. Det første mål lyder ”Øg synlighedsscoren til 36 % for aktiv livsstil”. Det går fra 26 % til 36 % på Gemini, ChatGPT, Google AI Overviews og Claude, og der er fem opgaver, der skal gøres. Det andet mål er smallere og gælder kun Must-win-prompts inden for samme emne – fra 11 % til 27 %. Begge følger sætningen med de fem dele.
Trin 2: Lav listen over huller
Skriv ned, hvad AI svarer i dag på hver prompt i målet. Brug én række pr. prompt.
|
Prompt |
Niveau |
Bliver du nævnt? |
Hvem bliver nævnt |
Vigtigste kilder |
Din side om emnet |
|---|---|---|---|---|---|
|
Bedste lønsystem til en virksomhed med 50 ansatte |
Must-win |
0 af 4 modeller |
Konkurrent A, Konkurrent B |
Liste på g2.com, Konkurrent A's blog |
Ingen |
|
Lønsystem med datahosting i EU |
Must-win |
1 af 4 modeller |
Konkurrent B |
Konkurrent B's prisside |
/security, tynd |
|
Hvad er indlejret lønadministration |
Foundational |
2 af 4 modeller |
Konkurrent A |
Wikipedia, brancheblog |
/blog/embedded-payroll |
Læs selve svarene, ikke kun scoren. Teksten i svaret viser, hvordan AI beskriver dig og dine konkurrenter. Kilderne viser, hvor AI har lært det.
Trin 3: Find årsagen til hvert hul
Alle huller har en årsag, og årsagen afgør både opgaven og hvilket team der skal løse den. Fem årsager dækker næsten alle tilfælde.
|
Det ser du |
Sandsynlig årsag |
Type opgave |
Hvem løser den |
|---|---|---|---|
|
Du har ingen side, der besvarer prompten |
Indholdsdækning |
Skriv en ny side |
Indhold |
|
Du har en side, men AI henviser aldrig til den |
Indholdskvalitet |
Byg siden om |
Indhold |
|
AI henviser aldrig til dine sider, heller ikke de gode |
Crawlbarhed |
Fjern blokeringen af AI-crawlere, ret visningen af siderne, og tilføj strukturerede data |
Web eller SEO |
|
Svarene henviser til lister hos andre, hvor du ikke er med |
Autoritet og outreach |
Kontakt kilden, og opdater din profil på anmeldelsessider |
PR eller kommunikation |
|
AI blander dig sammen med en anden virksomhed |
Identitet (entitet) |
Tilføj organisationsdata og den samme beskrivelse af virksomheden overalt |
Web og indhold |
Regn med, at årsagen ligger i indholdet eller autoriteten og ikke i det tekniske. Blandt 60 brands, vi følger, var medianscoren for crawlbarhed 99 ud af 100. Hos 42 af de 54 brands, hvor alle fem faktorer blev målt, var autoritet eller indholdskvalitet den svageste faktor. Crawlbarhed var den svageste hos ingen af dem.
Demo-workspacet passer ind i mønstret. I Danmark får crawlbarhed 76, autoritet 61, outreach 50, indholdsdækning 47 og indholdskvalitet 45. Det er indholdet, der holder brandet tilbage, og ikke det tekniske.
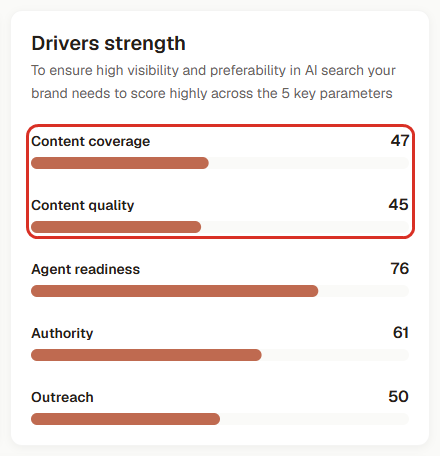
De fem faktorer for Danmark. Indholdsdækning og indholdskvalitet ligger lavest. Demo-workspace; brandnavne er sløret.
Fordelingen af kildehenvisninger er din genvej. Ligger kilderne på dit eget domæne (egne kilder), skal du rette i indholdet. Ligger de på andres sites (eksterne kilder), er løsningen outreach. På den måde fungerer kildehenvisningerne som et organisationsdiagram: De viser, hvilket team der har ansvaret for hvert hul.
Sæt god tid af til outreach. Vi har set på 100 brands og 5,9 mio. kildehenvisninger. For medianbrandet udgjorde dets eget website kun 6,8 % af de kilder, AI henviste til i kategorien. For 41 af brandsene henviste AI oftere til konkurrenternes websites end til brandets eget. Består din plan kun af indhold, lader du størstedelen af hullet stå åbent.
I 3RD laver Diagnose den gennemgang emne for emne.
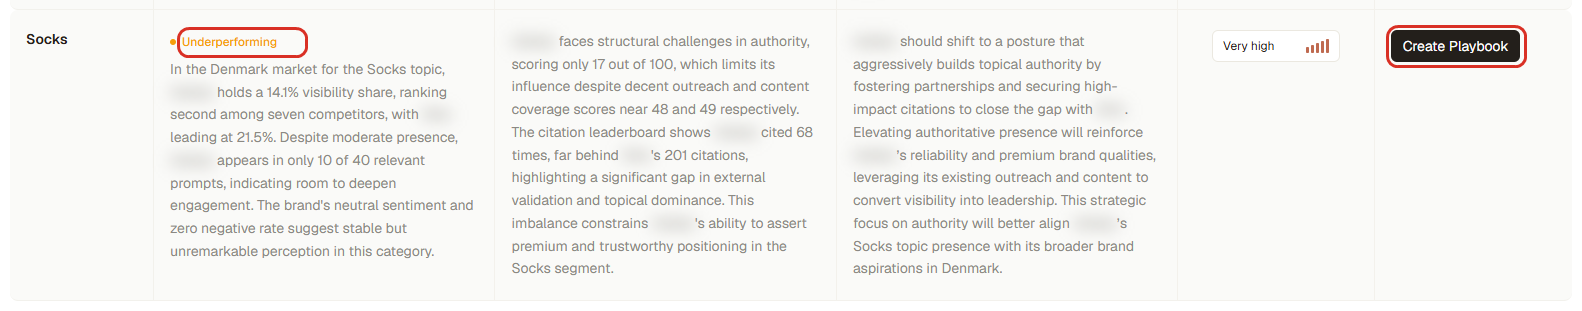
Diagnosen af emnet strømper i Danmark: 14,1 % synlighed i forhold til en førende konkurrent på 21,5 %, problemerne bag tallet, en foreslået tilgang og en Playbook med ét klik. Demo-workspace; brandnavne er sløret.
Trin 4: Gør hver årsag til en opgave med en klar slutning
”Forbedr vores sammenligningsindhold” er ikke en opgave. En opgave nævner prompten, årsagen, trinene og hvornår den er færdig. Brug det samme kort til alle opgaver:
|
Felt |
Eksempel |
|---|---|
|
Titel |
Publicer en sammenligningsside for ”Bedste lønsystem til en virksomhed med 50 ansatte” |
|
Prompts, den sigter efter |
3 Must-win-prompts inden for emnet lønsystemer |
|
Årsag |
Indholdsdækning: Ingen side besvarer spørgsmålet |
|
Dokumentation |
Konkurrent A's sammenligningsside er kilde i de fleste svar |
|
Trin |
1. Brief 2. Udkast 3. Faglig gennemlæsning 4. Publicering 5. Tilføjelse til sitemap |
|
Ansvarlig |
Content marketer |
|
Indsats |
M (en til to dage) |
|
Færdig, når |
Siden er live, kan crawles og er linket fra prissiden |
|
Mål fra |
Publiceringsdatoen |
Linjen ”Færdig, når” er den vigtigste. Den gør en vag hensigt til noget, du kan krydse af om fredagen.
Sådan ser et opgavekort ud i 3RD.
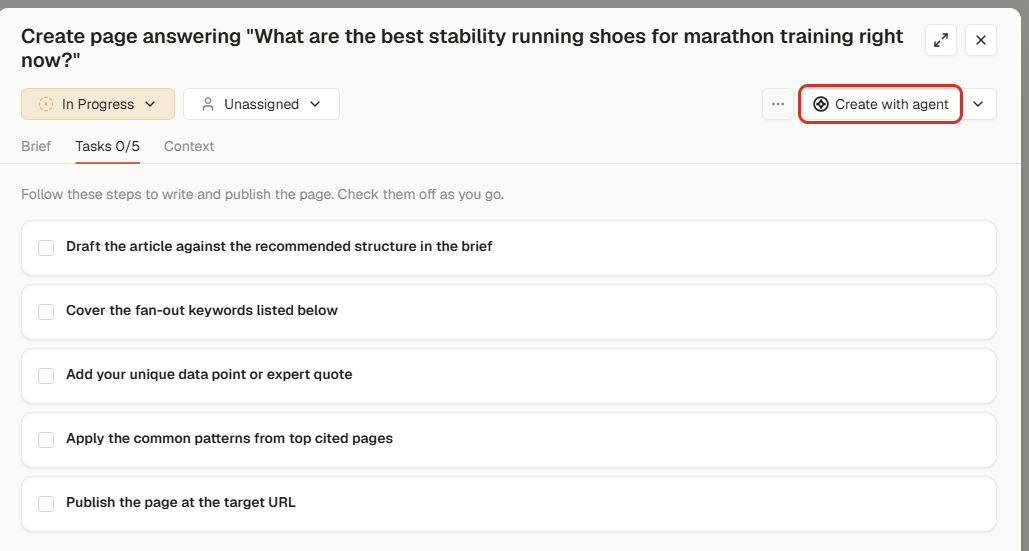
En indholdsopgave med tjekliste i fem trin. Det sidste trin – at publicere på den rigtige URL – er definitionen på, at opgaven er færdig. Demo-workspace; brandnavne er sløret.
En god opgave har også briefen med. Den beskriver den struktur, som de sider, AI allerede henviser til på spørgsmålet, har til fælles.
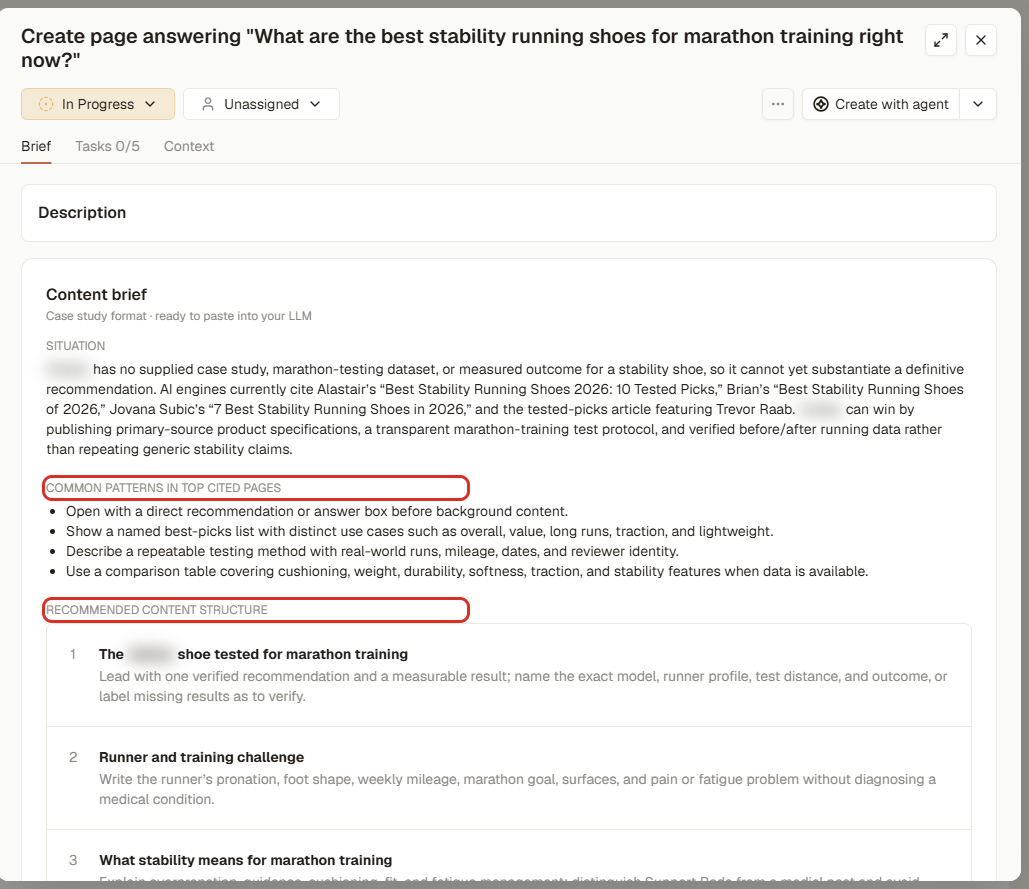
Briefen bag opgaven. AI henviser til fire anmeldelsesartikler om stabilitetsløbesko. Fælles for dem er en boks med et direkte svar, konkrete anbefalinger til hvert formål, en testmetode, der kan gentages, og en sammenligningstabel. Demo-workspace; brandnavne er sløret.
Trin 5: Vurder og prioriter opgaverne
Prioriter opgaverne efter forventet værdi, ikke efter hvor nemme de er. En enkel score er nok:
Prioritet = niveauvægt × antal prompts × hullets størrelse ÷ indsats
- Niveauvægt: Must-win 3, Core 2, Foundational 1
- Antal prompts: hvor mange af målets prompts opgaven påvirker
- Hullets størrelse: 3, hvis du ikke bliver nævnt, 2, hvis du bliver nævnt, men ligger bagud, og 1, hvis du er tæt på
- Indsats: S = 1, M = 2, L = 3
|
Opgave |
Niveau |
Prompts |
Hul |
Indsats |
Score |
|---|---|---|---|---|---|
|
Fjern blokeringen af AI-crawlere på /pricing |
3 |
8 |
2 |
S (1) |
48 |
|
Kom med på listen, der er kilde i 6 Must-win-svar |
3 |
6 |
3 |
M (2) |
27 |
|
Ny sammenligningsside |
3 |
3 |
3 |
M (2) |
13,5 |
|
Omskriv ordbogssiden |
1 |
2 |
1 |
S (1) |
2 |
To mønstre går igen i næsten alle planer.
- En reel teknisk rettelse kommer først, når den findes. Den er lille og påvirker mange prompts på én gang. Men tjek, at problemet er reelt. Som tallene for faktorerne ovenfor viser, er det tekniske sjældent flaskehalsen.
- Outreach til én side, som AI ofte henviser til, slår tit en ny side. Mange svar bygger på de samme få kilder.
Formlen er en tommelfingerregel og ikke en naturlov. Juster vægtene, hvis din forretning vægter et marked eller en model anderledes. Det vigtige er, at teamet prioriterer efter den samme regel hver uge.
Trin 6: Læg opgaverne i rækkefølge
Prioriteringen viser, hvad der er mest værd. Rækkefølgen viser, hvad der skal ske først. Nogle opgaver giver først noget, når andre er løst.
Brug denne rækkefølge:
- Gør dig genkendelig. Hvis AI forveksler dig med en anden virksomhed, virker intet andet. Ret organisationsdataene og beskrivelsen af virksomheden først.
- Gør dig læsbar. Kan AI-crawlere ikke nå eller læse dine sider, er nyt indhold spildt. Ret adgangen og strukturen som det næste.
- Vær svaret på dine egne sider. Publicer nye sider, og byg eksisterende sider om til de prompts, hvor du har en reel chance for at vinde.
- Få andre til at bakke dig op. Bliv nævnt i de kilder, AI allerede henviser til.
- Tag de direkte sammenligninger til sidst. Indhold, der sammenligner dig med store konkurrenter, virker bedre, når du har opbygget lidt autoritet.
Boë Beauté fulgte den rækkefølge. Brandet rettede først sin identitet og crawleradgangen og samlede derefter indholdet om det, der gjorde brandet anderledes. De direkte sammenligninger ventede, til brandet havde opbygget autoritet.
Nogle gange giver det mening at bryde punkt 5. Hvis dine Must-win-spørgsmål er sammenligninger (”Hvilken løbesko er bedst, X eller Y?”), og din autoritet er lav, kan du ende med aldrig at besvare de spørgsmål, dine kunder faktisk stiller. Så kør trin 3, 4 og 5 sideløbende, og lad sammenligningssiderne ærligt anerkende, hvad konkurrenterne er gode til. Rækkefølgen er et udgangspunkt. Peger dine vigtigste spørgsmål i en anden retning, går de forud.
Trin 7: Planlæg ugen
Nu skal den prioriterede liste passe ind i de timer, du har. De fleste interne teams kan løse tre til fem opgaver om ugen ved siden af det øvrige arbejde.
|
Hvornår |
Hvad sker der |
Tid |
|---|---|---|
|
Mandag |
Den ansvarlige ser på udviklingen og på sidste uges løste opgaver og tager de næste opgaver fra toppen af listen |
30 minutter |
|
Mandag |
Opgaverne sendes til de rigtige teams: indhold, web eller PR |
15 minutter |
|
Tirsdag til torsdag |
Udkast, gennemlæsning, publicering og henvendelser til kilder |
Et par timer i alt |
|
Fredag |
Opgaverne markeres som løst, publiceringsdatoerne noteres, og det, der sidder fast, skrives ned |
15 minutter |
|
Hver måned |
Listen prioriteres igen ud fra de seneste svar, og opgaver, der ikke længere er relevante, fjernes |
1 time |
Tag fra toppen. Pluk ikke de nemme opgaver længere nede på listen. Prioriteringen findes, for at ugens indsats skal gå derhen, hvor den gør mest gavn.
Sådan ser tavlen ud i et demo-workspace en helt almindelig mandag.
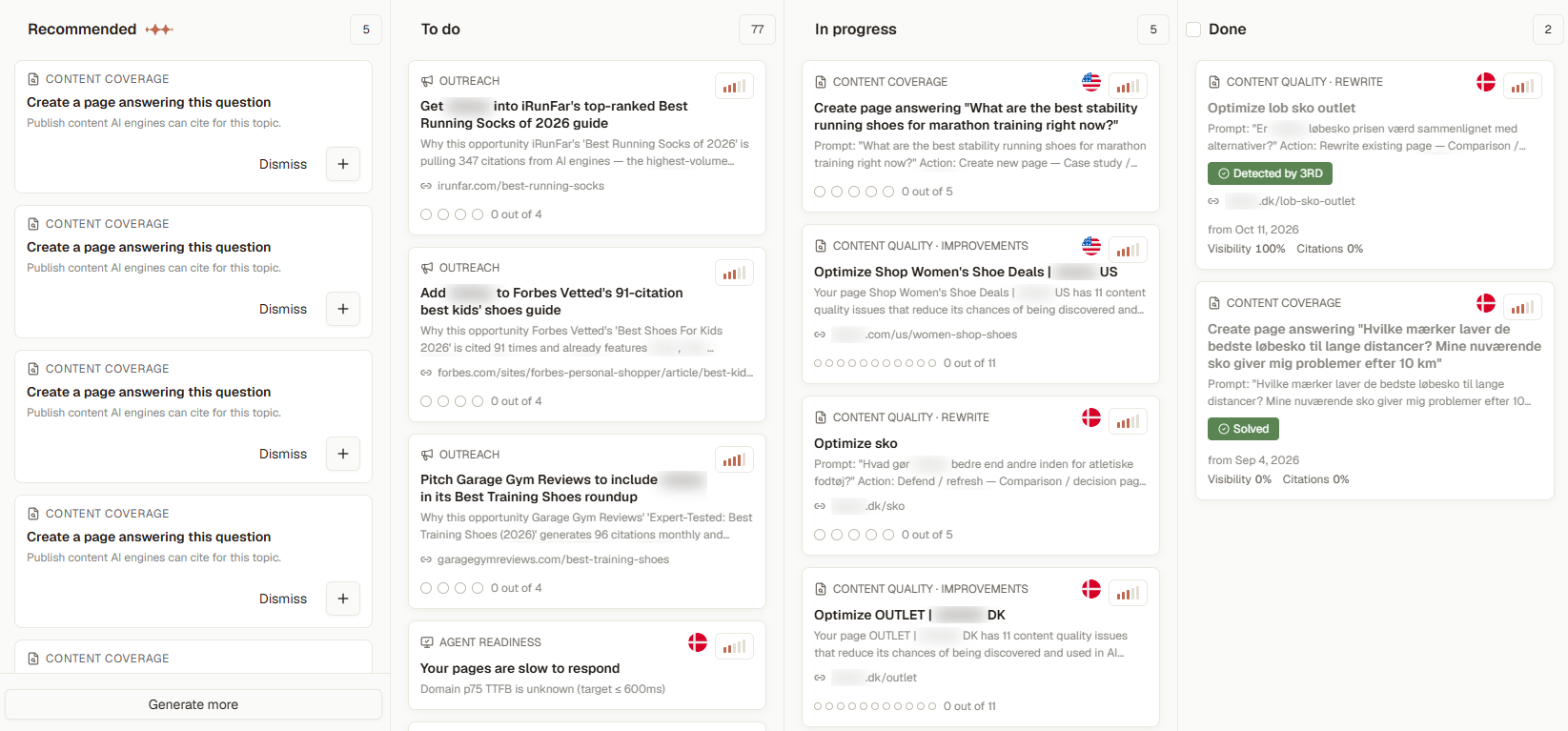
Opgavetavlen: 5 anbefalede, 77 skal gøres, 5 i gang og 2 løst. Hvert kort viser, hvilken faktor opgaven påvirker, og hvilket marked den gælder. Demo-workspace; brandnavne er sløret.
Hold øje med kolonnen ”I gang”. I demoen er der fem opgaver. Ligger der 40, mens kun en håndfuld er løst, er du gået i den fælde, som guiden advarer mod. Løsningen er at tage færre opgaver ad gangen og gøre dem færdige.
Trin 8: Mål på udviklingen, ikke på den enkelte dag
AI-modellerne crawler og lærer i deres eget tempo. Regn derfor med, at der går fra få dage til nogle uger, fra en opgave er løst, til du kan se det i svarene.
Mål derfor sådan her:
- Noter datoen, hver gang en opgave er løst.
- Sammenlign perioder, fx de to uger før med anden til sjette uge efter – i stedet for én dag med en anden.
- Sammenlign med en kontrolgruppe: prompts, som planen ikke har rørt. Er de steget lige så meget, er det markedet, der har rykket sig, og ikke dit arbejde.
- Læs svarene. Tjek, om dine formuleringer og sider nu indgår i dem.
Kontrolgruppen er ikke valgfri. Vi har set på 117 løste opgaver hos de brands, vi følger, hvor de prompts, opgaven sigtede efter, kunne sammenlignes med en kontrolgruppe af samme brands uberørte prompts. 29 % steg mere end 5 procentpoint i forhold til kontrolgruppen, 26 % faldt mere end 5 procentpoint, og 44 % holdt sig inden for det spænd. Medianændringen i forhold til kontrolgruppen var nul. Én måling før og én efter kan ikke skelne en reel fremgang fra helt normale udsving.
Sådan ser det ud for en enkelt opgave i demo-workspacet. Opgaven var at forbedre indholdskvaliteten på en dansk outletside for løbesko, ”Optimize lob sko outlet”. Sidens score steg fra 46 til 53. Synligheden på opgavens prompts blev på 100 %, mens brandets øvrige prompts gik fra 57 % til 55 % i samme periode. Andelen af AI-modeller, der henviste til siden, faldt fra 18 % til 0 %.
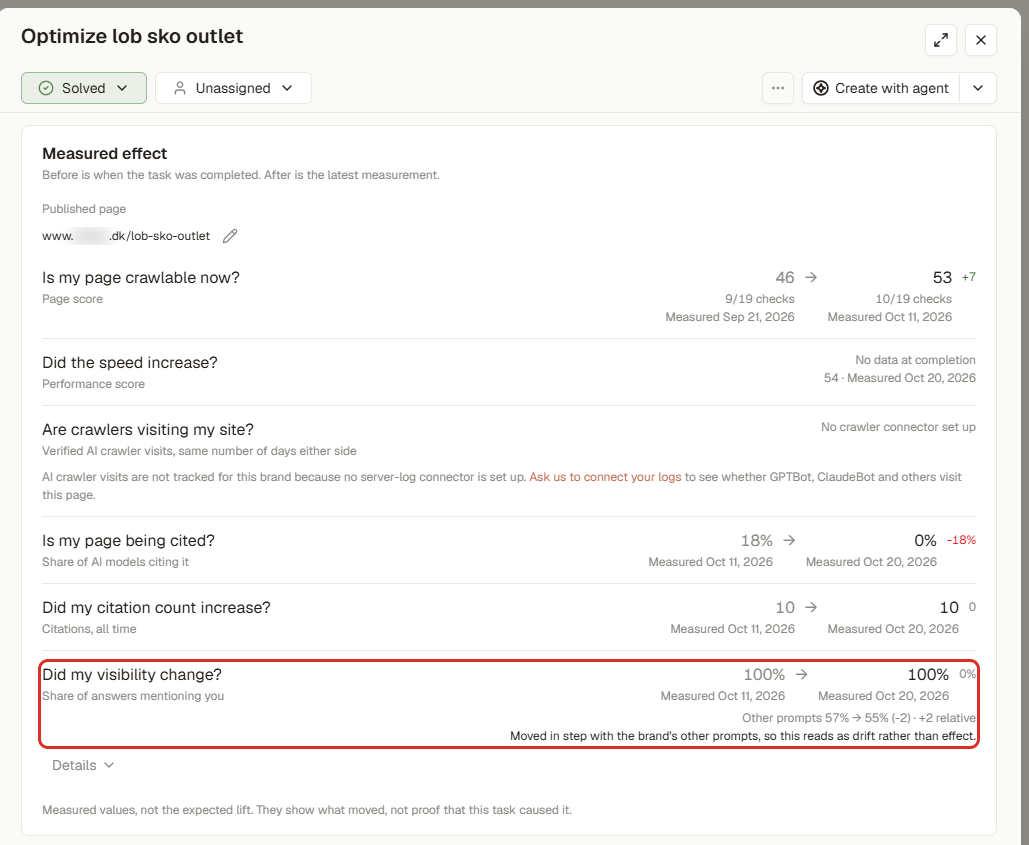
Målt effekt for en løst omskrivning, sammenlignet med brandets øvrige prompts. 3RD's egen vurdering: Udviklingen ”fulgte brandets øvrige prompts, så det ligner naturlige udsving snarere end effekt.” Demo-workspace; brandnavne er sløret.
Ifølge 3RD's egne tjek blev siden bedre. Synligheden klarede sig ikke bedre end kontrolgruppen, og modellerne holdt op med at henvise til siden. Den rigtige note i loggen er derfor ”siden er forbedret, endnu ingen effekt”, og arbejdet fortsætter. Det er ikke en sejr. Skærmen siger selv, at det er målte værdier og ikke bevis for, at opgaven var årsagen til ændringen.
Vær ærlig om, hvad det beviser. Konkurrenterne publicerer også, modellerne ændrer sig, og efterspørgslen svinger med sæsonerne. En stigende kurve ved siden af løste opgaver er et stærkt signal. Men den beviser ikke, at det var arbejdet, der fik kurven til at stige.
Typiske faldgruber
- At planlægge ud fra ét skærmbillede. De daglige svar svinger meget. Planlæg ud fra en baseline.
- Ti mål på én gang. Indsatsen bliver spredt så tyndt, at intet rykker sig nok til, at du kan se det.
- De nemme opgaver først. Listen fyldes med omskrivninger af Foundational-indhold, mens hullerne på Must-win står åbne.
- Kun eget indhold. De fleste kildehenvisninger peger på andres sider. Springer du outreach over, står størstedelen af hullet åbent.
- At rette det forkerte lag. Teams kaster sig over tekniske rettelser, fordi de føles konkrete. Tjek faktorerne først.
- For meget i gang. Med 40 åbne opgaver bliver ingen af dem færdige. Sæt et loft over, hvor mange opgaver der er i gang.
- Ingen ansvarlig. Når arbejdet er fordelt på flere teams, uden at nogen har ansvaret, bliver intet færdigt.
- Ingen klar slutning. Så står opgaverne som ”i gang” for evigt.
- At vurdere en opgave efter tre dage. Vent på måleperioden, og sammenlign med en kontrolgruppe.
Eksempel: den samme metode i 3RD
Alt ovenfor kan klares i et regneark, men det tager timer hver uge at holde det opdateret. Her er de dele, 3RD overtager – og dem, den ikke gør.
Trin 2 og 3: hullerne og deres årsager. Efter en fast tidsplan stiller 3RD AI-modellerne de prompts, du følger, på hvert marked og sprog og læser hvert eneste svar. Diagnose vurderer de fem faktorer: indholdsdækning, indholdskvalitet, crawlbarhed, autoritet og outreach. For hvert emne beskriver 3RD situationen, problemerne, en foreslået tilgang og hvor stort potentialet er. Hvert fund linker til de svar og kildehenvisninger, det bygger på, så du kan tjekke historien, før du handler ud fra den.
Trin 1, 4 og 5: målet og de prioriterede opgaver. Fra ethvert emne kan du starte en Playbook med knappen Opret Playbook. Du sætter målet, fx ”Øg synligheden til 70 % for Employer Branding i ChatGPT”, og 3RD finder de opgaver, der skal til for at nå det. Hver opgave har en vurdering af effekten fra meget lav til meget høj, en mærkning af kildetypen (indhold, outreach, crawlbarhed m.fl.) og en tjekliste med trin. Opgaverne med størst effekt ligger øverst.
Trin 7: ugen. Alle opgaver fra alle Playbooks samles på én tavle i Task Management med kolonnerne Skal gøres, I gang og Løst. Du tildeler opgaverne til dine kolleger, og de tekniske opgaver sender du videre til dit SEO- eller webteam.
Selve opgaverne. 3RD Agent er den assistent, der er bygget ind på hver side. Spørg den, hvad du skal fokusere på, så svarer den ud fra dine data. I demo-workspacet lyder spørgsmålet: ”Hvad skal vi fokusere på først for at blive valgt oftere, når kunderne spørger AI, hvilke løbesko de skal købe?”
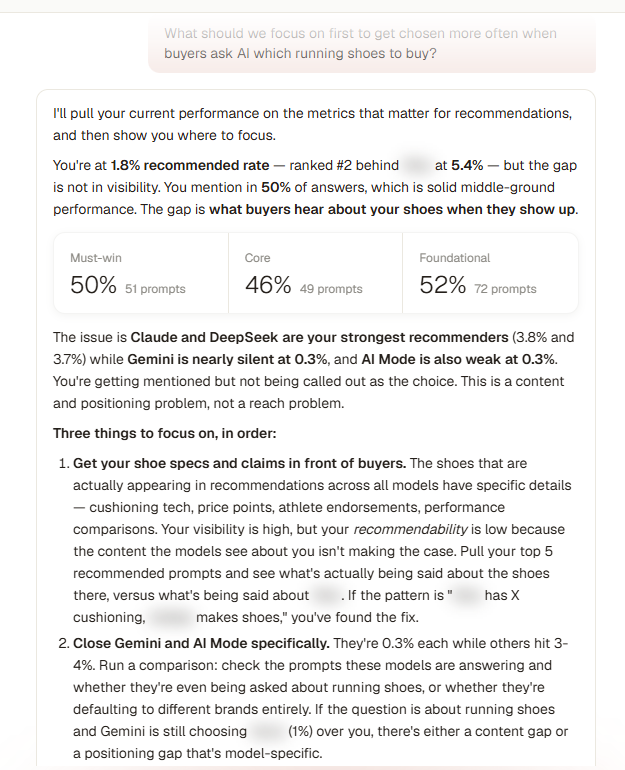
3RD Agent prioriterer, hvad der skal rettes først. Brandet bliver anbefalet i 1,8 % af svarene, mens den førende konkurrent ligger på 5,4 %. Første prioritet er at få skoenes specifikationer og egenskaber frem til kunderne. Demo-workspace; brandnavne er sløret.
Beder du den om at klare arbejdet, skriver den et udkast til siden, briefen eller vinklen til outreach. Flere af agentens færdigheder svarer direkte til trinene i denne guide:
|
Agentens færdighed |
Hvad den gør i planen |
|---|---|
|
Build a playbook |
Afklarer sammen med dig, hvad du vil påvirke, og planlægger derefter indsatsen |
|
Argue against my plan |
Argumenterer imod det, du er ved at forpligte dig til |
|
Is my plan still right |
Holder Playbooken op mod det, dataene viser nu |
|
Turn a gap into a brief |
Skriver en brief ud fra et hul, der er værd at lukke |
|
Turn this into a task |
Sender et svar til din Playbook som en opgave |
Alle de ændringer, agenten foreslår, kommer som et kort, og intet bliver skrevet, før du har godkendt det. Content Agent skriver udkast til hele sider ud fra en opgavebrief i dit brands tone of voice.
Trin 8: målingen. 3RD bliver ved med at holde hver Playbook op mod nye AI-svar. Løste opgaver viser en målt effekt ved siden af brandets øvrige prompts, som på skærmbilledet ovenfor. Skærmen siger tydeligt, at tallene viser, hvad der har rykket sig – ikke at opgaven var årsagen.
Det klarer 3RD ikke. 3RD publicerer ikke på dit website. Du gennemgår udkastet og publicerer det selv. 3RD retter heller ikke dine tekniske opgaver, men sender dem videre til dit webteam med trinene. Og 3RD påstår ikke, at en opgave fik tallene til at stige.
Du kan også spørge fra Slack. Nævn @3RD i en kanal, så svarer den ud fra de samme data.
Sådan ser det ud i praksis
Hos Boë Beauté fulgte én intern marketingmedarbejder uden baggrund i GEO eller SEO en plan fra 3RD et par timer om ugen. I tusindvis af AI-svar var det danske hudplejebrand ikke blevet nævnt én eneste gang. I løbet af ét kvartal nåede brandet en ugentlig synlighed på 22,2 % og en plads i top fem blandt syv konkurrenter.
Metoden krævede hverken en nyansættelse eller et bureau. Den krævede en plan i den rigtige rækkefølge og en person, der fulgte den hver uge. Vurder din egen plan på samme måde: på udviklingen over tid og i forhold til en kontrolgruppe.
Om dataene
Tallene på tværs af brands stammer fra brands, der blev fulgt i 3RD fra 19. september til 18. oktober 2026: 111 brands og 732.000 AI-svar til udsvingene, 100 brands og 5,9 mio. kildehenvisninger til kilderne og 60 brands til faktorscorerne. Resultaterne for opgaverne bygger på 117 løste opgaver med kontrolgruppe, afsluttet mellem februar og oktober 2026. Udvalget har en overvægt af nordiske brands. Dataene er anonymiseret og samlet, og de viser sammenhænge, ikke årsager.
Ofte stillede spørgsmål
Hvilken platform omsætter AI-synlighedsindsigter til en plan, man kan arbejde efter? 3RD omsætter diagnosen til Playbooks med et mål og opgaver, der er prioriteret efter effekt og kan tildeles, samlet på én tavle. 3RD Agent skriver udkastet, så du kan gennemgå og publicere det. Andre platforme gør det på andre måder (pr. oktober 2026). Profounds agenter kan publicere i dit CMS, når du har godkendt. KIME's agenter udfører opgaverne automatisk. Peec AI foreslår forbedringer af indholdet. Vælg ud fra, hvor meget kontrol dit team vil have over det, der går live.
Hvor mange opgaver om AI-synlighed bør et team løse om ugen? Tre til fem er realistisk for de fleste interne teams ved siden af det øvrige arbejde. Få færdige opgaver er bedre end mange halvfærdige. Tag fra toppen af den prioriterede liste hver mandag, og sæt et loft over, hvor mange opgaver der er i gang ad gangen.
Hvem skal have ansvaret for arbejdet med AI-synlighed? Én person, som regel i marketing. Indhold tager sig af hullerne på dine egne sider, PR eller kommunikation af hullerne i eksterne kilder, og web- eller SEO-teamet af de tekniske rettelser. Uden én ansvarlig går arbejdet i stå mellem teamene.
Hvor lang tid går der, før en opgave kan ses i AI-svarene? Regn med alt fra få dage til nogle uger. AI-modellerne crawler og lærer i deres eget tempo. Noter hver publiceringsdato, og vurder resultatet på udviklingen over to til seks uger i forhold til en kontrolgruppe af uberørte prompts – ikke på tallet dagen efter.
Kan jeg bruge planen i et regneark? Ja. Alle trin i guiden kan klares i et regneark. Prisen er tid: Det tager timer hver uge at tjekke svar på tværs af modeller og markeder, finde årsager og prioritere listen igen hver måned. En platform klarer den del, så dine timer går til at få opgaverne løst.
Head of Marketing