Recherche IA
Visibilité IA : transformer les données en plan de tâches hebdomadaire priorisé
Une méthode pas à pas pour classer les lacunes de visibilité IA, confier chaque correction à l'équipe concernée et livrer 3 à 5 tâches par semaine au service d'un seul objectif.
 Magnus Windeløv19 oct. 2026 · 21 min de lecture
Sommaire
Choisissez un seul objectif, listez tous les prompts sur lesquels vous êtes absent, trouvez la cause de chaque lacune et classez les corrections selon leur valeur commerciale rapportée à l'effort. Livrez ensuite trois à cinq tâches par semaine.
La plupart des équipes qui suivent leur visibilité IA ont les données. Ce qui leur manque, c'est l'étape entre le tableau de bord et le travail. Un score de visibilité vous dit que vous êtes absent. Il ne vous dit ni quoi faire lundi, ni qui doit s'en charger, ni par quoi commencer.
Prenons l'exemple d'un espace de démonstration. Une marque de sport y est suivie par rapport à six concurrents au Danemark, en Suède, au Royaume-Uni et aux États-Unis, sur sept modèles d'IA et 207 prompts. La semaine dernière, elle est apparue dans 44,5 % des réponses de l'IA et s'est classée deuxième sur sept marques. Son tableau compte 77 tâches dans la seule colonne « À faire ». Sans méthode pour choisir les trois suivantes, ce tableau n'est que du bruit.
Ce guide propose cette méthode. Vous pouvez l'appliquer dans un tableur. À chaque étape, je montre comment elle fonctionne dans 3RD à partir de cet espace de démonstration, y compris pour les parties que le logiciel ne fait pas.
La réponse courte
Un plan de visibilité IA utile comporte cinq éléments :
- Un seul objectif. Un chiffre à atteindre, pour un groupe de prompts identifié, sur un marché, à une date donnée.
- Une liste des lacunes. Tous les prompts de ce groupe sur lesquels vous êtes absent, et les marques qui apparaissent à votre place.
- Une cause pour chaque lacune. Page manquante, page faible, robot bloqué, aucune preuve dans les sources tierces ou identité confuse.
- Une liste de tâches classées. Chaque tâche a un responsable, un critère d'achèvement et un score.
- Un rythme hebdomadaire. Un petit lot livré chaque semaine, mesuré sur la tendance.
Voici comment procèdent la plupart des équipes aujourd'hui. Quelqu'un interroge ChatGPT à la main, fait une capture d'écran d'une réponse et ajoute « écrire plus de contenu sur X » à une liste de conseils. Or une liste de conseils n'est pas un plan : elle n'a ni ordre, ni responsable, ni moyen de savoir si elle a fonctionné.
Résultat : l'équipe sait qu'elle devrait agir, mais ne sait pas par où commencer. La suite de ce guide vous donne ce point de départ.
Ce qu'il vous faut d'abord
Réunissez ces cinq éléments avant de construire le plan.
|
Il vous faut |
Pourquoi |
Minimum |
|---|---|---|
|
Un ensemble de prompts suivis |
Le plan ne peut corriger que ce que vous mesurez |
10 à 15 prompts qui comptent pour vous, formulés comme vos clients posent la question |
|
Des prompts classés par valeur |
Une lacune sur une question d'achat compte plus qu'une lacune sur une définition |
Must-win, Core et Foundational |
|
Une référence dans le temps |
Un seul relevé, c'est du bruit |
Au moins deux semaines de réponses quotidiennes ou presque |
|
Des données de citation |
Elles indiquent les sources auxquelles l'IA se fie, et l'équipe qui doit combler la lacune |
Les URL citées, réparties entre sources propres et sources tierces |
|
Un responsable unique |
Quand la responsabilité est partagée, personne ne livre |
Une personne désignée, épaulée par les équipes contenu, web et RP |
Deux de ces éléments sont le plus souvent négligés.
Le classement par niveau. Dans la méthodologie de 3RD, un prompt Must-win est une question posée au moment de la décision, comme « Quelle plateforme une banque de taille moyenne devrait-elle utiliser pour X ? ». Un prompt Core façonne la sélection. Un prompt Foundational aide l'IA à bien comprendre votre catégorie. Les visibilités cibles recommandées sont respectivement de 75 %, 50 % et 35 %. Sans niveaux, toutes les lacunes paraissent aussi urgentes les unes que les autres, et le plan se remplit de travail facile à faible valeur.
La référence. Les réponses de l'IA varient d'un jour à l'autre, bien plus que la plupart des équipes ne l'imaginent. Sur 111 marques que nous suivons, et 732 000 réponses de l'IA entre le 19 septembre et le 18 octobre 2026, la visibilité de la marque médiane a varié de 12,5 points entre son meilleur et son pire jour du mois, sans que ses prompts changent. Pour 7 marques sur 10, au moins un relevé quotidien s'écartait de plus de 5 points de la moyenne sur 30 jours. Un plan construit sur une capture d'écran court après du bruit.
Plus l'ensemble de prompts est petit, plus les écarts sont forts. Les marques qui recueillaient moins d'une centaine de réponses par jour variaient environ deux fois plus que celles qui en recueillaient 230 ou plus. Une bonne règle : moins vous suivez de prompts, plus votre période de référence doit être longue.
Étape 1 : fixez un seul objectif
Rédigez l'objectif en une phrase qui comporte cinq éléments : un indicateur, un groupe de prompts, un marché, les modèles d'IA et une date.
Faire passer la visibilité de 11 % à 27 % sur les prompts Must-win consacrés aux logiciels de paie, aux États-Unis, sur ChatGPT et Gemini, d'ici la fin du premier trimestre.
Restez précis. Un objectif comme « améliorer notre visibilité IA » ne permet pas de classer les tâches, et il masque l'avancement. Un objectif précis sur des prompts commerciaux montre plus vite des résultats, et il vous apprend ce qui fonctionne pour votre marque.
De bons premiers objectifs :
- Les prompts Must-win sur votre plus grand marché
- Un sujet sur lequel un seul concurrent domine
- Le modèle d'IA que vos clients utilisent le plus
Dans 3RD, un Playbook part de cette phrase.
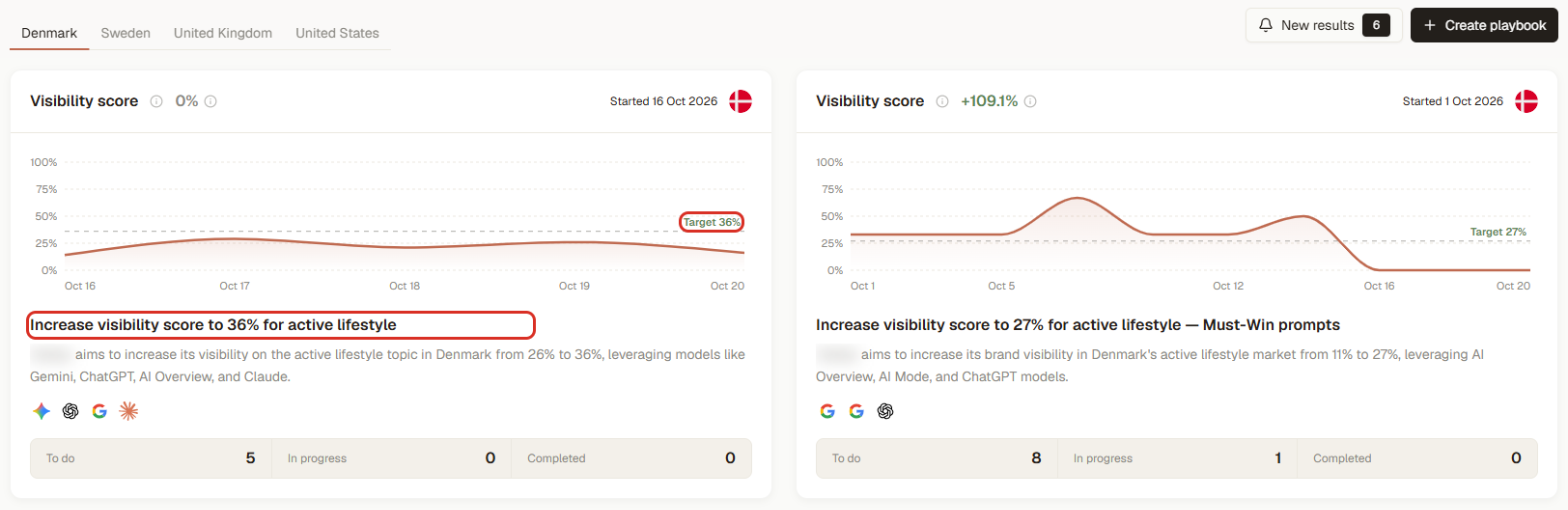
Deux Playbooks pour le Danemark, chacun construit autour d'un seul objectif : de 26 % à 36 % pour l'active lifestyle, et de 11 % à 27 % pour ses prompts Must-win. Espace de démonstration ; noms de marques floutés.
Dans l'espace de démonstration, les Playbooks danois portent sur un seul sujet, l'active lifestyle. Le premier objectif s'intitule « Porter le score de visibilité à 36 % pour l'active lifestyle » : il va de 26 % à 36 % sur Gemini, ChatGPT, Google AI Overviews et Claude, avec cinq tâches à faire. Le second est plus ciblé : les prompts Must-win du même sujet, de 11 % à 27 %. Tous deux suivent la phrase en cinq éléments décrite plus haut.
Étape 2 : dressez la liste des lacunes
Pour chaque prompt de l'objectif, notez ce que répond l'IA aujourd'hui, à raison d'une ligne par prompt.
|
Prompt |
Niveau |
Êtes-vous mentionné ? |
Qui est mentionné |
Principales sources citées |
Votre page correspondante |
|---|---|---|---|---|---|
|
Meilleur logiciel de paie pour une entreprise de 50 personnes |
Must-win |
0 modèle sur 4 |
Concurrent A, concurrent B |
Liste g2.com, blog du concurrent A |
Aucune |
|
Logiciel de paie avec hébergement des données dans l'UE |
Must-win |
1 modèle sur 4 |
Concurrent B |
Page tarifs du concurrent B |
/security, peu fournie |
|
Qu'est-ce que la paie intégrée ? |
Foundational |
2 modèles sur 4 |
Concurrent A |
Wikipédia, blog sectoriel |
/blog/embedded-payroll |
Lisez les réponses, pas seulement le score. Le texte de la réponse montre comment l'IA vous décrit, vous et vos concurrents. Les sources citées montrent où elle l'a appris.
Étape 3 : trouvez la cause de chaque lacune
Chaque lacune a une cause, et c'est elle qui détermine la tâche et l'équipe. Cinq causes couvrent presque tous les cas.
|
Ce que vous constatez |
Cause probable |
Type de tâche |
Qui corrige |
|---|---|---|---|
|
Aucune de vos pages ne répond au prompt |
Couverture du contenu |
Rédiger une nouvelle page |
Contenu |
|
Vous avez une page, mais elle n'est jamais citée |
Qualité du contenu |
Restructurer la page |
Contenu |
|
Vos pages ne sont jamais citées, même les bonnes |
Crawlabilité |
Débloquer les robots d'exploration des IA, corriger le rendu, ajouter des données structurées |
Web ou SEO |
|
Les réponses citent des listes tierces dont vous êtes absent |
Autorité et outreach |
Démarcher la source, mettre à jour un profil d'avis |
RP ou communication |
|
L'IA vous confond avec une autre entreprise |
Identité (entité) |
Ajouter des données d'organisation et une description cohérente partout |
Web, avec l'équipe contenu |
Attendez-vous à trouver la cause dans le contenu ou l'autorité, pas dans la couche technique. Sur les 60 marques que nous suivons, le score de crawlabilité médian était de 99 sur 100. Parmi les 54 marques pour lesquelles les cinq facteurs ont été mesurés, l'autorité ou la qualité du contenu était le facteur le plus faible pour 42 d'entre elles. La crawlabilité ne l'était pour aucune.
L'espace de démonstration confirme ce schéma. Au Danemark, la crawlabilité obtient 76, l'autorité 61, l'outreach 50, la couverture du contenu 47 et la qualité du contenu 45. Ce qui freine la marque, c'est le contenu, pas la couche technique.
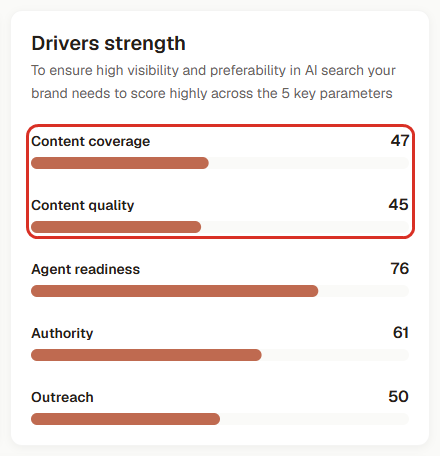
Les cinq facteurs pour le Danemark. La couverture et la qualité du contenu obtiennent les scores les plus bas. Espace de démonstration ; noms de marques floutés.
La répartition des citations est votre raccourci. Si les sources citées se trouvent sur votre propre domaine (sources propres), la correction relève du contenu. Si elles se trouvent sur le site de quelqu'un d'autre (sources tierces), elle relève de l'outreach. Cette répartition fonctionne comme un organigramme : elle vous dit quelle équipe est responsable de chaque lacune.
Prévoyez beaucoup d'outreach. Sur 100 marques et 5,9 millions de citations, le site de la marque médiane ne représentait que 6,8 % des sources citées par l'IA dans sa catégorie. Pour 41 de ces marques, l'IA citait plus souvent les sites des concurrents que celui de la marque elle-même. Un plan limité au contenu laisse de côté l'essentiel de l'écart.
Dans 3RD, Diagnostics rédige cette analyse pour chaque sujet.
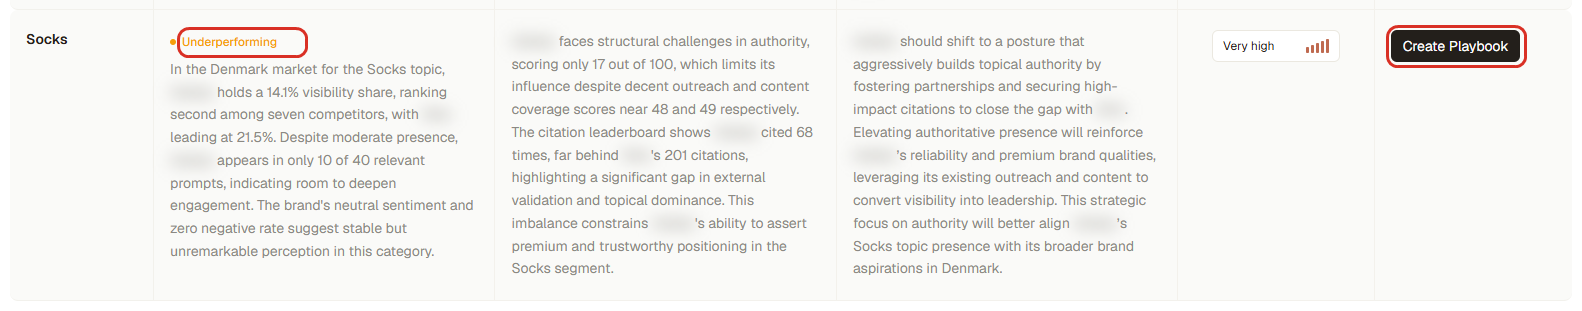
Le diagnostic du sujet chaussettes au Danemark : 14,1 % de visibilité contre 21,5 % pour le leader, les problèmes qui l'expliquent, une approche proposée et un Playbook en un clic. Espace de démonstration ; noms de marques floutés.
Étape 4 : transformez chaque cause en tâche, avec un critère d'achèvement
« Améliorer nos contenus comparatifs » n'est pas une tâche. Une tâche précise le prompt, la cause, les étapes et la ligne d'arrivée. Utilisez la même fiche pour toutes les tâches :
|
Champ |
Exemple |
|---|---|
|
Titre |
Publier une page comparative pour « Meilleur logiciel de paie pour une entreprise de 50 personnes » |
|
Prompts visés |
3 prompts Must-win du sujet paie |
|
Cause |
Couverture du contenu : aucune page ne répond à la question |
|
Éléments |
La page comparative du concurrent A est citée dans la plupart des réponses |
|
Étapes |
1. Brief 2. Brouillon 3. Relecture par un expert 4. Publication 5. Ajout au sitemap |
|
Responsable |
Responsable contenu |
|
Effort |
M (un à deux jours) |
|
Terminé quand |
La page est en ligne, explorable et liée depuis la page tarifs |
|
Mesurer à partir de |
La date de publication |
La ligne « Terminé quand » est la plus importante. Elle transforme une intention vague en une tâche que vous pouvez cocher le vendredi.
Voici à quoi ressemble une fiche de tâche dans 3RD.
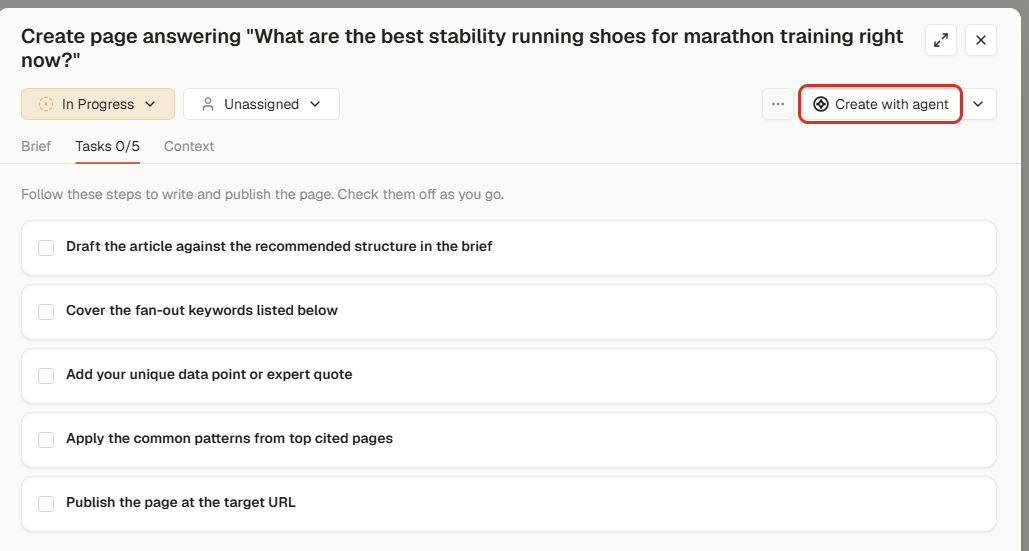
Une tâche de contenu avec sa liste de contrôle en cinq étapes. La dernière, la publication à l'URL cible, sert de critère d'achèvement. Espace de démonstration ; noms de marques floutés.
Une bonne tâche contient aussi le brief, qui reprend la structure commune aux pages que l'IA cite déjà sur la question.
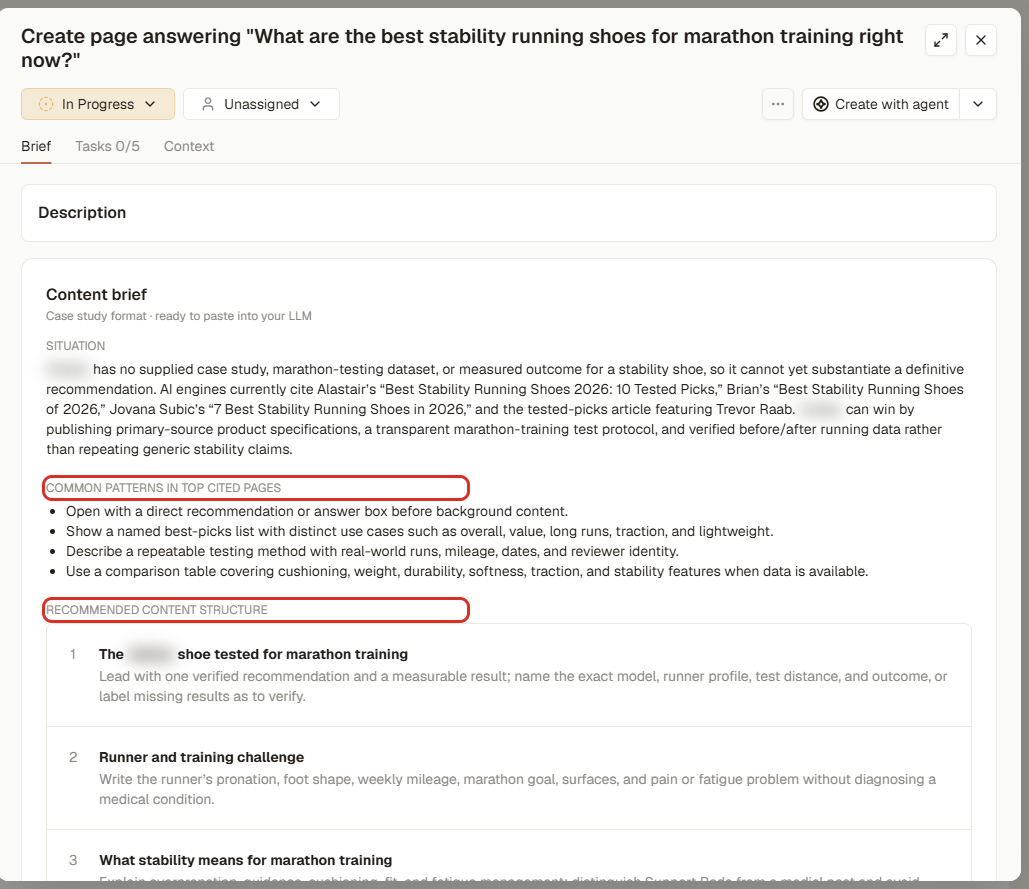
Le brief derrière cette tâche. L'IA cite quatre articles de tests de chaussures de running stables, qui ont en commun un encadré de réponse directe, des choix nommés par usage, une méthode de test reproductible et un tableau comparatif. Espace de démonstration ; noms de marques floutés.
Étape 5 : notez et classez les tâches
Classez les tâches selon leur valeur attendue, pas selon leur facilité. Un score simple suffit :
Priorité = poids du niveau × prompts concernés × taille de l'écart ÷ effort
- Poids du niveau : Must-win 3, Core 2, Foundational 1
- Prompts concernés : le nombre de prompts de l'objectif sur lesquels la tâche agit
- Taille de l'écart : 3 si vous êtes absent, 2 si vous êtes mentionné mais en retrait, 1 si vous êtes proche
- Effort : S = 1, M = 2, L = 3
|
Tâche |
Niveau |
Prompts |
Écart |
Effort |
Score |
|---|---|---|---|---|---|
|
Débloquer les robots d'exploration des IA sur /pricing |
3 |
8 |
2 |
S (1) |
48 |
|
Figurer dans la liste citée dans 6 réponses Must-win |
3 |
6 |
3 |
M (2) |
27 |
|
Nouvelle page comparative |
3 |
3 |
3 |
M (2) |
13,5 |
|
Réécrire la page glossaire |
1 |
2 |
1 |
S (1) |
2 |
Deux tendances se retrouvent dans presque tous les plans.
- Une vraie correction technique arrive en tête quand il y en a une. Elle est rapide et agit sur de nombreux prompts à la fois. Vérifiez cependant qu'elle est réelle : comme le montrent les données sur les facteurs ci-dessus, la couche technique est rarement le goulet d'étranglement.
- L'outreach vers une page très citée l'emporte souvent sur une nouvelle page. Beaucoup de réponses sont construites à partir des mêmes quelques sources.
Cette formule est un repère, pas une loi. Ajustez les poids si votre entreprise accorde plus de valeur à un marché ou à un modèle. L'essentiel, c'est que l'équipe classe les tâches selon la même règle chaque semaine.
Étape 6 : ordonnez le travail
Le classement dit ce qui a le plus de valeur ; l'ordre dit ce qui doit passer en premier. Certaines tâches ne portent leurs fruits qu'une fois d'autres terminées.
Suivez cet ordre :
- Être identifiable. Si l'IA vous confond avec une autre entreprise, rien d'autre ne fonctionne. Corrigez d'abord les données d'organisation et la description.
- Être lisible. Si les robots d'exploration des IA ne peuvent ni atteindre ni analyser vos pages, tout nouveau contenu est perdu. Corrigez ensuite l'accès et la structure.
- Être la réponse sur vos propres pages. Publiez et restructurez des pages pour les prompts sur lesquels vous êtes réellement légitime.
- Être cité par d'autres. Obtenez des mentions dans les sources que l'IA cite déjà.
- Affronter les concurrents en dernier. Les contenus qui vous comparent aux grands concurrents fonctionnent mieux une fois que vous avez acquis un peu d'autorité.
Le cas client Boë Beauté a suivi cet ordre. La marque a d'abord corrigé son identité et l'accès des robots, puis a concentré son contenu sur ce qui la distinguait, et n'a lancé les comparatifs directs qu'après avoir bâti son autorité.
Il est parfois judicieux d'enfreindre la règle 5. Si vos questions Must-win sont des questions de comparaison (« Quelle chaussure de running est la meilleure, X ou Y ? ») et que votre autorité est faible, attendre d'avoir de l'autorité revient à ne jamais répondre aux questions que vos clients posent vraiment. Dans ce cas, menez les étapes 3, 4 et 5 en parallèle, et reconnaissez dans vos pages comparatives ce que les concurrents font bien. Cet ordre est un point de départ par défaut, pas une règle à suivre quand vos questions les plus importantes disent le contraire.
Étape 7 : planifiez la semaine
Il reste à faire tenir la liste classée et ordonnée dans le temps dont vous disposez. La plupart des équipes internes peuvent livrer trois à cinq tâches par semaine en plus de leurs autres missions.
|
Quand |
Ce qui se passe |
Temps |
|---|---|---|
|
Lundi |
Le responsable examine la tendance et les tâches livrées la semaine précédente, puis prend les tâches suivantes en haut de la liste |
30 minutes |
|
Lundi |
Les tâches sont confiées aux équipes concernées : contenu, web ou RP |
15 minutes |
|
Du mardi au jeudi |
Rédaction, relecture, publication, prises de contact |
Quelques heures au total |
|
Vendredi |
Marquer les tâches comme terminées, noter les dates de publication et signaler ce qui bloque |
15 minutes |
|
Chaque mois |
Reclasser la liste au regard des dernières réponses et retirer les tâches qui n'ont plus d'intérêt |
1 heure |
Prenez les tâches par le haut. Ne piochez pas les tâches faciles plus bas dans la liste : le classement existe pour que l'effort de la semaine aille là où il a le plus de valeur.
Voici le tableau d'un espace de démonstration, un lundi ordinaire.
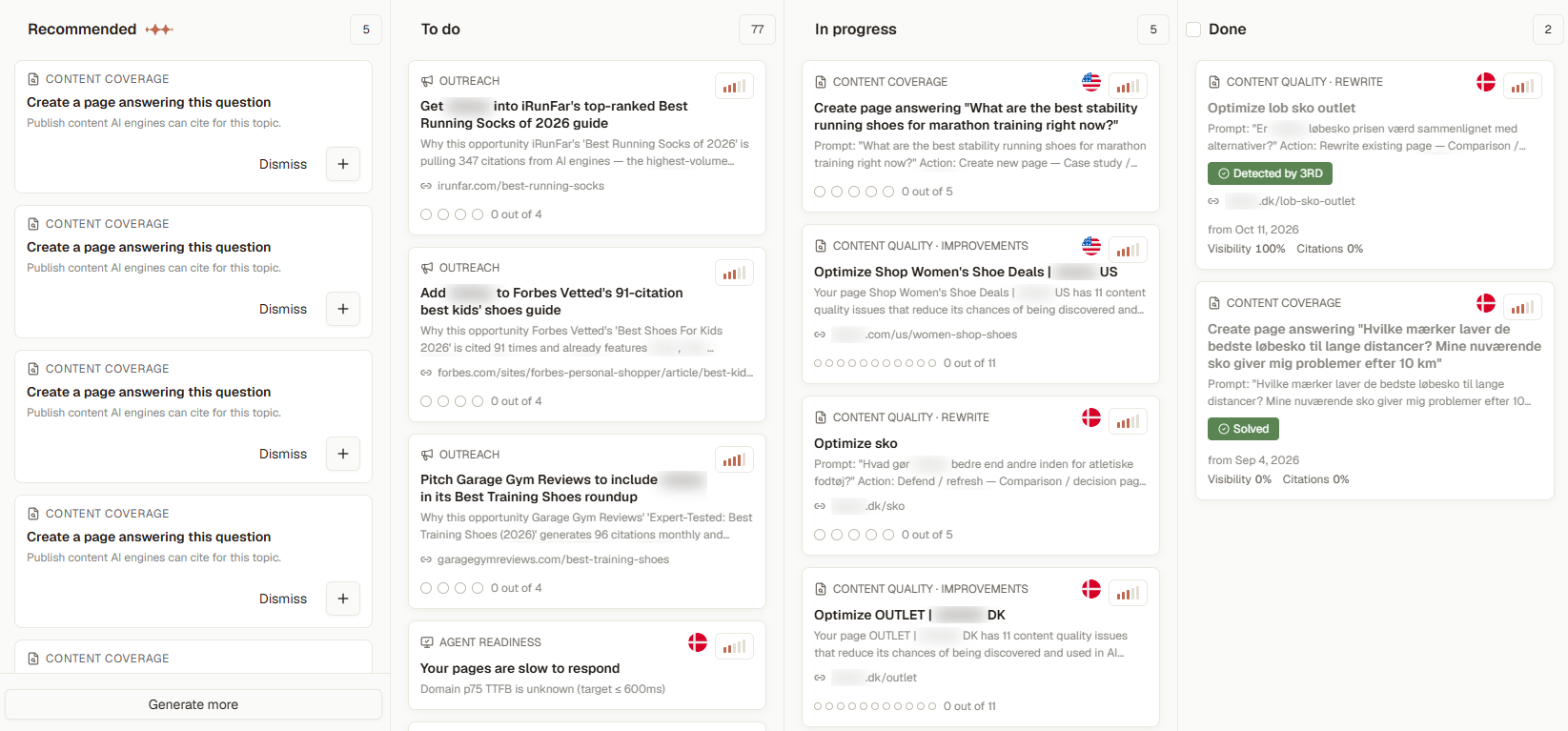
Le tableau des tâches : 5 recommandées, 77 à faire, 5 en cours et 2 terminées. Chaque carte indique le facteur sur lequel elle agit et le marché. Espace de démonstration ; noms de marques floutés.
Surveillez la colonne « En cours ». Dans la démonstration, elle compte cinq tâches. Si elle en comptait 40 pour une poignée de tâches terminées, ce serait exactement le piège contre lequel ce guide met en garde. La solution : prendre moins de tâches à la fois, et les terminer.
Étape 8 : mesurez sur la tendance, pas sur la journée
Les modèles d'IA réexplorent et réapprennent à leur propre rythme. Comptez de quelques jours à quelques semaines entre la livraison d'une correction et son effet visible dans les réponses.
Mesurez donc ainsi :
- Notez la date de livraison de chaque tâche.
- Comparez des périodes, par exemple les deux semaines avant la livraison et la période de deux à six semaines après, plutôt qu'un jour par rapport à un autre.
- Comparez avec un groupe témoin : les prompts que le plan n'a pas touchés. S'ils ont progressé tout autant, c'est le marché qui a bougé, pas votre travail.
- Lisez les réponses. Vérifiez si votre formulation et vos pages y apparaissent désormais.
Le groupe témoin n'est pas facultatif. Nous avons étudié 117 tâches terminées chez les marques que nous suivons, pour lesquelles les prompts visés pouvaient être comparés à un groupe témoin composé des prompts non travaillés de la même marque. 29 % ont progressé de plus de 5 points par rapport au groupe témoin, 26 % ont reculé de plus de 5 points et 44 % sont restées dans cette fourchette. La variation relative médiane était nulle. Un simple relevé avant-après ne permet pas de distinguer une vraie progression de la variation normale.
Voici ce que cela donne sur une tâche de l'espace de démonstration : la réécriture, pour améliorer la qualité du contenu, d'une page danoise de déstockage de chaussures de running, intitulée « Optimize lob sko outlet ». Le score de la page est passé de 46 à 53. La visibilité sur les prompts de la tâche est restée à 100 %. Sur la même période, les autres prompts de la marque sont passés de 57 % à 55 %, et la part des modèles d'IA citant la page est tombée de 18 % à 0 %.
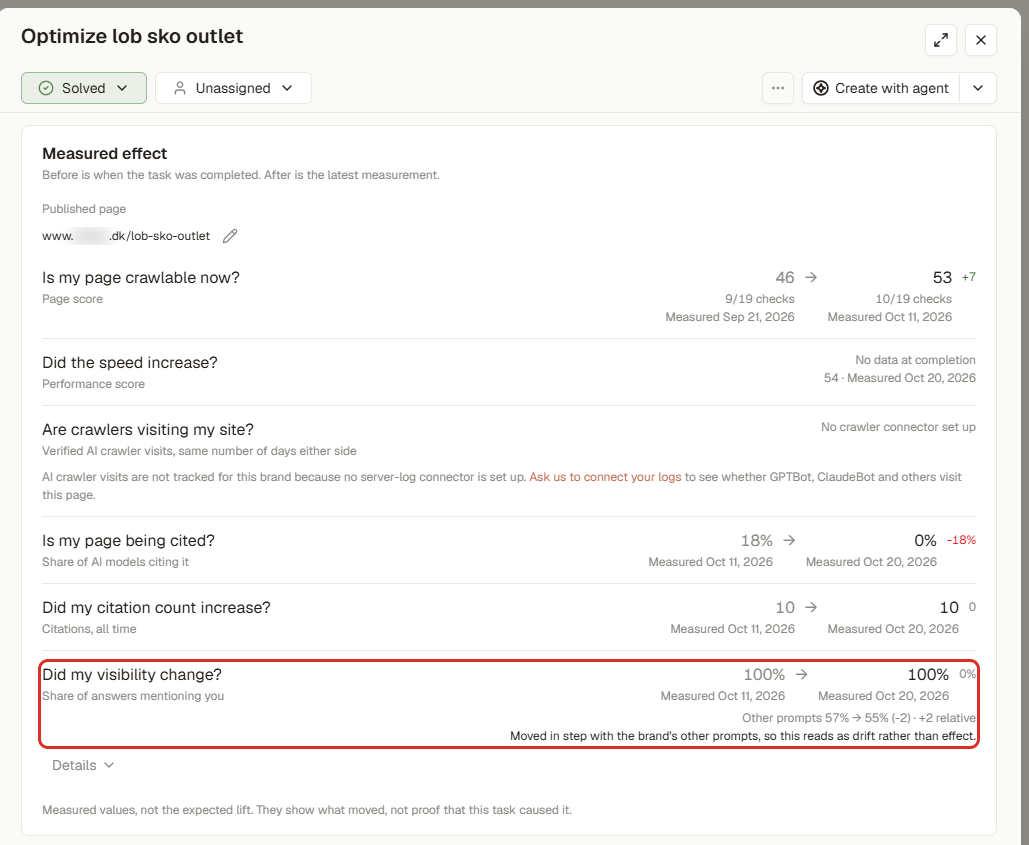
L'effet mesuré d'une réécriture résolue, comparé aux autres prompts de la marque. La lecture de 3RD : la page « a évolué au même rythme que les autres prompts de la marque, il s'agit donc d'une dérive plutôt que d'un effet ». Espace de démonstration ; noms de marques floutés.
Selon les contrôles de 3RD, la page s'est améliorée. Mais sa visibilité n'a pas fait mieux que le groupe témoin, et les modèles ont cessé de la citer. La bonne mention dans le journal est donc « page améliorée, pas encore d'effet », et le travail continue. Ce n'est pas une victoire. L'écran lui-même précise qu'il s'agit de valeurs mesurées, et non de la preuve que la tâche a causé le changement.
Soyez honnête sur ce que cela prouve. Les concurrents publient eux aussi, les modèles changent et la demande varie selon les saisons. Une tendance à la hausse à côté d'un travail livré est un signal fort, mais ce n'est pas la preuve que le travail a causé la hausse.
Les pièges les plus courants
- Planifier à partir d'une capture d'écran. Les réponses quotidiennes varient fortement. Planifiez à partir d'une référence.
- Dix objectifs à la fois. L'effort se dilue, et rien ne bouge assez pour être visible.
- Les tâches faciles d'abord. La liste se remplit de réécritures Foundational pendant que les lacunes Must-win restent ouvertes.
- Uniquement du contenu propre. La plupart des citations renvoient à des pages tierces. Négliger l'outreach laisse de côté l'essentiel de l'écart.
- Corriger la mauvaise couche. Les équipes se tournent vers les corrections techniques parce qu'elles paraissent concrètes. Vérifiez d'abord les facteurs.
- Trop de tâches en cours. Quarante tâches ouvertes, c'est le signe qu'aucune n'avance jusqu'au bout. Limitez le travail en cours.
- Aucun responsable. Quand le travail est réparti entre plusieurs équipes sans que personne en réponde, rien n'est livré.
- Aucun critère d'achèvement. Les tâches restent « en cours » indéfiniment.
- Juger une tâche au bout de trois jours. Attendez la fin de la période de mesure, et comparez avec un groupe témoin.
Exemple concret : la même méthode dans 3RD
Tout ce qui précède fonctionne dans un tableur, mais le tenir à jour prend des heures chaque semaine. Voici ce que 3RD prend en charge, et ce qu'il ne fait pas.
Étapes 2 et 3 : la liste des lacunes et leurs causes. À intervalles fixes, 3RD pose aux modèles d'IA les prompts que vous suivez, sur chaque marché et dans chaque langue, puis lit chaque réponse. Diagnostic note les cinq facteurs (couverture du contenu, qualité du contenu, crawlabilité, autorité et outreach). Pour chaque sujet, il décrit la situation, les problèmes, une approche proposée et l'ampleur de l'opportunité. Chaque constat renvoie aux réponses et aux citations sur lesquelles il repose, ce qui vous permet de vérifier l'analyse avant d'agir.
Étapes 1, 4 et 5 : l'objectif et les tâches classées. Depuis n'importe quel sujet, le bouton Créer un Playbook lance un Playbook. Vous fixez l'objectif, par exemple « Porter la visibilité à 70 % pour la marque employeur dans ChatGPT ». 3RD définit les tâches qui y mènent. Chacune reçoit un niveau d'impact (de très faible à très élevé), une catégorie de source (contenu, outreach, crawlabilité, etc.) et une liste d'étapes. Les tâches les plus porteuses remontent en tête de liste.
Étape 7 : la semaine. Toutes les tâches de tous les Playbooks arrivent sur un seul tableau Task Management : À faire, En cours, Terminé. Vous assignez les tâches à vos collègues, et les tâches techniques reviennent à votre équipe SEO ou web.
Réaliser les tâches. 3RD Agent est l'assistant intégré à chaque page. Demandez-lui sur quoi vous concentrer : il répond à partir de vos données. Dans l'espace de démonstration, la question est la suivante : « Sur quoi devons-nous nous concentrer en priorité pour être plus souvent choisis quand nos clients demandent à l'IA quelles chaussures de running acheter ? »
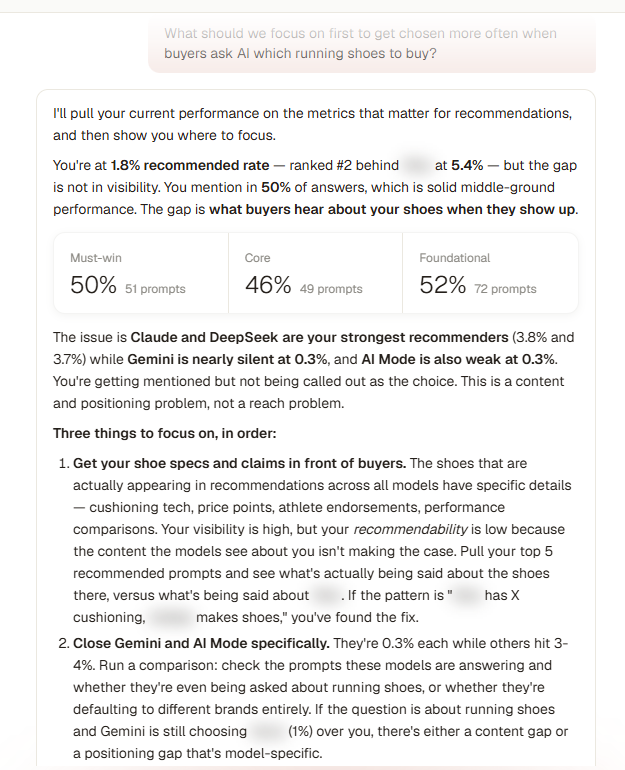
3RD Agent classe ce qu'il faut corriger en premier. La marque est recommandée dans 1,8 % des réponses, derrière un leader à 5,4 %. Sa première priorité : mettre les caractéristiques et les arguments des chaussures sous les yeux des clients. Espace de démonstration ; noms de marques floutés.
Demandez-lui de faire le travail : il rédige la page, le brief ou l'angle d'outreach. Plusieurs de ses compétences correspondent pas à pas à ce guide :
|
Compétence de l'agent |
Son rôle dans le plan |
|---|---|
|
Build a playbook |
Convient avec vous de ce qu'il faut faire bouger, puis planifie les actions |
|
Argue against my plan |
Plaide contre ce que vous vous apprêtez à engager |
|
Is my plan still right |
Confronte le Playbook à ce que disent les données aujourd'hui |
|
Turn a gap into a brief |
Rédige un brief à partir d'une lacune qui vaut la peine d'être comblée |
|
Turn this into a task |
Envoie une réponse dans votre Playbook sous forme de tâche à réaliser |
Chaque modification proposée par l'agent arrive sous forme de carte, et rien n'est écrit sans votre accord. Content Agent rédige des pages complètes à partir du brief d'une tâche, dans la voix de votre marque.
Étape 8 : la mesure. 3RD continue de mesurer chaque Playbook au regard des nouvelles réponses de l'IA. Les tâches terminées affichent un effet mesuré en regard des autres prompts de la marque, comme sur la capture ci-dessus. L'écran indique clairement que ces valeurs montrent ce qui a bougé, et non la preuve que la tâche en est la cause.
Ce que 3RD ne fait pas. Il ne publie pas sur votre site : vous relisez le brouillon et le publiez. Il ne corrige pas non plus vos tâches techniques, mais les transmet à votre équipe web avec les étapes. Et il ne prétend pas qu'une tâche a causé une hausse.
Vous pouvez aussi l'interroger depuis Slack : mentionnez @3RD dans un canal, et il répond à partir des mêmes données.
Ce que cela donne en pratique
Chez Boë Beauté, une responsable marketing interne, sans expérience en GEO ni en SEO, a suivi un plan 3RD à raison de quelques heures par semaine. Cette marque danoise de soins de la peau n'était apparue dans aucune des milliers de réponses de l'IA analysées. En un trimestre, elle a atteint 22,2 % de visibilité hebdomadaire et une place dans le top cinq parmi sept concurrents.
La méthode n'a exigé ni recrutement ni agence. Il a suffi d'un plan dans le bon ordre, et d'une personne qui le faisait avancer chaque semaine. Jugez votre propre plan de la même façon : sur la tendance, par rapport au groupe témoin.
À propos des données
Les chiffres agrégés proviennent des marques suivies dans 3RD entre le 19 septembre et le 18 octobre 2026 : 111 marques et 732 000 réponses de l'IA pour la variabilité, 100 marques et 5,9 millions de citations pour les sources, et 60 marques pour les scores des facteurs. Les résultats des tâches portent sur 117 tâches terminées avec un groupe témoin, achevées entre février et octobre 2026. L'échantillon penche vers les marques nordiques. Les données sont anonymisées et agrégées, et elles montrent une corrélation, pas une causalité.
Questions fréquentes
Quelle plateforme transforme les données de visibilité IA en plan d'exécution ? 3RD transforme son diagnostic en Playbooks construits autour d'objectifs, avec des tâches classées par impact et assignables sur un seul tableau, et 3RD Agent rédige le travail que vous relisez et publiez. D'autres plateformes ont une approche différente (situation en octobre 2026). Les agents de Profound peuvent publier dans votre CMS après une étape de validation. Ceux de KIME exécutent les tâches automatiquement. Peec AI suggère des optimisations de contenu. Choisissez en fonction du degré de contrôle que votre équipe veut garder sur ce qui est mis en ligne.
Combien de tâches de visibilité IA une équipe doit-elle livrer chaque semaine ? Trois à cinq, c'est réaliste pour la plupart des équipes internes, en plus de leurs autres missions. Mieux vaut moins de tâches, mais terminées, que beaucoup de tâches à moitié faites. Chaque lundi, prenez les tâches en haut de la liste classée, et limitez le nombre de tâches en cours simultanément.
Qui doit être responsable du travail de visibilité IA ? Une seule personne, en général au marketing. L'équipe contenu prend en charge les lacunes sur vos propres pages, les RP ou la communication celles des sources tierces, et l'équipe web ou SEO les corrections techniques. Sans responsable unique, le travail s'enlise entre les équipes.
Combien de temps avant qu'une tâche se voie dans les réponses de l'IA ? Comptez de quelques jours à quelques semaines. Les modèles d'IA réexplorent et réapprennent à leur propre rythme. Notez chaque date de publication, et jugez le résultat sur la tendance à deux à six semaines, par rapport à un groupe témoin de prompts non travaillés, et non sur le chiffre du lendemain.
Peut-on suivre ce plan dans un tableur ? Oui, chaque étape de ce guide fonctionne dans un tableur. Le coût, c'est le temps : vérifier les réponses sur plusieurs modèles et marchés, remonter aux causes et reclasser la liste chaque mois prend des heures chaque semaine. Une plateforme s'en charge, et vos heures servent à livrer.
Head of Marketing