AI-søgning
Sådan viser du, at en GEO-ændring faktisk har rykket din AI-synlighed
AI-svar skifter fra kørsel til kørsel. Mål en baseline, brug kontrolprompts, og sammenlign lige lange perioder. Så kan du skelne en reel fremgang fra støj.
 Magnus Windeløv19. okt. 2026 · 22 min. læsning
Indhold
Intet værktøj kan bevise, at en GEO-ændring er årsagen til en fremgang. Men du kan opbygge en overbevisende sag med en baseline, én logget ændring, kontrolprompts og gentagne kørsler.
Her er den korte version. AI-svar skifter fra kørsel til kørsel, så ét tjek før og ét efter beviser ingenting. Vil du vise, at en ændring virkede, skal du bruge fire ting:
- En baseline, der er lang nok til at vise, hvor meget tallet svinger af sig selv.
- Én ændring, hvor du har skrevet datoen ned.
- En kontrolgruppe af prompts, som ændringen ikke berører.
- To lige lange perioder, som du sammenligner på de samme prompts, modeller og markeder.
Er dine målprompts steget tydeligt mere end kontrolgruppen, og henviser svarene nu til din side eller gentager den, står du med en stærk sag. Det er stadig en sammenhæng og ikke en årsag. Skriv det i din rapport. Netop den ærlighed gør resten troværdigt.
GEO (generative engine optimization) er arbejdet med at få dit brand nævnt og brugt som kilde i AI-svar. I denne guide ser vi på, hvordan du tester det ordentligt: metoden trin for trin, de fejl, der giver falske sejre, og hvordan testen kører i 3RD. Eksemplerne kommer fra et demo-workspace.
Derfor er det vigtigt nu
Tag et demo-workspace som eksempel. Et sportstøjsbrand bliver fulgt i forhold til seks konkurrenter i Danmark, Sverige, Storbritannien og USA, på syv AI-modeller og 207 prompts. I den seneste uge blev brandet nævnt i 44,5 % af AI-svarene og lå nr. 2 ud af syv brands. Når teamet spørger 3RD Agent, hvad det skal fokusere på først for løbesko, handler svaret først og fremmest om at få skoenes specifikationer og påstande ud til kunderne.
Teamet står altså over for at publicere en masse indhold, og det skal vide, hvilke dele der rykker noget. Kan det ikke skelne en reel fremgang fra støj, satser det på de forkerte ting. Det er det samme problem, som alle marketingteams, der arbejder med GEO, har lige nu.
En marketingchef sagde det ligeud på et møde med os: ”Vi gør alle de her ting, og de virker som de rigtige ting at gøre. Men hvordan ser vi egentlig effekten af dem?”
Hvorfor er det så svært at se, om det virkede?
I Google kunne du tjekke en placering før og efter en ændring. Placeringerne var nogenlunde stabile, så en bevægelse betød noget. Sådan fungerer AI-svar ikke, og det er der tre grunde til.
- Svarene varierer. AI-modeller er probabilistiske. Den samme prompt kan få et andet svar i morgen, med andre brands og andre kilder.
- Ændringer tager tid. Modellerne crawler og lærer igen i deres eget tempo. Regn med, at der går fra dage til uger, fra du publicerer, til du kan måle en ændring.
- Mange ting rykker sig på én gang. Konkurrenterne publicerer, modellerne bliver opdateret, og efterspørgslen svinger med sæsonen. Hver af dem kan rykke dit tal i den samme uge som din ændring.
Sådan ser det ud i praksis. Her er tre måneders daglig synlighed for et brand og kategoriens førende brand i et demo-workspace.
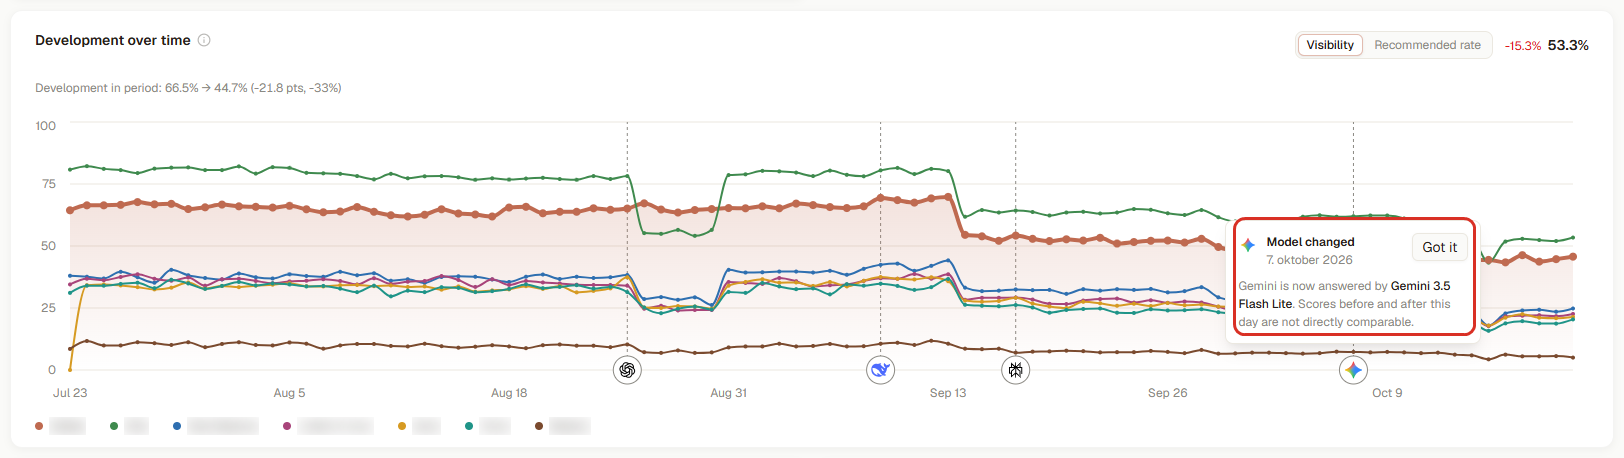
Tre måneders daglig synlighed. Brandet falder fra 66,5 % til 44,7 % og det førende brand fra ca. 80 % til ca. 53 %. Boksen ved 7. oktober viser, at Gemini skifter modelversion, og dermed brydes tidsserien. Demo-workspace; brandnavne er sløret.
To ting springer i øjnene. Brandet tabte 21,8 procentpoint i perioden, men det førende brand faldt også. Det var altså hele kategorien, der rykkede sig, og ikke kun dette brand. Desuden har grafen flere markeringer af modelskift. Den 7. oktober begyndte Gemini at svare med Gemini 3.5 Flash Lite. 3RD markerer det på tidslinjen og skriver, at scorerne før og efter den dag ikke kan sammenlignes direkte. Havde du publiceret en side den 6. oktober, kunne en ændring på Gemini lige så godt skyldes den nye model.
Spørgsmålet er derfor ikke, om tallet steg. Spørgsmålet er, om tallet steg mere, end det ville have gjort uden din ændring. Det er det spørgsmål, resten af guiden besvarer.
Hold det adskilt fra omsætning. ”Har vores arbejde rykket AI-synligheden?” kan besvares. ”Har AI-synligheden tjent penge til os?” kan kun delvist besvares, for de fleste AI-svar fører aldrig til et klik. Det har sin egen guide: sådan kobler du AI-anbefalinger og kildehenvisninger til omsætning.
Hvor stor er støjen? Data fra 111 brands
Vi ville have et tal for, hvad ”normal støj” er, så vi målte det på de brands, vi følger.
På tværs af 111 brands og 732.000 AI-svar mellem 19. september og 18. oktober 2026 så vi følgende:
- Hos medianbrandet svingede synligheden 12,5 procentpoint mellem bedste og dårligste dag på en enkelt måned, uden at der blev ændret i brandets prompts.
- Hos 7 ud af 10 brands (77 af 111) lå mindst én enkelt dag mere end 5 procentpoint fra brandets eget gennemsnit over 30 dage.
- Hos omkring hvert fjerde brand (30 af 111) lå en enkelt dag mere end 10 procentpoint ved siden af.
- Små promptsæt svinger dobbelt så meget. Brands med færre end ca. 100 svar om dagen havde en median-standardafvigelse pr. dag på 4,5 procentpoint. Brands med 230 svar eller flere lå på 2,1.
|
Svar pr. dag |
Medianudsving, bedste dag minus dårligste dag |
Andel dage mere end 5 procentpoint fra gennemsnittet over 30 dage (median) |
|---|---|---|
|
- |
- |
- |
|
24–94 |
16,7 procentpoint |
30 % |
|
101–229 |
10,3 procentpoint |
4 % |
|
230–2.501 |
8,7 procentpoint |
4 % |
Læs den første række en gang til. Følger du et lille sæt prompts, ligger næsten hver tredje dag mere end 5 procentpoint fra dit reelle gennemsnit. Ét tjek før og ét efter en ændring er så godt som plat eller krone.
Det skal du have på plads først
Før du ændrer noget, skal du have det her på plads:
|
Det skal du bruge |
Derfor |
|---|---|
|
- |
- |
|
Et fast promptsæt |
De spørgsmål, dine kunder stiller AI, formuleret sådan, som de stiller dem. Ændrer du prompts midt i testen, kan perioderne ikke sammenlignes. |
|
Gentagne kørsler |
Hver prompt sendes til hver model efter en fast tidsplan, helst dagligt. Ét svar om dagen pr. model er minimum, hvis du vil se et mønster. |
|
Mindst to ugers historik |
Du kan ikke vurdere en ændring, før du ved, hvor meget tallet svinger, når du ikke gør noget. |
|
Et fast sæt konkurrenter, du følger |
Konkurrenterne er din bedste kontrolgruppe. Steg alle, var det modellen, der ændrede sig, og ikke din side. |
|
Adgang til de rå svar |
Tallet fortæller dig, med noget har ændret sig. Svarene fortæller dig, hvad der har ændret sig. |
|
En ændringslog |
Dato og URL for hver ændring: sider, outreach og tekniske rettelser. |
Tjekker du ChatGPT manuelt i dag, kan du stadig bruge metoden. Men så skal du lave rigtig mange kørsler i hånden. Med de støjtal, du så ovenfor, er det den vigtigste grund til, at teams skifter til et værktøj.
Trin 1: Skriv ned, hvad du forventer, før du publicerer
Skriv én sætning, før du publicerer noget:
”Når vi publicerer [side], stiger [nøgletal] på [disse prompts] på [marked] på [modeller] inden for [uger] i forhold til [kontrolprompts].”
Her er et eksempel fra demo-workspacet: ”Når vi publicerer en side om de bedste stabilitetsløbesko til maratontræning, bliver den brugt som kilde på vores prompts om stabilitetssko i Danmark inden for seks uger i forhold til vores prompts om strømper.”
Når du skriver det først, undgår du bagefter at lede i dataene efter et hvilket som helst tal, der er steget. Vælg ét primært nøgletal:
- Kildehenvisninger til siden, hvis ændringen er en ny eller omskrevet side. Det er det mest direkte tegn på, at AI har brugt dit arbejde.
- Synlighed (andelen af svar, der nævner dit brand), hvis du vil vide, om du er med i samtalen.
- Placering eller anbefalingsrate, hvis du allerede bliver nævnt og vil vinde valget.
En tommelfingerregel: Vurder en helt ny side på kildehenvisninger først. Omtalerne kommer senere, og for et brand, der starter tæt på nul, kommer de langsomt.
Trin 2: Vælg målprompts og en kontrolgruppe
Målprompts er de spørgsmål, ændringen skal vinde. Hold listen kort. Fem til femten prompts om ét emne er lettere at læse end halvtreds.
Kontrolprompts er spørgsmål, som din ændring ikke burde påvirke. Gode kontrolprompts
- ligger i et andet emne, så din nye side ikke besvarer dem
- har nogenlunde samme kommercielle vægt (sammenlign Must-win med Must-win og ikke med brede researchspørgsmål)
- kører på de samme modeller og på de samme markeder.
Det bliver let, når dine prompts er grupperet efter emne. Hvert emne bliver så en naturlig mål- eller kontrolgruppe.
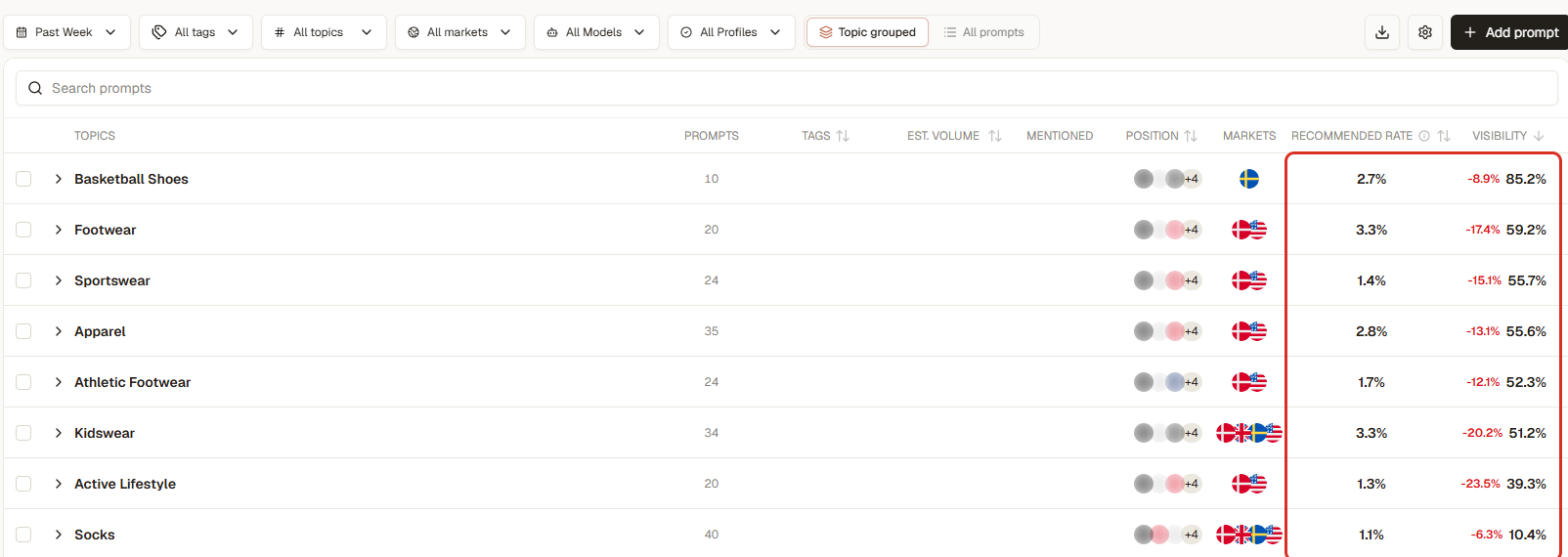
Prompts grupperet i otte emner, fra basketballsko med 85,2 % synlighed til strømper med 10,4 %. Hvert emne følges pr. marked. Når du publicerer til ét emne, bliver de andre din kontrolgruppe. Demo-workspace; brandnavne er sløret.
Tilføj en kontrolgruppe mere: dine konkurrenters synlighed på målprompterne. Steg du 6 procentpoint, og steg alle konkurrenterne også 6 procentpoint, er det sandsynligvis en modelopdatering, der har løftet alle.
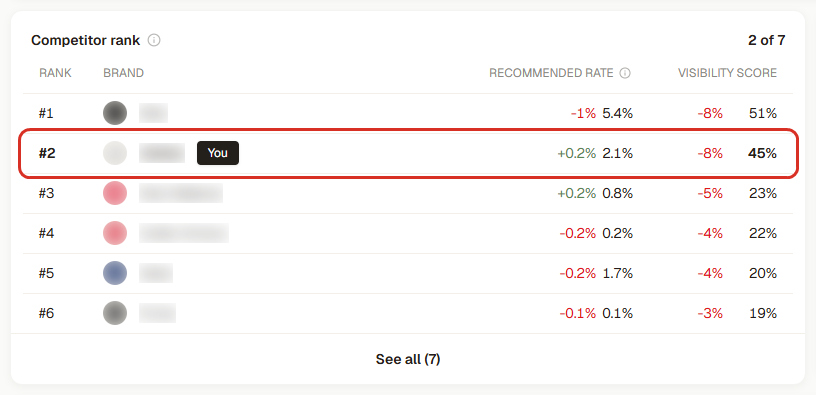
Konkurrentrangeringen for den seneste uge: Brandet ligger nr. 2 ud af syv med 45 %, efter det førende brand med 51 %. Rykker konkurrenterne sig på samme måde som dig, er det modellen, der har ændret sig, og ikke din side. Demo-workspace; brandnavne er sløret.
Trin 3: Mål en baseline, der viser støjen
Kør promptsættet i mindst to uger før ændringen, gerne fire. Se på spredningen og ikke kun på gennemsnittet.
Dataene fra de 111 brands viser hvorfor. Medianbrandet svinger 12,5 procentpoint mellem sin bedste og dårligste dag på en måned. En af vores kunder, Manyone, så sin daglige synlighed svinge mellem 1,4 % og 8,5 % inden for en enkelt måned. Havde du tjekket én gang før og én gang efter en ændring, kunne du have ”bevist” en sejr på 6 procentpoint eller et tab på 6 procentpoint, uden at noget var ændret.
To enkle statistiske greb hjælper:
- Brug en periode, ikke en dag. Sammenlign perioder på 14 eller 28 dage. Tallet for en enkelt dag betyder meget lidt.
- Tæl dine svar. Hvert synlighedstal hviler på et grundlag. I demo-workspacet bygger den seneste uges synlighed på 44,5 % på 4.051 omtaler i 9.105 svar. Jo færre svar i perioden, jo større skal udsvinget være, før du tror på det.
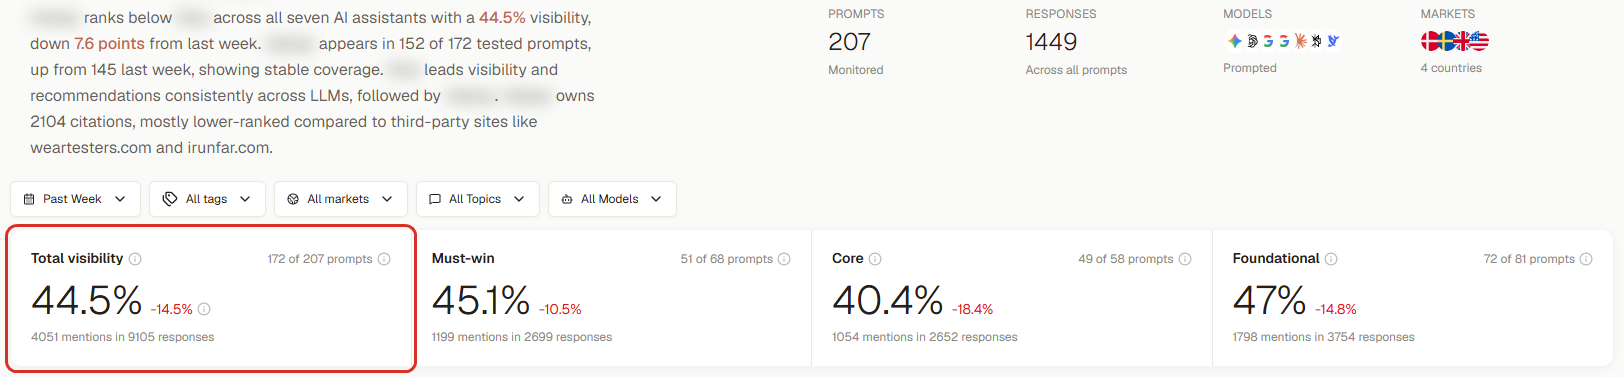
Overblik over synligheden i den seneste uge: 44,5 %, baseret på 4.051 omtaler i 9.105 svar, fordelt på Must-win 45,1 %, Core 40,4 % og Foundational 47 %. Hver score viser sit grundlag. Demo-workspace; brandnavne er sløret.
Her er en grov rettesnor, hvis den reelle synlighed ligger omkring 20 %:
|
Svar i hver periode |
Udsving, du kan se alene på grund af støj (ca. 95 % af tiden) |
|---|---|
|
- |
- |
|
50 |
± 11 procentpoint |
|
100 |
± 8 procentpoint |
|
400 |
± 4 procentpoint |
|
1,000 |
± 2,5 procentpoint |
Det er den almindelige statistiske usikkerhed for en andel, og du bør se den som et minimum. Svar fra samme dag og samme model har tendens til at rykke sig sammen, så den reelle støj er som regel større. Det er præcis, hvad dataene fra de 111 brands viser. Pointen er enkel: Flere prompts, flere modeller og flere dage giver en mere præcis måling. Med fem prompts, som du tjekker manuelt i en uge, kan du kun se de helt store spring.
Trin 4: Lav én ændring, og log datoen
Lav én ændring ad gangen på målprompterne. Publicerer du en side, pitcher til tre medier og retter din robots.txt i den samme uge, ved du ikke, hvad der virkede.
Du kan godt køre flere ændringer på én gang, hvis de går efter forskellige promptgrupper. Så har hver gruppe sin egen test.
Log ændringen samme dag, den går live:
- datoen
- URL'en eller målet for din outreach
- de prompts, den skal rykke
- hvad du forventer (fra trin 1).
Skriv også ned, hvad der ellers skete den uge, som du ikke selv havde styr på: et skift i modelversion, en konkurrent, der lancerede noget, eller en nyhed i din kategori. Det får du brug for, når du skal tolke resultatet.
Trin 5: Sørg for, at AI faktisk kan nå ændringen
En test fejler i stilhed, hvis modellerne aldrig ser din side. Tjek det her, før du starter uret:
- Siden er live og ikke blokeret. Ingen `noindex`, ikke blokeret i robots.txt og ikke gemt bag en botbeskyttelse, der stopper AI-crawlere.
- Den er med i dit sitemap med en korrekt dato for seneste ændring.
- Den kan læses uden JavaScript. Nogle AI-crawlere afvikler ikke scripts, så den vigtigste tekst skal stå i HTML'en.
- Der er links til den fra dit site. En side uden interne links bliver fundet sent, hvis overhovedet.
Selv velholdte sites dumper ofte her. I demo-workspacet tjekker rapporten 2.144 sider og finder 15 problemer. 1.315 sider mangler sidetitel eller beskrivelse. Købsknappen virker kun via JavaScript, så agenter kan ikke finde ud af, hvordan man køber. Og produkterne mangler identifikatorer som GTIN eller SKU.
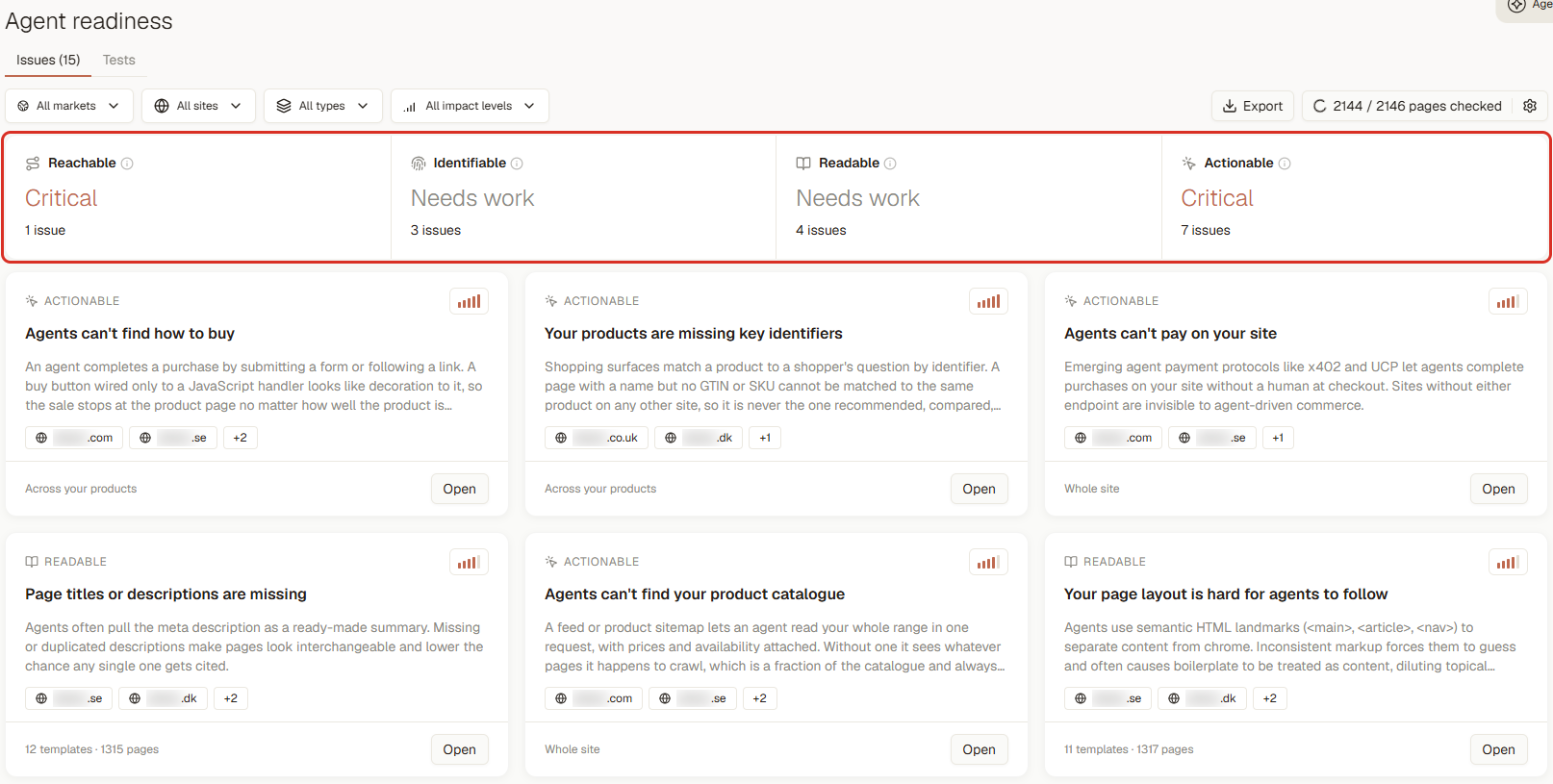
En Agent readiness-rapport for demobrandets site: 15 problemer, og to områder er markeret som kritiske. Ret de blokerende problemer, før du vurderer en test, der afhænger af dem. Demo-workspace; brand- og domænenavne er sløret.
Tæl din testperiode fra den dag, AI kan nå siden, og ikke fra den dag, du skrev den.
Trin 6: Hold øje med de tidlige signaler først
Ændringer viser sig i en forudsigelig rækkefølge. Følg dem i den rækkefølge, så du ikke erklærer en test død for tidligt:
- Siden bliver brugt som kilde. Svar, der søger på nettet, begynder at vise din URL som kilde. Det kan ske få dage efter, at siden er crawlet.
- Kildeandelen stiger. Dine sider udgør en større del af alle de kilder, AI bruger til de her prompts. Kildeandelen stiger ofte før synligheden.
- Omtalerne stiger. AI begynder at nævne dit brand i flere svar.
- Placering og anbefalinger bliver bedre. Du rykker op ad listen, og AI begynder at anbefale kunderne at vælge dig.
Der kan være langt mellem punkt 1 og punkt 3. I demo-workspacet bliver brandet nævnt i 44,5 % af svarene, men brandets egne sider udgør kun 2,5 % af kildehenvisningerne i kategorien. De egne sider, AI henviser mest til, er to forsider, en kampagneside, en størrelsesguide til børn og en købsguide.
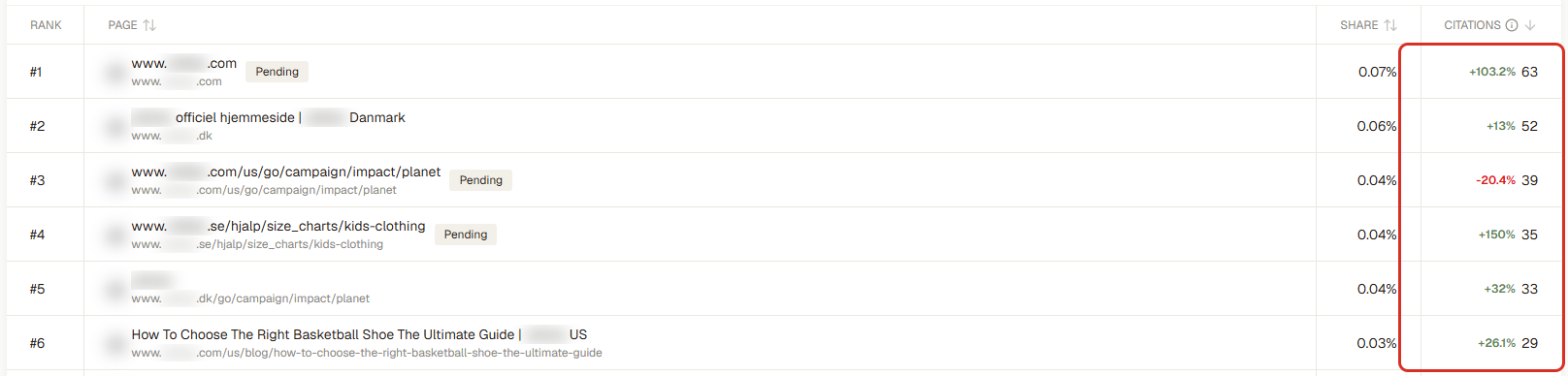
De egne sider, der oftest blev brugt som kilde i den seneste uge: den globale forside (63 kildehenvisninger), den danske forside (52), en kampagneside, en svensk størrelsesguide til børn og en købsguide. Kildehenvisninger og omtaler er to forskellige signaler, og de rykker sig i forskelligt tempo. Demo-workspace; brandnavne er sløret.
Sker punkt 1 aldrig, selv efter fire til seks uger, er problemet sandsynligvis, at AI ikke kan nå siden, eller at den ikke er relevant nok. Teksten er næppe synderen. Gå tilbage til trin 5, eller tjek, om siden svarer direkte på prompten.
Husk forskellen på live søgning og træning. Svar, der søger på nettet, kan afspejle din side kort efter, at den er crawlet. Svar, der bygger på det, modellen har lært under træningen, ændrer sig først, når der kommer en ny modelversion. Det er endnu en grund til at læse resultaterne pr. model.
Trin 7: Sammenlign lige lange perioder – mål over for kontrol
Nu skal du sammenligne. Brug det samme antal dage før og efter, de samme prompts, de samme modeller og de samme markeder. Spring den første uge efter lanceringen over, hvis du ved, at crawlingen tager tid.
Beregn ændringen for hver gruppe og derefter forskellen mellem dem:
|
|
Før (28 dage) |
Efter (28 dage) |
Ændring |
|---|---|---|---|
|
- |
- |
- |
- |
|
Målprompts |
12 % |
21 % |
+9 procentpoint |
|
Kontrolprompts |
15 % |
17 % |
+2 procentpoint |
|
Forskel |
|
|
+7 procentpoint |
Tallene er illustrative.
De +7 er din estimerede effekt: den del af stigningen, som kontrolgruppen ikke fik. Analytikere kalder det ”difference-in-differences”, og det er standardmetoden, når ”alt muligt andet ændrede sig også”.
Tjek derefter, om resultatet holder:
- Er +7 større end den støj, du så i baselinen? Svingede din baseline ±8 procentpoint, er det ikke overbevisende endnu. Forlæng perioden.
- Var målprompterne allerede på vej op før ændringen? Så var en del af stigningen allerede i gang.
- Rykkede konkurrenterne sig på samme måde? Steg de alle, så led efter en modelopdatering.
- Ses fremgangen på alle modeller eller kun på én? En fremgang på kun én model er reel, men rapportér den sådan.
- Var der et modelskift i en af perioderne? Så del sammenligningen op ved den dato, eller forlæng perioden, så den rækker ud over den.
En tommelfingerregel: Sig først, at et resultat har ”rykket sig”, når målprompterne slår kontrolgruppen med mere end 5 procentpoint. Alt inden for ±5 er ”ingen fremgang endnu”.
Trin 8: Læs svarene, og bekræft mekanismen
Tallene fortæller dig, at noget har ændret sig. Svarene fortæller dig, om det skyldes din ændring.
Åbn svarene på dine målprompts fra før og efter:
- Er din nye side blandt kilderne?
- Gentager svaret et faktum, et tal eller en formulering, som kun findes på din side?
- Er en konkurrent faldet ud, eller er der dukket en ny kilde frem, som du ikke har rørt?
Et praktisk trick: Sæt ét konkret, sandt og citerbart faktum på den nye side, som ikke er publiceret andre steder, fx et tal fra dine egne data. Når svarene begynder at gentage det, har du direkte bevis for, at AI har læst din side. Støjtallene fra de 111 brands i denne artikel kommer fra 3RD's egen research. Ser du dem i et AI-svar, ved du, hvor de stammer fra.
Trin 9: Rapportér ærligt
Skriv resultatet i ét afsnit, som ledelsen kan læse:
”Vi publicerede en sammenligningsside den 2. september. I de følgende 28 dage steg synligheden på de 8 målprompts fra 12 % til 21 %. Vores øvrige Must-win-prompts steg 2 procentpoint i samme periode, så målprompterne steg 7 procentpoint mere. ChatGPT henviser nu til den nye side i 40 % af svarene på de prompts. Konkurrenterne lå stille. Vi tolker det som en sandsynlig effekt af siden. Det er ikke et bevis på årsagen, for både modellerne og konkurrenterne ændrer sig også.”
Eksemplet er illustrativt.
Den sidste sætning beskytter dig. De mest erfarne kunder, vi taler med, beder ikke om bevis. De tjekker, om du lader, som om du har det.
Typiske faldgruber
Det er de fejl, vi oftest ser på de konti, vi følger.
|
Fejl |
Hvad der sker |
Løsning |
|---|---|---|
|
- |
- |
- |
|
Det enkelte tjek |
Én måling før og én efter. Med et typisk udsving på 12,5 procentpoint om måneden ”beviser” du sejre og tab, der aldrig er sket. |
Sammenlign perioder på 14 eller 28 dage. |
|
Promptsættet, der ændrer sig |
Nye prompts ændrer gennemsnittet, selv om intet andet har rykket sig. |
Lås mål- og kontrolprompts fast under testen. |
|
Konkurrentsættet, der ændrer sig |
Din placering afhænger af, hvem du følger. Tilføjer du en konkurrent, rykker din placering, uden at svarene har ændret sig. |
Hold konkurrentsættet fast under testen. |
|
Ophobningen |
Tre ændringer på de samme prompts i én uge. Du ved, at noget virkede, men ikke hvad. |
Én ændring pr. promptgruppe ad gangen. |
|
Den tidlige dom |
En indholdsændring bliver vurderet efter en uge. |
Giv den fire til seks uger, og se på kildehenvisningerne først. |
|
Det samlede tal |
En stigning på researchprompts skjuler et fald på de prompts, der ligger tættest på et køb. |
Læs Must-win-prompts for sig. |
|
Prognosen som resultat |
En estimeret effektscore bliver rapporteret som en opnået fremgang. |
Hold ”forventet” og ”målt” i hver sin kolonne. |
|
Kun synlighed |
Siden bliver brugt som kilde, omtalerne er ikke steget endnu, og testen bliver lukket. |
Brug kildehenvisninger som det tidlige signal. |
|
Modelskiftet |
En modelversion skifter midt i testen, og fremgangen skyldes i virkeligheden den nye model. |
Notér modelskift, og del perioderne op ved den dato. |
Et eksempel i 3RD: en omskrevet side
Her er en rigtig opgave fra et demo-workspace. Den viser ikke det resultat, et team ville håbe på, og netop derfor er den nyttig.
Ændringen. 3RD markerede en dansk outletside for løbesko som en opgave om indholdskvalitet: ”Optimize lob sko outlet”. Siden blev skrevet om, og opgaven blev markeret som løst.
Det målte 3RD bagefter. Når en opgave er løst, måler 3RD, hvad der har rykket sig fra den dag til den seneste måling:
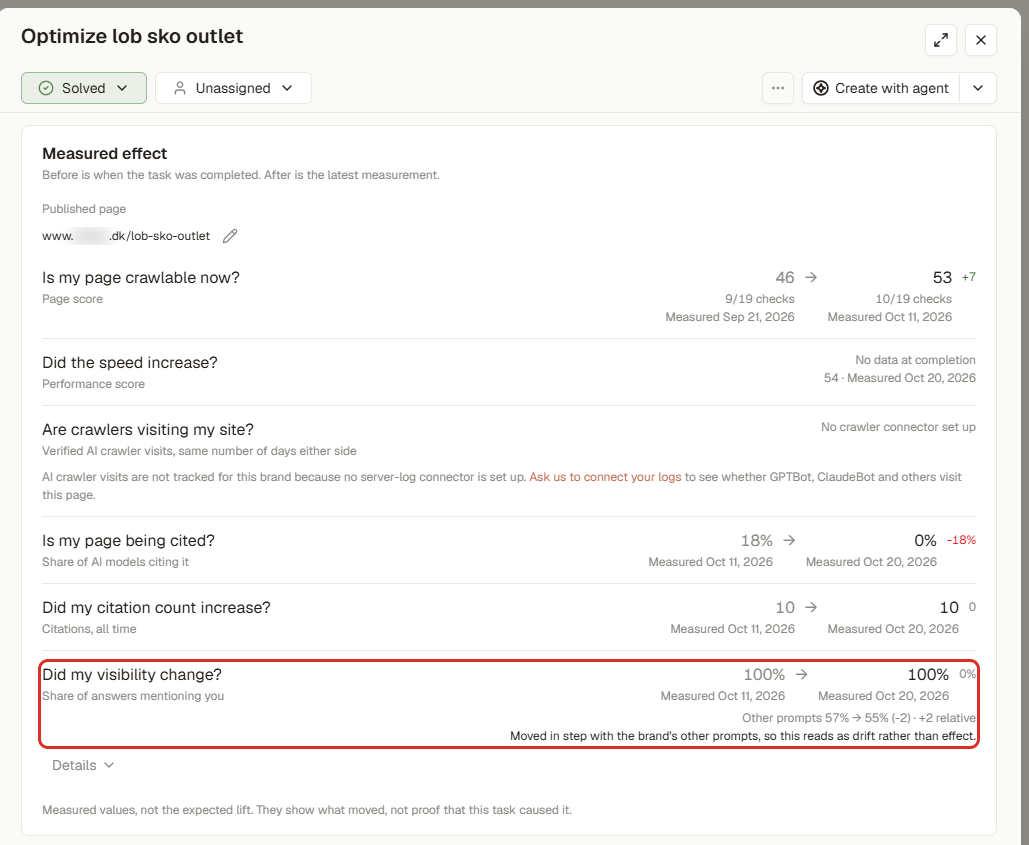
Den målte effekt af en omskrevet side. Sidescoren steg fra 46 til 53, men synligheden fulgte brandets øvrige prompts. Derfor tolker 3RD det som almindelig drift og ikke som en effekt. Demo-workspace; brandnavne er sløret.
- Blev siden bedre? Sidescoren steg fra 46 til 53, og siden bestod 10 af 19 tjek i stedet for 9.
- Bliver siden brugt som kilde? Andelen af AI-modeller, der henviser til siden, faldt fra 18 % til 0 %. Antallet af kildehenvisninger lå stadig på 10.
- Ændrede synligheden sig? På opgavens prompts lå synligheden stadig på 100 %. I samme periode gik brandets øvrige prompts fra 57 % til 55 %. Det er 2 procentpoint bedre end kontrolgruppen og ligger et godt stykke inde i støjen. 3RD skriver det ligeud: ”Moved in step with the brand's other prompts, so this reads as drift rather than effect.” Synligheden fulgte altså brandets øvrige prompts, og det ligner drift snarere end en effekt.
Fodnoten på skærmen siger det bedst: Det er målte værdier og ikke den forventede fremgang. De viser, hvad der har rykket sig, men beviser ikke, at opgaven var årsagen.
Sådan skal det læses. Omskrivningen gjorde siden bedre i 3RD's egne tjek. Men det viste sig ikke som en effekt i svarene. Prompterne lå allerede på 100 %, så der var ikke plads til at stige, og færre modeller henviste til siden bagefter. Én omskrivning af én side er endnu ikke et resultat. Log det som ”ingen fremgang endnu”, og bliv ved med at holde øje med kildehenvisningerne.
Det er et resultat, du kan handle ud fra. Uden kontrolgruppen kunne teamet have rapporteret ”sidescore op med 7, synligheden holder på 100 %” og kaldt det en sejr.
Sådan kører resten af forløbet i 3RD:
- Sæt målet. Opret en Playbook med et mål for en gruppe prompts, fx ”Øg synligheden på Must-win-prompts med sammenligninger i Danmark på ChatGPT og Google AI Overviews”. Målet låser prompts, marked, modeller og nøgletal fast. Så har du trin 1 på skrift.
- Læs baselinen og støjen. Sæt perioden i Overblik til 90 dage, så du ser, hvordan tallet svinger af sig selv. Modelskift er markeret på tidslinjen.
- Lav arbejdet, og markér datoen. Vælg den øverste opgave i Playbooken. 3RD Agent skriver et udkast til siden ud fra opgavens brief, og du tjekker det og publicerer det på dit eget site. Markér lanceringen på tidslinjen, så du senere kan læse tallene op mod den.
- Tjek, at AI kan nå siden. Klar til AI-agenter tester, om AI-crawlere kan nå og læse dine sider.
- Brug dine kontrolgrupper. Konkurrentrangeringen viser dine konkurrenter på de samme prompts. Filtrér Overblik efter emne eller prompttype, så du kan sammenligne din målgruppe af prompts med prompts, som ændringen ikke har berørt. Når en opgave lukkes, sammenligner den målte effekt automatisk målprompterne med brandets øvrige prompts.
- Bekræft det i svarene. Åbn svarene på målprompterne, og tjek, om din side er blandt kilderne.
- Rapportér det. Lav perioden om til en rapport med dit brand til ledelsen. Vil du lave din egen analyse, kan du trække dataene ud via Export API'et eller Looker Studio-connectoren.
Det gør 3RD ikke: publicerer for dig eller påstår, at dit arbejde var årsagen til ændringen. Du bestemmer, hvad der skal publiceres, og du læser resultatet op mod dine kontrolgrupper.
Dataene: Før og efter er så godt som plat eller krone
Vi har også set på, hvad der sker på tværs af kunderne, når opgaver er løst. Vi tog de 117 løste opgaver hos 44 brands, hvor 3RD målte målprompterne op mod en kontrolgruppe af det samme brands uberørte prompts (mediankontrolgruppen var på 37 prompts).
|
Resultat i forhold til kontrolgruppen |
Opgaver |
Andel |
|---|---|---|
|
- |
- |
- |
|
Steg mere end 5 procentpoint |
34 |
29 % |
|
Inden for ±5 procentpoint (”ingen fremgang”) |
52 |
44 % |
|
Faldt mere end 5 procentpoint |
31 |
26 % |
Medianen for den relative ændring var 0.
Det betyder ikke, at arbejdet er ligegyldigt. Synligheden pr. opgave hviler på en håndfuld prompts, og i starten af artiklen så du, hvor meget små stikprøver støjer. Det betyder, at én måling før og én efter ikke kan skelne en reel fremgang fra almindelig variation. Du har brug for kontrolgruppen, perioden og tålmodigheden.
Det er også derfor, vi ikke lover, at ”denne opgave giver X procentpoint”. Et estimat fortæller dig, hvad du skal gøre først. Kun målingen fortæller dig, hvad der faktisk skete.
Hvilket værktøj kan vise, at en GEO-ændring har rykket din synlighed?
Intet værktøj kan bevise en årsagssammenhæng ud fra AI-svar alene. Vær skeptisk over for dem, der påstår det. Til gengæld kan et værktøj give dig grundlaget for en stærk sag. Kig efter det her:
|
Funktion |
Derfor betyder den noget for beviset |
|---|---|
|
- |
- |
|
Gentagne kørsler efter en fast tidsplan |
Gør støjende svar til en trend, du kan læse |
|
Synlig stikprøvestørrelse |
Viser, om en ændring er større end støjen |
|
Konkurrenter fulgt på de samme prompts |
Din kontrolgruppe for modelopdateringer |
|
Markering af modelskift |
Forhindrer, at du giver din side æren for en ny modelversion |
|
Rå svar og kildehenvisninger pr. prompt |
Bekræfter mekanismen: Har AI brugt din side? |
|
Målt effekt i forhold til en kontrolgruppe |
Sammenligner det, du gik efter, med det, du ikke rørte, når arbejdet er gjort |
|
Estimater holdt adskilt fra målinger |
Holder ”vi forventer” adskilt fra ”vi har målt” |
|
Dataeksport |
Lader en analytiker lave sammenligningen uafhængigt |
Sådan dækker nogle af mulighederne det pr. oktober 2026 ifølge deres egne websites:
- 3RD dækker forløbet ovenfor: daglig måling op mod et mål i en Playbook, modelskift markeret på tidslinjen, målt effekt af løste opgaver i forhold til brandets øvrige prompts, konkurrentvisninger, svarene og deres kildehenvisninger samt eksport via API, CSV, MCP og Looker Studio.
- Profound tilbyder Agent Analytics, der viser, hvordan AI-bots ser, henviser til og sender trafik til dine sider. Data om botbesøg er et nyttigt ekstra signal til trin 5.
- Peec AI følger synlighed, placering og sentiment over tid og har CSV-eksport, et API og en Looker Studio-connector. En analytiker kan altså bygge sammenligningen i sine egne værktøjer.
- Gør du det manuelt, fungerer det til en eller to prompts. Men du får sjældent samlet svar nok til at komme igennem støjen.
Om dataene
Tallene fra de 111 brands kommer fra brands, der blev fulgt i 3RD mellem 19. september og 18. oktober 2026: mere end 18.000 prompts og 732.000 AI-svar fra op til 11 AI-assistenter, anonymiseret og samlet, primært fra nordiske markeder. Opgaveresultaterne dækker 117 løste opgaver med en kontrolgruppe hos 44 brands (februar til oktober 2026). Dataene er observationsdata. De viser sammenhænge og ikke årsager.
FAQ
Hvor længe skal jeg vente, før jeg vurderer en GEO-ændring? Fire til seks uger for en indholdsændring. Modellerne crawler og lærer igen i deres eget tempo, så regn med, at der går fra dage til uger, før en side viser sig i svarene. Kildehenvisninger til siden kommer ofte, før omtalerne stiger.
Hvorfor steg min AI-synlighed fra den ene dag til den anden, uden at jeg havde ændret noget? Fordi AI-svar varierer fra kørsel til kørsel. På tværs af de 111 brands, vi følger, svinger medianbrandet 12,5 procentpoint mellem sin bedste og dårligste dag på en måned. Sammenlign perioder på 14 eller 28 dage, tjek, om konkurrenterne rykkede sig på samme måde, og tjek, om der har været et skift i modelversion.
Hvor mange prompts skal jeg bruge til en pålidelig test? Nok svar til at komme igennem støjen. Brands med færre end ca. 100 svar om dagen svinger dobbelt så meget fra dag til dag som brands med 230 svar eller flere. Med fem til femten målprompts, der kører dagligt på to eller flere modeller i fire uger, får du et par hundrede svar pr. periode. Det er nok til at se en ændring på omkring 4 til 8 procentpoint.
Kan jeg bevise, at AI-synligheden har øget omsætningen? Ikke fuldt ud. De fleste AI-svar fører aldrig til et klik, så intet værktøj kan følge hver beslutning, AI har påvirket. Du kan vise trafikken fra AI i GA4 ved siden af din synlighed og spørge nye kunder, hvor de har hørt om dig. Læs sådan kobler du AI-synlighed til omsætning.
Hvad er det bedste enkeltsignal på, at min side virkede? At AI henviser til siden på de prompts, den går efter, og gentager fakta, som kun står på den. Det er direkte bevis for, at AI har brugt dit arbejde. Synlighed, placering og anbefalinger følger som regel efter, men langsommere. En bedre side er ingen garanti for nogen af delene, som eksemplet med den omskrevne side viser.
Kom i gang i denne uge: Vælg ét Must-win-emne, skriv ned, hvad du forventer, og mål en baseline i to uger, før du publicerer. Se, hvordan 3RD måler det, eller prøv gratis.
Head of Marketing