AI-søgning
Sådan måler du AI-synlighed pr. land og sprog
AI svarer forskelligt fra land til land og fra sprog til sprog. Her er, hvordan du sætter markeder op, skriver prompts på kundernes eget sprog, finder den rette størrelse på hvert sæt og rapporterer på tværs af markeder.
 Magnus Windeløv19. okt. 2026 · 16 min. læsning
Indhold
Mål hvert par af land og sprog som et marked for sig, og skriv dine prompts, sådan som de lokale kunder selv spørger. Læg aldrig markederne sammen til ét tal.
Det er den korte version. Den lange version er vigtig, for fejlene her er dyre, og man opdager dem ikke. Én samlet global score kan fortælle dig, at alt er fint, selvom du er usynlig på det marked, hvor størstedelen af din omsætning ligger.
Lad mig vise det med et demo-workspace. Det er et sportstøjsbrand, der bliver fulgt i forhold til seks konkurrenter i Danmark, Sverige, Storbritannien og USA på syv AI-modeller og 207 prompts. Tallene er dem, workspacet viste i oktober 2026. Det er altså ikke en kundes resultater:
|
Visning |
Demobrandets synlighed |
Førerens synlighed |
|---|---|---|
|
Alle fire markeder, alle prompts (seneste uge) |
45 % (nr. 2 af 7) |
51 % |
|
Danmark, alle prompts |
43,4 % |
49,3 % |
|
Danmark, emnet sokker (40 prompts) |
14,1 % (nr. 2 af 7) |
21,5 % |
Fra et demo-workspace. Brandnavne er udeladt.
Det samlede tal siger, at brandet ligger tæt bag føreren. Åbner du ét marked, mangler brandet i cirka 6 ud af 10 AI-svar i Danmark. Og åbner du ét emne på det marked, bliver det nævnt i omkring hvert syvende svar. Et globalt tal beskriver ingen af delene. Vores kundedata viser, at føreren skifter fra AI-assistent til AI-assistent for 37 af 60 brands. Om føreren også skifter fra land til land, må du tjekke på dine egne markeder.
Den sidste række viser også guidens anden pointe: En måling af et emne er aldrig bedre end antallet af prompts bag den. 40 prompts er nok til at handle ud fra. Med fire prompts har du kun et fingerpeg. Jeg vender tilbage til stikprøvens størrelse i trin 3.
Guiden handler om, hvordan du sætter markeder op, skriver prompts til hvert marked, finder den rette størrelse på hvert promptsæt og rapporterer på tværs af markeder uden at narre dig selv. Er du helt ny i at måle AI-synlighed, så start med sådan måler du dit brands synlighed i ChatGPT, Perplexity og Google AI Overviews, og kom så tilbage hertil. Skal du vælge en leverandør til måling på flere markeder, så læs den bedste europæiske platform til AI-synlighed.
Det korte svar
- Et marked er et land og et sprog. Danmark på dansk og Danmark på engelsk er to markeder, fordi AI svarer forskelligt på hvert af dem.
- Skriv prompts på det lokale sprog fra bunden. Oversætter du en prompt, måler du et spørgsmål, som ingen stiller.
- Gør sættene ens. Brug de samme emner og den samme fordeling af prompttyper på alle markeder, så tallene kan sammenlignes.
- Gør hvert sæt stort nok til den beslutning, du skal træffe. Små sæt svinger cirka dobbelt så meget som store.
- Vælg AI-assistenter marked for marked. Det er forskelligt, hvilken assistent der foretrækker dig, og forskellen er stor.
- Se på kildehenvisningerne for hvert marked. En del af de sider, AI læner sig op ad, er lokale. Det samme gælder derfor din outreach-liste.
- Rapporter pr. marked, aldrig som ét samlet gennemsnit.
Derfor snyder ét globalt tal
Et samlet tal skjuler tre ting, som betyder noget for et team, der arbejder på flere markeder.
Forskellige førere. I vores data på tværs af kundebrands var det for 62 % af brandsene (37 af 60) forskelligt fra assistent til assistent, hvilken konkurrent der havde den højeste synlighed. Lægger du markeder oveni, bliver billedet endnu mere splittet. Et brand kan føre i ét land og være helt fraværende i det næste, og et gennemsnit af de to beskriver ingen af dem.
Forskellige kilder. AI-svar bygger på sider fra tredjeparter, og mange af dem er lokale. Et dansk svar kan henvise til et dansk LinkedIn-opslag eller et dansk fagmedie, som aldrig optræder i et britisk svar.
Forskellig støj. Mindre markeder får som regel mindre promptsæt, og mindre sæt svinger mere. Tager du gennemsnittet af et lille, støjende marked og et stort, stabilt marked, viser det lille markeds tilfældige udsving sig som bevægelse i dit samlede tal.
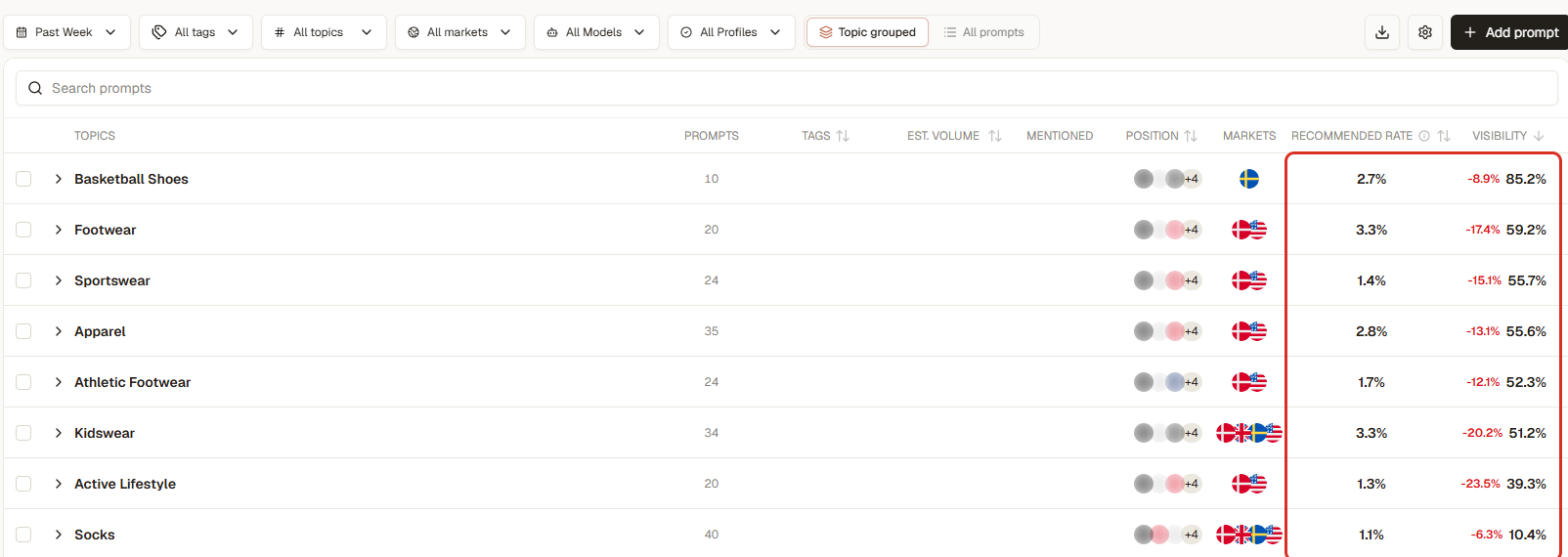
Prompts samlet i emner med anbefalingsrate, synlighed og ændring for hvert emne. Flagene viser, hvilke markeder hvert emne kører på: Danmark, Sverige, Storbritannien og USA. Synligheden går fra 85,2 % for basketballsko ned til 10,4 % for sokker. Demo-workspace; brandnavne er sløret.
Det skal du have på plads først
|
Det skal du bruge |
Hvorfor |
Hvor du finder det |
|---|---|---|
|
En liste over de lande, du sælger i, prioriteret efter omsætning eller pipeline |
Afgør, hvilke markeder der får flest prompts |
Økonomi eller CRM |
|
Det sprog, dine kunder bruger i hvert land |
Afgør, hvor mange markeder du reelt har |
Salg og customer success |
|
Lokale konkurrenter i hvert land |
Din placering afhænger af, hvem du sammenligner dig med |
Salg, noter fra vundne og tabte handler |
|
Én person med sproget som modersmål pr. sprog |
Til at skrive og gennemgå prompts |
Dit team, en lokal partner eller et bureau |
|
Et promptbudget |
Du betaler for prompts × assistenter × markeder |
Dit abonnement eller værktøjets priser |
Trin 1: Definer markeder som par af land og sprog
Den mest almindelige fejl i opsætningen er at tænke i lande. Tænk i par.
Stil to spørgsmål for hvert land:
- Hvilket sprog bruger kunderne i landet, når de undersøger det, du sælger?
- Skifter nogle af kunderne sprog, når de stiller den slags spørgsmål?
I mange europæiske lande er svaret på det andet spørgsmål ja. Danske og hollandske fagfolk undersøger ofte software på engelsk. I Belgien er kunderne delt mellem fransk og hollandsk, og i Schweiz mellem tysk, fransk og italiensk. Hver af dem er et marked for sig. Svaret på et engelsk spørgsmål stillet fra Danmark er nemlig ikke det samme som svaret på det samme spørgsmål stillet på dansk.
Den slags forskelle kan du kun se, hvis Danmark på engelsk kører som sit eget marked. Slår du de to sammen, forsvinder enhver forskel mellem dem i ét samlet tal for ”Danmark”.
Vores tommelfingerregel: Undersøger mere end cirka en femtedel af et lands kunder din kategori på et andet sprog, så mål det sprog som et marked for sig. Er det færre, så brug budgettet på hovedsproget først.
Trin 2: Skriv prompts på det lokale sprog i stedet for at oversætte
En oversat prompt måler et spørgsmål, som ingen lokale stiller. Kunderne i hvert land bruger deres egne ord, deres egne referencer og har deres egne konkurrenter.
Tre ting ændrer sig, når du skriver på det lokale sprog fra bunden:
- Ordene. Navnet på kategorien er ofte et andet end den direkte oversættelse. En dansk kunde spørger hellere, om et værktøj kan se, ”om vi bliver nævnt i ChatGPT”, end bruger en oversat kategoribetegnelse som ”AI-synlighedsplatform”.
- Rammen. Kunder i forskellige lande tager udgangspunkt i forskellige ting: prisen i lokal valuta, lokale regler, lokal service eller en lokal referencekunde.
- Konkurrenterne. En lokal udfordrer kan betyde mere end den globale markedsleder. Udelader du den, læser du din placering forkert.
Her er den samme købsintention skrevet på tre måder:
|
Marked |
Oversat prompt (svag) |
Prompt skrevet lokalt (bedre) |
|---|---|---|
|
Storbritannien, engelsk |
Which platform best turns AI visibility insights into an execution plan? |
Which platform best turns AI visibility insights into an execution plan? |
|
Danmark, dansk |
Hvilken platform omsætter bedst AI-synlighedsindsigter til en eksekveringsplan? |
Hvilket værktøj kan fortælle os, hvad vi skal gøre for at blive nævnt i ChatGPT? |
|
Frankrig, fransk |
Quelle plateforme transforme le mieux les insights de visibilité IA en plan d'exécution ? |
Quel outil nous dit quoi faire pour être cité par ChatGPT ? |
De oversatte versioner er grammatisk korrekte. Men det er ikke sådan, nogen spørger. Det er et typisk første udkast: danske og franske prompts, der er oversat fra det engelske sæt, og som også lyder sådan.
Sådan skriver du prompts på det lokale sprog:
- Tag udgangspunkt i det sprog, kunderne faktisk bruger: noter fra salgsmøder, supporthenvendelser, lokale søgninger og lokale fora.
- Lad en person med sproget som modersmål skrive prompten ud fra intentionen, ikke ud fra den engelske sætning.
- Hold intentionen ens på alle markeder, så emnerne og fordelingen af prompttyper kan sammenlignes.
- Tag lokale brands med i konkurrentsættet for det marked.
- Gennemgå promptsættet hvert kvartal. Sproget ændrer sig, og det gør kundernes spørgsmål også.
Trin 3: Gør promptsættene ens og store nok
Skal markeder kunne sammenlignes, skal promptsættene også kunne. Brug de samme emner på alle markeder og den samme fordeling af Must-win-, Core- og Foundational-prompts.
Gør derefter hvert sæt stort nok til den beslutning, du vil træffe ud fra det.
Datagrundlaget bag denne blog viser, hvorfor størrelsen betyder noget. På tværs af 111 kundebrands, vi følger, svingede den daglige synlighed for medianbrandet 12,5 procentpoint mellem den bedste og den dårligste dag på en måned, uden at der var ændret i dets prompts. Og størrelsen på promptsættet betød meget:
|
Svar pr. dag |
Median for daglig standardafvigelse |
Median for forskel mellem bedste og dårligste dag |
Median for andel af dage mere end 5 procentpoint fra gennemsnittet for 30 dage |
|---|---|---|---|
|
24–94 |
4,5 procentpoint |
16,7 procentpoint |
30 % |
|
101–229 |
2,5 procentpoint |
10,3 procentpoint |
4 % |
|
230 eller flere |
2,1 procentpoint |
8,7 procentpoint |
4 % |
Kilde: 3RD's kundedata, 111 brands, 19. september–18. oktober 2026.
De brands, der havde færrest svar om dagen, svingede cirka dobbelt så meget som dem med flest. Det er fælden på små markeder: Markedet får færre prompts, fordi det betyder mindre, og så ser tallene dramatiske ud, fordi de er støjende.
Vores tommelfingerregler for størrelsen:
- Primært marked: Nok prompts pr. emne til, at du kan læse hvert emne for sig. Vurder derefter emnerne på gennemsnit over 30 dage og ikke dag for dag.
- Sekundært marked: Færre emner, men samme dybde pr. emne. Det er bedre at måle tre emner ordentligt end ni emner med to prompts hver.
- Marked, du er ved at undersøge: Et lille sæt, så du kan se, hvem der fører, og hvilke kilder der betyder noget. Rapporter endnu ikke udviklingen som en KPI.
- Alle markeder: Handl aldrig ud fra en enkelt dag. Sammenlign lige lange perioder, og marker kendte ændringer som fx en modelopdatering. Metoden står i vores guide til, hvordan du beviser, at en GEO-ændring har rykket din AI-synlighed.
Trin 4: Vælg de AI-assistenter, der betyder noget på hvert marked
Hvilke assistenter du skal måle, er en beslutning for hvert marked og ikke kun en global beslutning.
To fund fra vores kundedata taler for at måle mere end én assistent pr. marked:
- For brands, der måler mindst tre assistenter, var forskellen mellem den bedste og den dårligste assistent 16 procentpoint i median (83 brands). Mere end halvdelen (45 af 83) blev nævnt mindst dobbelt så ofte af deres bedste assistent som af deres dårligste.
- Andelen af kildehenvisninger, der peger på brandets eget site, varierer også fra assistent til assistent. I AI Mode var medianen 12,0 % og i Claude 3,2 %.
Det skal du veje på hvert marked:
- Hvilke assistenter dine kunder bruger. ChatGPT er med på næsten alle lister. Store virksomheder, der bygger meget på Microsoft, bruger Copilot. Kunder, der starter i Google, møder AI Overviews.
- Om assistenten er tilgængelig. Ikke alle funktioner lanceres i alle lande på samme tid. Tjek, at en assistent faktisk giver svar på markedet, før du sætter budget af til den.
- Budget. Hver assistent ganger det antal prompts, du betaler for. Start med to eller tre pr. marked, og tilføj flere, når du ved, hvilke der rykker sig.
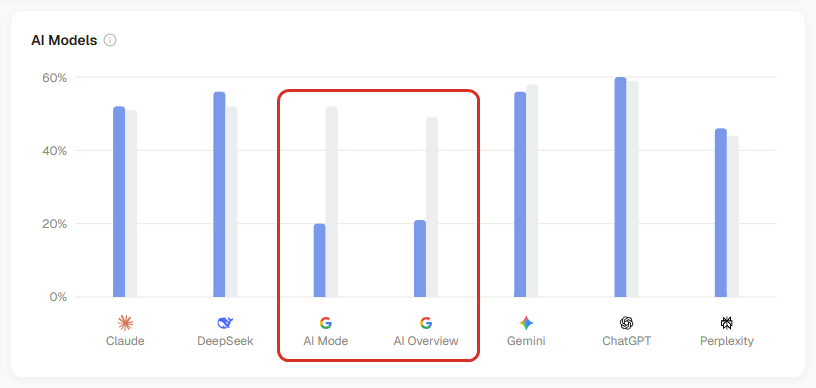
Synlighed pr. AI-model den seneste uge. ChatGPT nævner brandet i omkring 60 % af svarene, Google AI Mode og AI Overviews i omkring 20 %. Demo-workspace; brandnavne er sløret.
Trin 5: Sammenlign kildehenvisningerne på hvert marked
AI-svar bygger på kilder. Nogle af dem er globale, og andre er lokale. Det skal din outreach-liste afspejle.
Her er de kilder, AI henviste mest til ved demo-sportsbrandets spørgsmål i løbet af en uge på tværs af de fire markeder:
|
Placering |
Kilde |
Nævner brandet? |
Kildehenvisninger |
|---|---|---|---|
|
1 |
WearTesters: best basketball shoes 2026 |
Ja |
306 |
|
2 |
iRunFar: best running socks 2026 |
Nej |
302 |
|
3 |
RunRepeat: 7 best basketball shoes |
Ja |
247 |
|
4 |
Trustpilot-anmeldelsesside for brandet |
Ukendt |
216 |
|
5 |
RunRepeat: 7 best running shoes |
Ja |
212 |
|
6 |
Business Insider: best workout clothes for men |
Nej |
203 |
|
7 |
NBC News: 12 best workout socks |
Nej |
201 |
|
8 |
En dansk forhandlers blog: ”Årets bedste løbesko 2026” |
Ja |
164 |
Fra et demo-workspace, seneste uge.
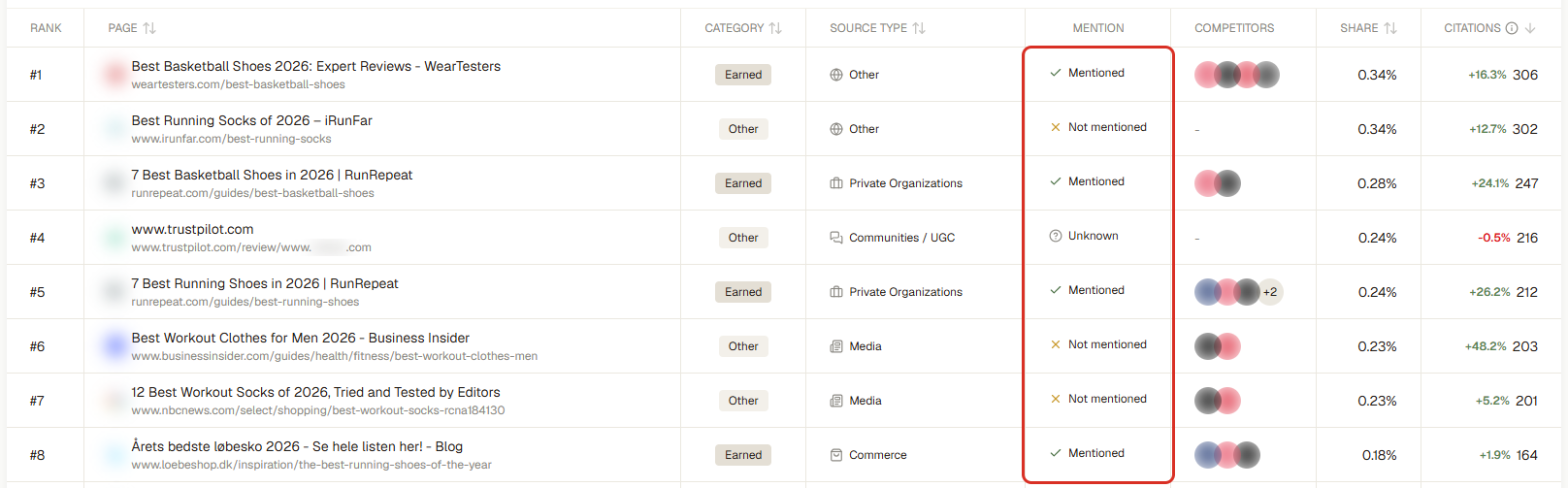
De kilder, AI henviste mest til den seneste uge, hver markeret efter, om den nævner brandet. Demo-workspace; brandnavne er sløret.
Tre ting springer i øjnene.
- Nogle kilder krydser grænser. Engelsksprogede anmeldelser og ”best of”-sider fylder det meste af toppen af listen. De har høj prioritet på alle markeder, hvor AI læser engelske kilder.
- Nogle kilder er lokale. En dansk forhandlers opslag om årets bedste løbesko ligger nr. 8. Blandt brandets egne sider henviser AI til den danske forside, en dansk kampagneside og en svensk størrelsesguide til børn. Lokale sider får kildehenvisninger på deres eget marked.
- At blive henvist til er ikke det samme som at blive nævnt. Nr. 2 på listen er en guide til løbesokker med 302 kildehenvisninger, og den nævner ikke brandet. Det gør listerne over træningstøj og træningssokker heller ikke. Målet er at være med på kilden. Det er ikke nok at vide, at den findes.
Derfor kører jeg outreach marked for marked. En liste, der virker i London, bliver måske aldrig læst i København. Metoden til at få en plads på de sider står i sådan opbygger brands den tillid og autoritet, der får AI til at anbefale dem.
Trin 6: Rapporter på tværs af markeder uden gennemsnit
Ledelsen vil bede om ét tal. Giv dem en tabel i stedet.
En enkel rapport for flere markeder:
|
Marked |
Synlighed (gns. 30 dage) |
Ændring i forhold til de foregående 30 dage |
Placering |
Fører |
Den kilde, AI henviser mest til, hvor du mangler |
Næste handling |
|---|---|---|---|---|---|---|
|
Marked A |
|
|
|
|
|
|
|
Marked B |
|
|
|
|
|
|
Regler, der holder rapporten ærlig:
- Én række pr. par af land og sprog. Slå aldrig Danmark på dansk og Danmark på engelsk sammen.
- Vægt efter omsætning, ikke efter antal prompts. Har du brug for én opsummerende linje, så vægt markederne efter deres andel af pipelinen, og skriv, at du har gjort det.
- Vis, hvor ens markederne er. Dit svageste markeds synlighed som andel af dit stærkeste fortæller ledelsen, hvor ujævnt det står til. 3RD's AI Ontology viser det som et signal, der hedder market consistency.
- Marker små markeder. Marker alle markeder, hvor promptsættet er for lille til at blive læst fra uge til uge.
- Marker modelskift. Når en assistent skifter model, kan scorerne før og efter ikke sammenlignes direkte.
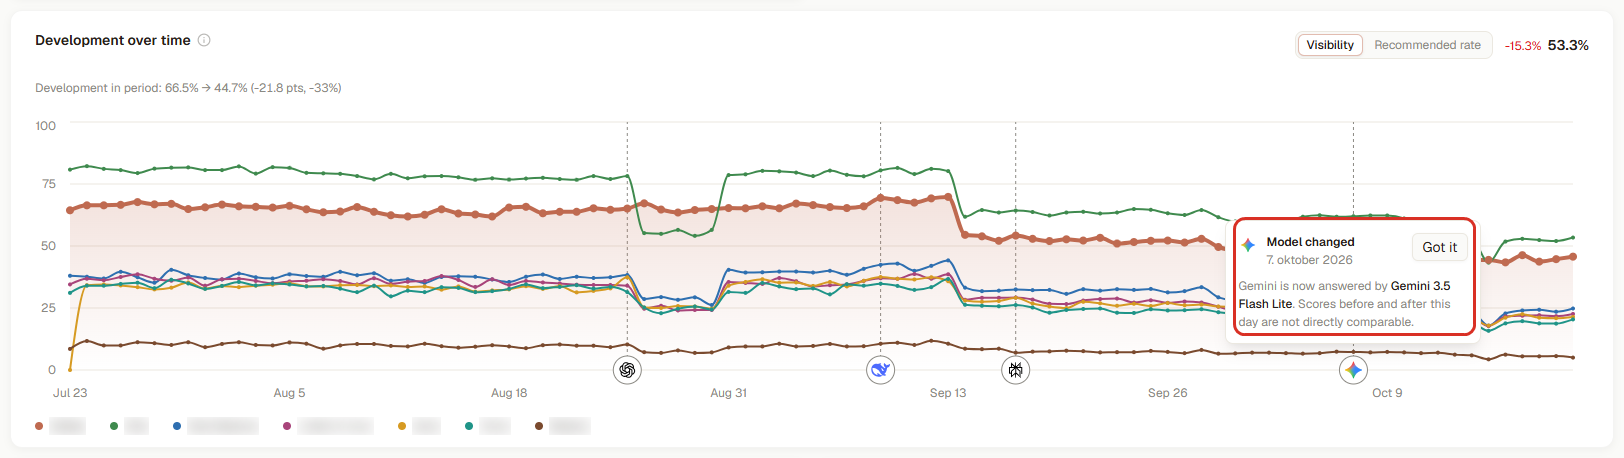
Tre måneders synlighed med markeringer af modelskift. Den 7. oktober begyndte Gemini at svare med en ny model, og 3RD gør opmærksom på, at scorerne før og efter den dag ikke kan sammenlignes direkte. Marker den slags ændringer i rapporten for hvert marked. Demo-workspace; brandnavne er sløret.
Trin 7: Læg et budget for dine prompts
Prisen på måling af AI-synlighed vokser med prompts × assistenter × markeder. Hvert marked, du tilføjer, ganger alt under det. Træf derfor beslutningerne i denne rækkefølge:
- Markeder efter omsætning.
- Emner pr. marked, med Must-win-emnerne først.
- Prompts pr. emne i den størrelse, der er beskrevet i trin 3.
- Assistenter pr. marked, startende med to eller tre.
I 3RD er et marked et par af land og sprog, og abonnementerne indeholder forskelligt antal markeder. Starter dækker ét marked, og de større abonnementer giver flere. Se, hvad der gælder lige nu, på vores prisside.
Typiske faldgruber
|
Faldgrube |
Sådan ser det ud |
Løsning |
|---|---|---|
|
Et land behandles som ét marked |
”Danmark står stille”, mens dansk stiger, og engelsk falder |
Del op efter sprog |
|
Oversatte prompts |
Grammatisk korrekte prompts, som ingen stiller |
Lad folk med sproget som modersmål skrive ud fra intentionen |
|
Samme globale konkurrentsæt overalt |
Du ser stærk ud på et marked, hvor et lokalt brand fører |
Tilføj lokale konkurrenter på hvert marked |
|
Ujævne promptsæt |
Et marked ser kun ustabilt ud, fordi det har færre prompts |
Samme emner, samme fordeling og en minimumsdybde pr. emne |
|
Et lille marked læses dag for dag |
Et ”fald” på 15 procentpoint, som bare er støj |
Læs kun små markeder på gennemsnit over 30 dage |
|
Én global outreach-liste |
Du går efter britiske lister for at vinde danske svar |
Byg listen for hvert marked ud fra de kilder, AI henviser til |
|
Ét samlet tal i overskriften |
Ledelsen ser ”stabilt”, mens et vigtigt marked styrtdykker |
Rapporter pr. marked, vægtet efter omsætning |
|
Modelskift overses |
Et spring, som i virkeligheden er en ny model |
Marker skiftet, og sammenlign perioder på samme model |
Eksempel: et sportstøjsbrand fulgt på fire markeder
Sådan ser det ud i praksis i et demo-workspace.
Markeder. Demobrandet følges i Danmark, Sverige, Storbritannien og USA i forhold til seks konkurrenter på syv AI-modeller og 207 prompts.
Diagnose pr. marked. Diagnose-siden i 3RD har en fane for hvert marked og forklarer i klart sprog, hvorfor AI ikke vælger brandet der. I Danmark ligger brandet på 43,4 %, mens føreren ligger på 49,3 %. Diagnosen peger på tre temaer: Sidernes kvalitet begrænser, hvordan AI henviser til brandet. Brandet får ujævnt med kildehenvisninger fra de medier, AI læser. Og kunder, der spørger AI, møder føreren først.
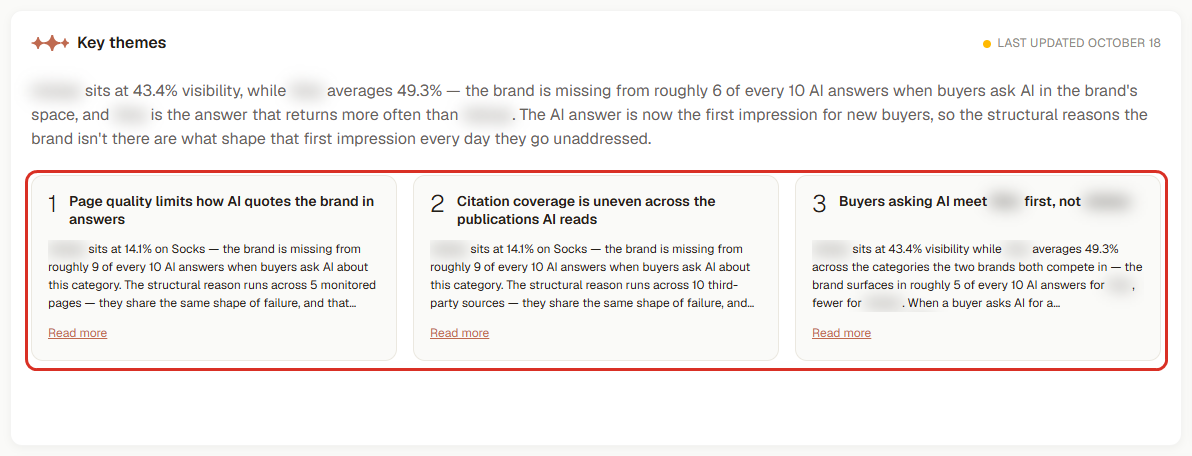
Nøgletemaer for Danmark: Brandet mangler i cirka 6 ud af 10 AI-svar, og diagnosen forklarer hvorfor. Demo-workspace; brandnavne er sløret.
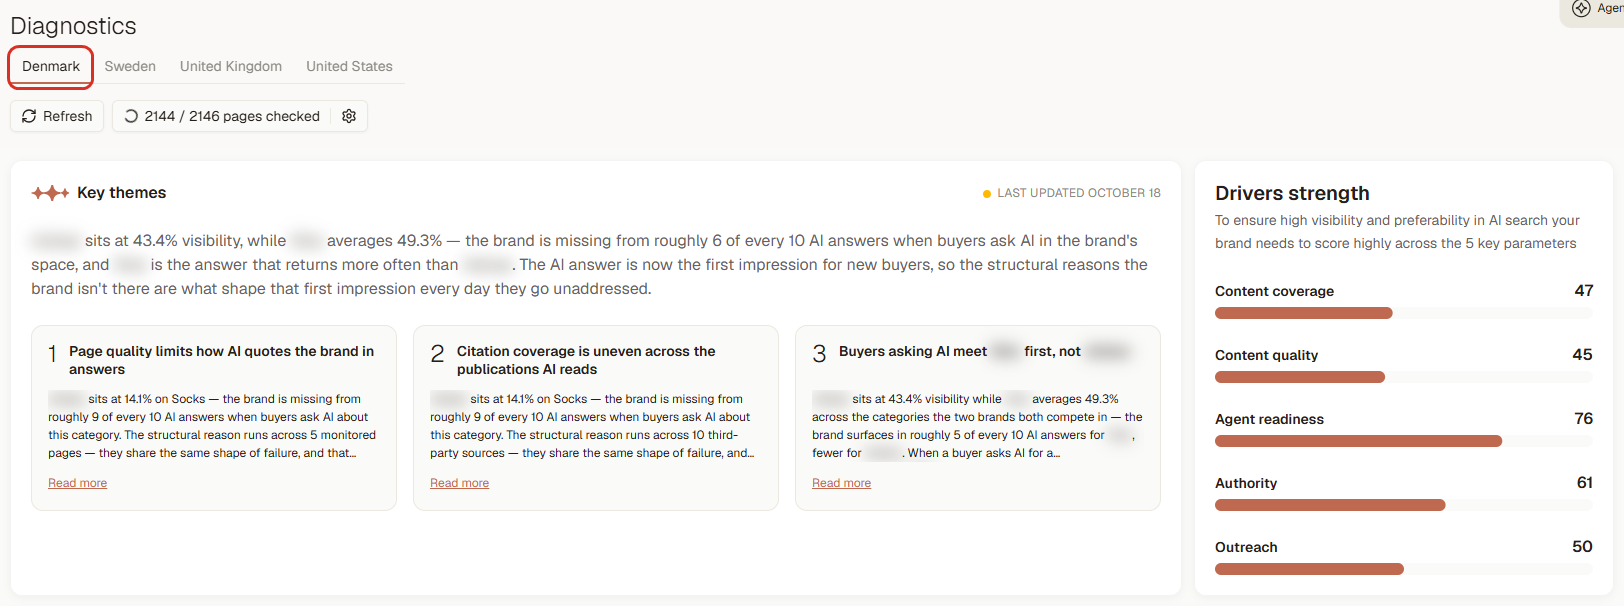
Den fulde diagnose for Danmark. Faktorscorerne for Danmark er indholdsdækning 47, indholdskvalitet 45, crawlbarhed 76, autoritet 61 og outreach 50. Hver markedsfane har sine egne. Demo-workspace; brandnavne er sløret.
Ét emne på ét marked. Går du ned i sokker i Danmark, er forskellen større. Brandet ligger på 14,1 % som nr. 2 af 7, mens føreren ligger på 21,5 %. Brandet er med i 10 af 40 prompts. Autoritet får 17 ud af 100, og AI henviser til brandet 68 gange i forhold til førerens 201. 3RD foreslår at opbygge autoritet inden for emnet gennem partnerskaber og kildehenvisninger på de sider, AI læser.
Det ændrer teamet på baggrund af diagnosen.
- Arbejdet deles op efter marked. I Danmark starter det med sidernes kvalitet og med de medier, AI læser i Danmark, fx den danske forhandlers opslag om løbesko.
- Hver side publiceres først på hovedsproget. De andre sprogversioner skrives derefter fra bunden på sproget og ikke som oversættelser. 3RD's Content Agent korrekturlæser automatisk hvert udkast, der ikke er på engelsk, så det lyder naturligt på sproget. En person i teamet med sproget som modersmål gennemgår det alligevel, før det går live.
- Åbn den samme diagnose for Sverige, Storbritannien og USA, før du planlægger arbejdet der. Kopier ikke den danske plan.
Det gør 3RD i arbejdsgangen, og det gør 3RD ikke.
- Et marked i 3RD er et geografisk område og et sprog, fx Danmark – dansk. Alle tal kan filtreres efter marked.
- Du kan bede 3RD Agent om at tilføje et marked, og den måler så det nye land på landets eget sprog. Med færdigheden ”Fix the wrong language” finder den prompts, der stadig kører på et sprog, markedet ikke længere bruger.
- Promptgeneratoren skriver prompts pr. emne og marked ud fra dit brand, dine konkurrenter og dine emner. Du gennemgår dem stadig selv, og vi anbefaler, at det er en person med sproget som modersmål, der gør det.
- 3RD Agent og Content Agent skriver udkast. Du tjekker og publicerer. Intet går live, før du har godkendt det.
Om dataene
Fundene om kunder kommer fra 3RD's egen research. Vi har analyseret 111 brands, der blev fulgt i 3RD fra 19. september til 18. oktober 2026. Det dækker over 18.000 prompts og 732.000 AI-svar, og sammenligningerne af modeller bygger på en delmængde på 60 til 83 brands. Udvalget har en overvægt af nordiske brands, og dataene er anonymiserede og samlet. Tabellerne og skærmbillederne med sportstøj kommer fra et demo-workspace: et sportstøjsbrand, der følges i forhold til seks konkurrenter i Danmark, Sverige, Storbritannien og USA på syv AI-modeller og 207 prompts. Brandnavnene er sløret, og tallene er dem, demo-workspacet viste i oktober 2026. Det er ikke kunderesultater.
FAQ
Hvor mange markeder skal jeg måle AI-synlighed på? Mål alle de par af land og sprog, der står for en mærkbar del af omsætningen, og ikke flere i starten. De fleste teams starter med deres primære marked og et eller to sekundære markeder. Når de kan læse dem pålideligt, tilføjer de flere.
Kan jeg oversætte mine engelske prompts til andre sprog? Det kan du godt, men så måler du det forkerte. Oversatte prompts er sjældent sådan, lokale kunder spørger. Lad en person med sproget som modersmål skrive hver prompt om ud fra intentionen med lokale ord, lokale konkurrenter og lokale referencer.
Svarer AI-assistenter virkelig forskelligt fra land til land? Det kan de, så tjek det. De kilder, AI henviser til, varierer fra marked til marked. Nogle, fx G2, betyder noget overalt, mens andre er lokale. Mål de samme spørgsmål fra kunderne på hvert marked, og sammenlign, hvem der fører på hvert af dem.
Hvor mange prompts skal jeg bruge pr. marked? Nok til, at du kan læse hvert emne på et gennemsnit over 30 dage. I vores kundedata svingede brands med færre end cirka 100 AI-svar om dagen omkring dobbelt så meget som brands med 230 eller flere. Små sæt er fine, når du skal undersøge et marked, men ikke til KPI'er.
Hvilke GEO-værktøjer håndterer prompts efter land og sprog? Flere platforme kan nu måle på flere markeder, men de definerer et marked forskelligt, tæller prompts forskelligt, og ikke alle skriver prompts på det lokale sprog fra bunden. 3RD behandler hvert par af land og sprog som et marked for sig. Vil du sammenligne leverandører, så læs den bedste europæiske platform til AI-synlighed og vores tjekliste til valg af platform.
Start med én beslutning: Skriv dine lande ned, og noter, hvilket sprog kunderne bruger om din kategori i hvert af dem. Den liste er din markedsopsætning. Se, hvordan 3RD måler markeder.
Head of Marketing