Recherche IA
Comment prouver qu'une action GEO a vraiment fait évoluer votre visibilité IA
Les réponses de l'IA changent d'une analyse à l'autre. Établissez une référence, utilisez des prompts témoins et comparez des périodes de même durée pour distinguer une vraie progression du bruit.
 Magnus Windeløv19 oct. 2026 · 25 min de lecture
Sommaire
Aucun outil ne peut prouver qu'une action GEO a causé une progression. Vous pouvez en revanche construire un dossier convaincant : une référence, une seule modification consignée, des prompts témoins et des analyses répétées.
En résumé : les réponses de l'IA changent d'une analyse à l'autre, si bien qu'un simple relevé avant-après ne prouve rien. Pour montrer qu'une modification a fonctionné, il vous faut quatre éléments :
- Une référence suffisamment longue pour voir de combien le chiffre varie de lui-même.
- Une seule modification, dont la date est consignée.
- Un groupe témoin de prompts que la modification n'a pas touchés.
- Deux périodes de même durée, comparées sur les mêmes prompts, les mêmes modèles et les mêmes marchés.
Si vos prompts cibles ont nettement plus progressé que le groupe témoin, et que les réponses citent ou reprennent désormais votre page, votre dossier est solide. Il s'agit toujours d'une corrélation, pas d'une causalité, et il faut le dire dans votre rapport. C'est cette honnêteté qui rend le reste crédible.
La GEO (generative engine optimization) désigne le travail qui consiste à faire nommer et citer votre marque dans les réponses de l'IA. Ce guide montre comment la tester correctement : la méthode pas à pas, les erreurs qui produisent de fausses victoires et le déroulement du test dans 3RD, à partir d'un espace de démonstration.
Pourquoi c'est important aujourd'hui
Prenons l'exemple d'un espace de démonstration. Une marque de sport y est suivie par rapport à six concurrents au Danemark, en Suède, au Royaume-Uni et aux États-Unis, sur sept modèles d'IA et 207 prompts. La semaine dernière, elle a été nommée dans 44,5 % des réponses de l'IA et s'est classée deuxième sur sept marques. Quand l'équipe demande à 3RD Agent sur quoi se concentrer en priorité pour les chaussures de running, la réponse commence par une priorité : mettre les caractéristiques et les arguments des chaussures sous les yeux des clients.
L'équipe s'apprête donc à publier beaucoup de contenu, et elle doit savoir quelle part de ce travail fait réellement bouger les choses. Si elle ne sait pas distinguer une vraie progression du bruit, elle redoublera d'efforts sur les mauvaises pistes. C'est le problème que rencontre aujourd'hui chaque équipe marketing qui fait de la GEO.
Une responsable marketing l'a résumé lors d'un échange avec nous : « Nous faisons toutes ces choses, elles semblent être les bonnes, mais comment en voir concrètement l'impact ? »
Pourquoi il est difficile de savoir si « ça a marché » dans la recherche IA
Sur Google, vous pouviez vérifier un classement avant et après une modification. Les classements étaient assez stables, donc un mouvement avait du sens. Les réponses de l'IA ne fonctionnent pas ainsi, pour trois raisons.
- Les réponses varient. Les modèles d'IA sont probabilistes : le même prompt peut obtenir une réponse différente demain, avec d'autres marques et d'autres sources.
- Le changement prend du temps. Les modèles réexplorent et réapprennent à leur propre rythme. Comptez de quelques jours à quelques semaines entre la publication et un changement mesurable.
- Beaucoup de choses bougent en même temps. Les concurrents publient, les modèles sont mis à jour et la demande varie selon les saisons. Chacun de ces facteurs peut faire bouger votre chiffre la même semaine que votre modification.
Voici ce que cela donne en pratique : trois mois de visibilité quotidienne pour une marque et pour le leader de sa catégorie, dans un espace de démonstration.
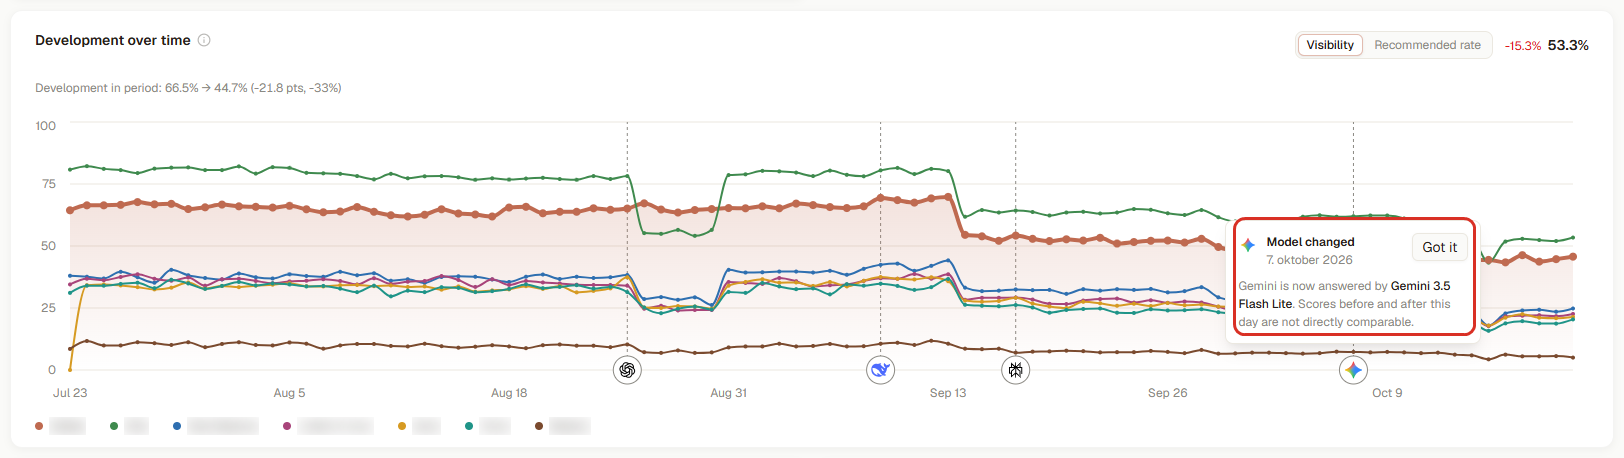
Trois mois de visibilité quotidienne. La marque passe de 66,5 % à 44,7 %, et le leader d'environ 80 % à environ 53 %. La fenêtre du 7 octobre signale que Gemini a changé de version de modèle, ce qui crée une rupture dans la série. Espace de démonstration ; noms de marques floutés.
Deux choses sautent aux yeux. La marque a perdu 21,8 points sur la période, mais le leader a reculé lui aussi : c'est toute la catégorie qui a bougé, pas seulement cette marque. Le graphique comporte par ailleurs plusieurs marqueurs de changement de modèle. Le 7 octobre, Gemini a commencé à répondre avec Gemini 3.5 Flash Lite. 3RD le signale sur la chronologie et précise que les scores d'avant et d'après cette date ne sont pas directement comparables. Si vous aviez publié une page le 6 octobre, tout changement observé sur Gemini aurait tout aussi bien pu venir du nouveau modèle.
La question n'est donc pas « le chiffre a-t-il augmenté ? », mais « le chiffre a-t-il augmenté davantage qu'il ne l'aurait fait sans notre modification ? ». La suite de ce guide répond à cette seconde question.
Ne la confondez pas avec celle du chiffre d'affaires. On peut répondre à la question « notre travail a-t-il fait évoluer notre visibilité IA ? ». On ne peut répondre qu'en partie à la question « la visibilité IA nous a-t-elle rapporté de l'argent ? », car la plupart des réponses de l'IA ne génèrent aucun clic. Ce sujet fait l'objet d'un guide à part : comment relier les recommandations et les citations de l'IA au chiffre d'affaires.
Quelle est l'ampleur du bruit ? Les données de 111 marques
Nous voulions chiffrer le « bruit normal ». Nous l'avons donc mesuré sur les marques que nous suivons.
Sur 111 marques et 732 000 réponses de l'IA entre le 19 septembre et le 18 octobre 2026 :
- La visibilité de la marque médiane a varié de 12,5 points entre son meilleur et son pire jour en un seul mois, sans que ses prompts changent.
- Pour 7 marques sur 10 (77 sur 111), au moins un relevé quotidien s'écartait de plus de 5 points de la moyenne de la marque sur 30 jours.
- Pour environ 1 marque sur 4 (30 sur 111), un relevé quotidien s'en écartait de plus de 10 points.
- Les petits ensembles de prompts sont deux fois plus bruités. Les marques qui recueillaient moins d'une centaine de réponses par jour présentaient un écart-type quotidien médian de 4,5 points, contre 2,1 pour celles qui en recueillaient 230 ou plus.
|
Réponses par jour |
Amplitude médiane (meilleur jour moins pire jour) |
Part des jours à plus de 5 points de la moyenne sur 30 jours (médiane) |
|---|---|---|
|
- |
- |
- |
|
24–94 |
16,7 points |
30 % |
|
101–229 |
10,3 points |
4 % |
|
230–2 501 |
8,7 points |
4 % |
Relisez la première ligne. Si vous suivez un petit ensemble de prompts, près d'un jour sur trois s'écarte de plus de 5 points de votre moyenne réelle. Un seul relevé avant et après une modification, c'est presque un pile ou face.
Ce qu'il vous faut d'abord
Avant de modifier quoi que ce soit, réunissez ces éléments :
|
Il vous faut |
Pourquoi |
|---|---|
|
- |
- |
|
Un ensemble de prompts figé |
Les questions que vos clients posent à l'IA, formulées comme ils les posent. Si les prompts changent en cours de test, les périodes ne sont plus comparables. |
|
Des analyses répétées |
Chaque prompt est envoyé à chaque modèle à intervalles réguliers, idéalement chaque jour. Une réponse par jour et par modèle est le minimum pour dégager une tendance. |
|
Au moins deux semaines d'historique |
Impossible de juger une modification tant que vous ne savez pas de combien le chiffre varie quand vous ne faites rien. |
|
Un ensemble de concurrents suivis |
Vos concurrents sont votre meilleur témoin. Si tout le monde a progressé, c'est le modèle qui a changé, pas votre page. |
|
L'accès aux réponses brutes |
Le chiffre vous dit qu'un changement a eu lieu. Les réponses vous disent ce qui a changé. |
|
Un journal des modifications |
La date et l'URL de chaque modification : pages, outreach, corrections techniques. |
Si vous interrogez ChatGPT à la main aujourd'hui, vous pouvez quand même appliquer cette méthode, mais il vous faudra beaucoup d'analyses manuelles. Au vu des chiffres sur le bruit présentés plus haut, c'est la principale raison pour laquelle les équipes passent à un outil.
Étape 1 : notez ce que vous attendez, avant de livrer
Avant de publier quoi que ce soit, écrivez une phrase :
« La publication de [page] fera progresser [indicateur] sur [ces prompts] sur le marché [marché], sur [modèles], d'ici [semaines], par rapport à [prompts témoins]. »
Voici un exemple rédigé pour l'espace de démonstration : « La publication d'une page sur les meilleures chaussures de running stables pour préparer un marathon la fera citer sur nos prompts consacrés aux chaussures stables au Danemark d'ici six semaines, par rapport à nos prompts consacrés aux chaussettes. »
L'écrire à l'avance vous empêche de fouiller ensuite les données à la recherche du moindre chiffre en hausse. Choisissez un indicateur principal :
- Les citations de la page, si la modification est une page nouvelle ou réécrite. C'est le signal le plus direct que l'IA a utilisé votre travail.
- La visibilité (la part des réponses qui mentionnent votre marque), si vous voulez savoir si vous faites partie de la conversation.
- La position ou le taux de recommandation, si vous êtes déjà mentionné et voulez être choisi.
Un repère : jugez une page toute nouvelle d'abord sur les citations. Les mentions viennent plus tard, et lentement pour une marque qui part de presque zéro.
Étape 2 : choisissez les prompts cibles et un groupe témoin
Les prompts cibles sont les questions que la modification doit vous faire gagner. Gardez une liste resserrée : cinq à quinze prompts sur un même sujet se lisent plus facilement que cinquante.
Les prompts témoins sont des questions sur lesquelles votre modification ne devrait pas avoir d'effet. De bons prompts témoins :
- portent sur un autre sujet, auquel votre nouvelle page ne répondra pas
- ont un poids commercial comparable (comparez des Must-win avec des Must-win, pas avec des questions de recherche générales)
- sont analysés sur les mêmes modèles et les mêmes marchés
Regrouper vos prompts par sujet facilite le travail : chaque sujet devient naturellement un groupe cible ou un groupe témoin.
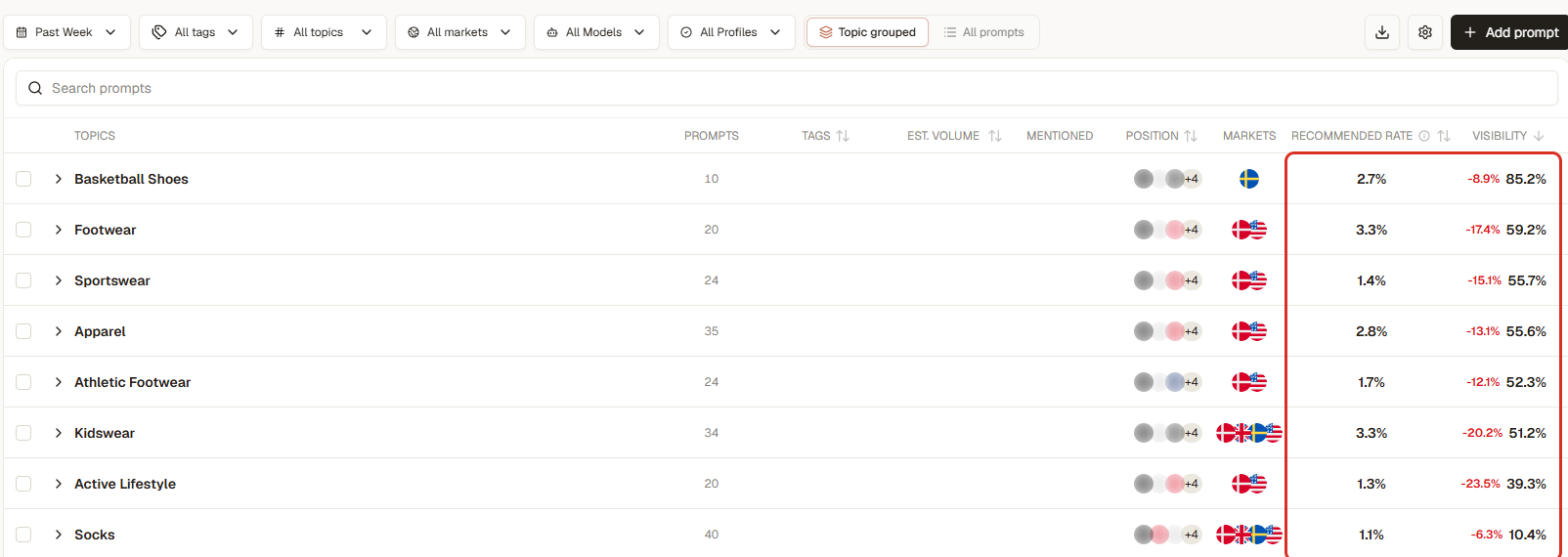
Des prompts regroupés en huit sujets, des chaussures de basket à 85,2 % de visibilité aux chaussettes à 10,4 %, chacun suivi par marché. Quand vous publiez pour un sujet, les autres servent de groupe témoin. Espace de démonstration ; noms de marques floutés.
Ajoutez un second témoin : la visibilité de vos concurrents sur les prompts cibles. Si vous avez gagné 6 points et que chaque concurrent en a gagné autant, c'est probablement une mise à jour du modèle qui a fait progresser tout le monde.
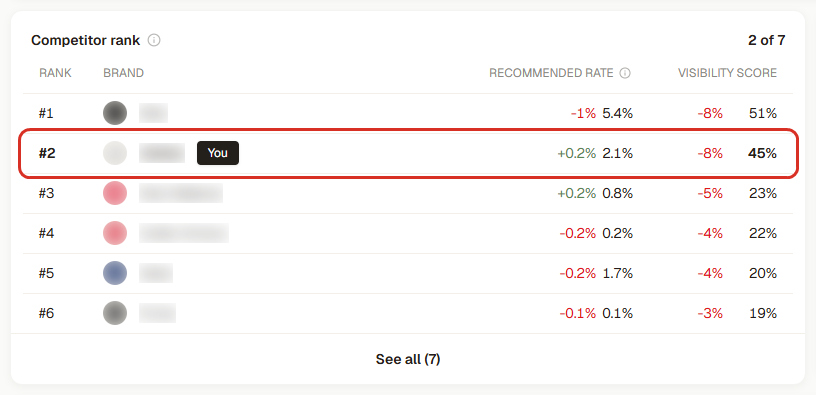
Le classement des concurrents la semaine dernière : la marque est deuxième sur sept avec 45 %, derrière un leader à 51 %. Si vos concurrents évoluent comme vous, c'est le modèle qui a changé, pas votre page. Espace de démonstration ; noms de marques floutés.
Étape 3 : mesurez une référence qui fait apparaître le bruit
Analysez l'ensemble de prompts pendant au moins deux semaines avant la modification, idéalement quatre. Regardez la dispersion, pas seulement la moyenne.
Les données des 111 marques montrent pourquoi. La marque médiane varie de 12,5 points entre son meilleur et son pire jour du mois. L'un de nos clients, Manyone, a vu sa visibilité quotidienne osciller entre 1,4 % et 8,5 % en un seul mois. Avec un relevé avant une modification et un autre après, vous auriez pu « prouver » un gain ou une perte de 6 points sans rien avoir changé.
Deux notions statistiques simples vous aideront :
- Raisonnez sur une période, pas sur une journée. Comparez des périodes de 14 ou 28 jours. Le chiffre d'une seule journée ne veut pas dire grand-chose.
- Comptez vos réponses. Chaque chiffre de visibilité repose sur une base. Dans l'espace de démonstration, les 44,5 % de visibilité de la semaine dernière reposent sur 4 051 mentions dans 9 105 réponses. Moins la période compte de réponses, plus l'écart doit être important pour être crédible.
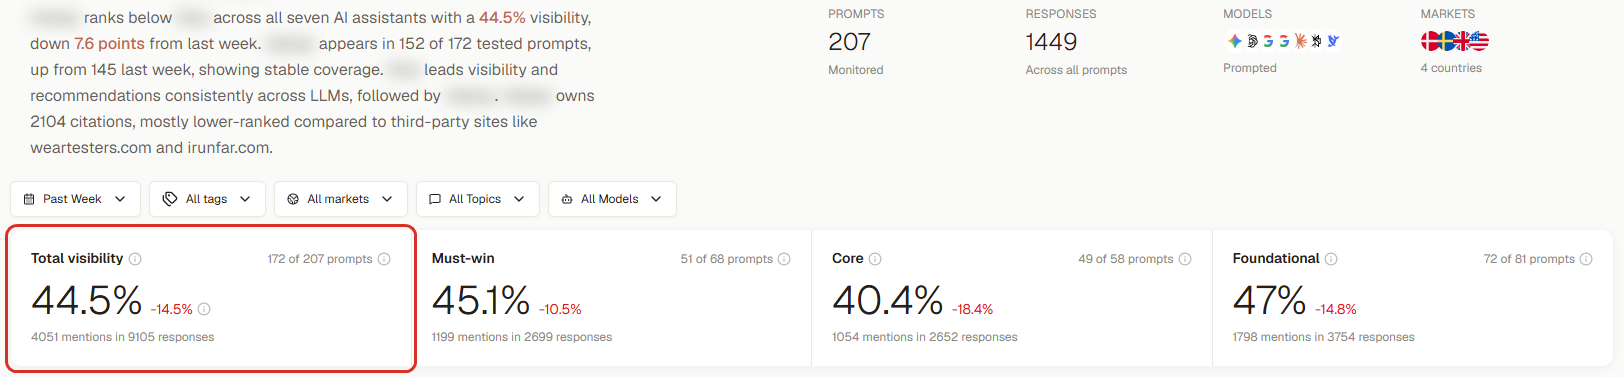
La visibilité de la semaine dernière : 44,5 %, soit 4 051 mentions dans 9 105 réponses, répartie entre Must-win (45,1 %), Core (40,4 %) et Foundational (47 %). Chaque score affiche sa base. Espace de démonstration ; noms de marques floutés.
Un ordre de grandeur, pour une visibilité réelle d'environ 20 % :
|
Réponses par période |
Écart que le bruit seul peut produire (environ 95 % du temps) |
|---|---|
|
- |
- |
|
50 |
± 11 points |
|
100 |
± 8 points |
|
400 |
± 4 points |
|
1 000 |
± 2,5 points |
Il s'agit de la marge d'erreur classique d'une proportion. Considérez-la comme un plancher. Les réponses d'un même jour et d'un même modèle ont tendance à évoluer ensemble, si bien que le bruit réel est généralement plus important, ce que montrent justement les données des 111 marques. L'enseignement est simple : plus vous avez de prompts, de modèles et de jours, plus votre lecture est précise. Cinq prompts vérifiés à la main pendant une semaine ne permettent de détecter qu'un très grand bond.
Étape 4 : livrez une seule modification et notez la date
Ne modifiez qu'une chose à la fois sur les prompts cibles. Si vous publiez une page, démarchez trois publications et corrigez votre robots.txt la même semaine, vous ne saurez pas ce qui a fonctionné.
Vous pouvez mener plusieurs modifications en parallèle si elles visent des groupes de prompts différents. Chaque groupe constitue alors son propre test.
Consignez la modification le jour de sa livraison :
- la date
- l'URL ou la cible de l'outreach
- les prompts qu'elle doit faire bouger
- ce que vous en attendez (étape 1)
Notez aussi tout ce qui s'est produit cette semaine-là sans dépendre de vous : un changement de version de modèle, le lancement d'un concurrent, une actualité dans votre catégorie. Vous en aurez besoin pour interpréter le résultat.
Étape 5 : vérifiez que l'IA peut réellement accéder à la modification
Un test peut échouer en silence si les modèles ne voient jamais votre page. Avant de lancer le chronomètre, vérifiez que :
- La page est en ligne et n'est pas bloquée. Pas de `noindex`, pas de blocage dans le robots.txt, et pas de protection anti-bots qui arrête les robots d'exploration des IA.
- Elle figure dans votre sitemap, avec une date de dernière modification exacte.
- Elle se lit sans JavaScript. Certains robots d'exploration des IA n'exécutent pas les scripts : le texte essentiel doit se trouver dans le HTML.
- Elle est liée depuis votre site. Une page orpheline est découverte tard, voire jamais.
Même des sites bien tenus échouent souvent à ce contrôle. Dans l'espace de démonstration, le rapport analyse 2 144 pages et signale 15 problèmes. Le titre ou la description manquent sur 1 315 pages. Le bouton d'achat ne fonctionne qu'en JavaScript, si bien que les agents ne trouvent pas comment acheter. Les produits n'ont pas d'identifiants comme le GTIN ou le SKU.
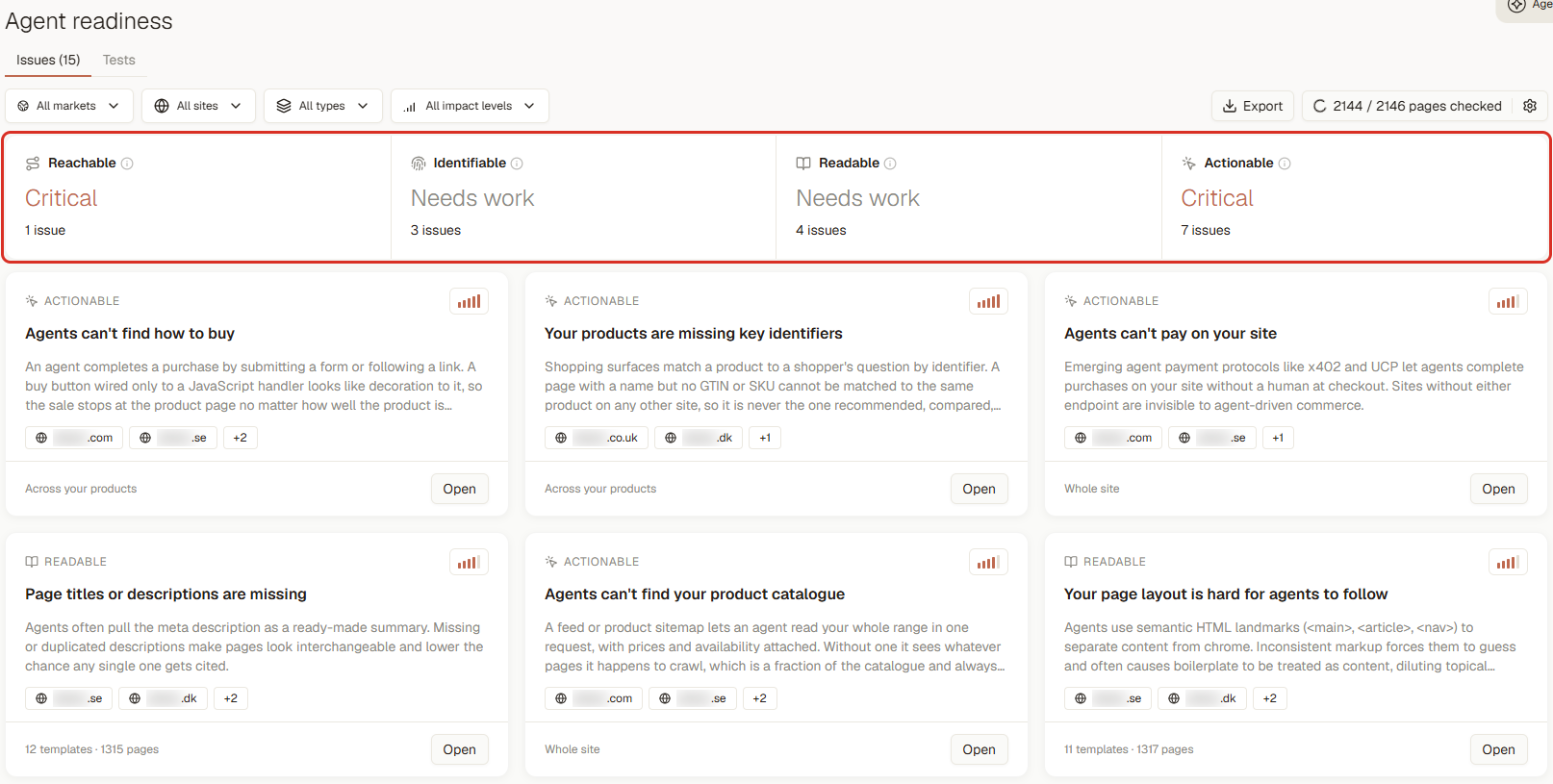
Le rapport Agent readiness du site de la marque de démonstration : 15 problèmes, dont deux catégories marquées « Critical ». Corrigez les problèmes bloquants avant de juger un test qui en dépend. Espace de démonstration ; noms de marques et de domaines floutés.
Faites partir votre période de test du jour où l'IA peut accéder à la page, pas du jour où vous l'avez rédigée.
Étape 6 : surveillez d'abord les signaux précurseurs
Les changements apparaissent dans un ordre prévisible. Suivez-les dans cet ordre pour ne pas déclarer un test perdu trop tôt :
- La page est citée. Les réponses issues d'une recherche sur le web commencent à indiquer votre URL comme source. Cela peut se produire quelques jours après l'exploration.
- La part de citations augmente. Vos pages représentent une part plus importante des sources utilisées par l'IA pour ces prompts. La part de citations progresse souvent avant la visibilité.
- Les mentions augmentent. L'IA commence à nommer votre marque dans davantage de réponses.
- La position et les recommandations s'améliorent. Vous montez dans la liste, et l'IA commence à conseiller aux clients de vous choisir.
Les étapes 1 et 3 peuvent être très éloignées. Dans l'espace de démonstration, la marque est nommée dans 44,5 % des réponses, mais ses propres pages ne représentent que 2,5 % des citations de sa catégorie. Les pages de la marque que l'IA cite le plus sont deux pages d'accueil, une page de campagne, un guide des tailles pour enfants et un guide d'achat.
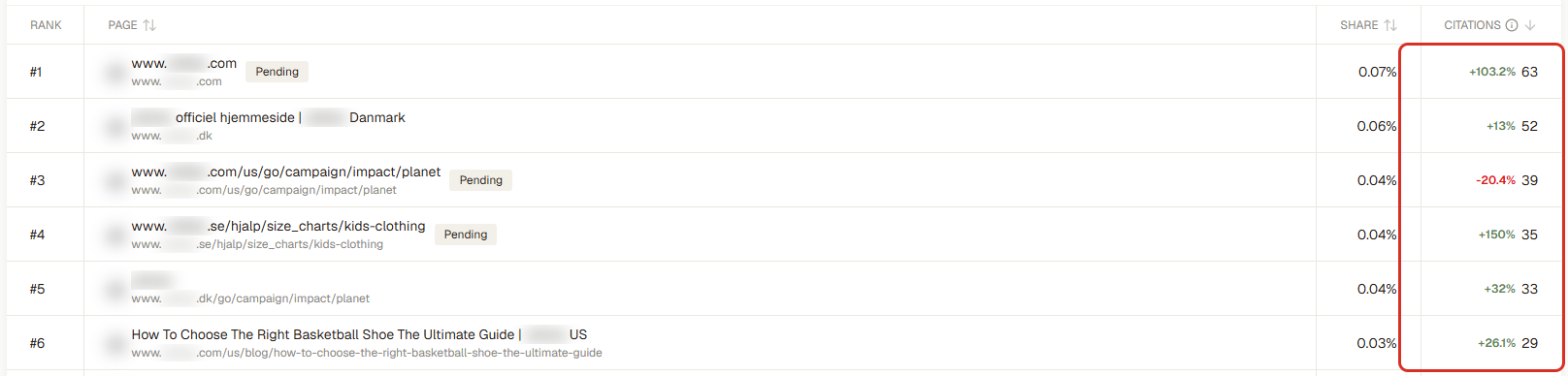
Les pages de la marque les plus citées la semaine dernière : la page d'accueil internationale (63 citations), la page d'accueil danoise (52), une page de campagne, un guide des tailles pour enfants en suédois et un guide d'achat. Citations et mentions sont des signaux différents, qui n'évoluent pas au même rythme. Espace de démonstration ; noms de marques floutés.
Si l'étape 1 ne se produit toujours pas au bout de quatre à six semaines, le problème tient probablement à l'accès ou à la pertinence, pas au texte. Revenez à l'étape 5, ou vérifiez que la page répond directement au prompt.
Gardez en tête la différence entre recherche en direct et entraînement. Les réponses qui s'appuient sur une recherche web peuvent refléter votre page peu après son exploration. Celles qui reposent sur ce que le modèle a appris à l'entraînement ne changent qu'à la sortie d'une nouvelle version du modèle. C'est une raison de plus pour lire les résultats modèle par modèle.
Étape 7 : comparez des périodes de même durée, cible par rapport au témoin
Place à la comparaison. Utilisez le même nombre de jours avant et après, les mêmes prompts, les mêmes modèles et les mêmes marchés. Écartez la première semaine qui suit la livraison si vous savez que l'exploration prend du temps.
Calculez l'évolution de chaque groupe, puis l'écart entre les deux :
|
|
Avant (28 jours) |
Après (28 jours) |
Évolution |
|---|---|---|---|
|
- |
- |
- |
- |
|
Prompts cibles |
12 % |
21 % |
+9 points |
|
Prompts témoins |
15 % |
17 % |
+2 points |
|
Écart |
|
|
+7 points |
Chiffres fictifs, à titre d'illustration.
Ces +7 points constituent votre effet estimé : la part de la hausse que le groupe témoin n'a pas connue. Les analystes parlent de « double différence » (difference-in-differences). C'est la méthode classique pour traiter le problème du « tout le reste a changé aussi ».
Vérifiez ensuite la cohérence du résultat :
- Les +7 points dépassent-ils le bruit observé pendant la période de référence ? Si votre référence variait de ±8 points, le résultat n'est pas encore convaincant. Prolongez la période.
- Les prompts cibles étaient-ils déjà orientés à la hausse avant la modification ? Si oui, une partie de la hausse était déjà en cours.
- Les concurrents ont-ils évolué de la même façon ? S'ils ont tous progressé, cherchez une mise à jour du modèle.
- La progression concerne-t-elle tous les modèles, ou un seul ? Une progression sur un seul modèle est réelle, mais présentez-la comme telle.
- Un changement de modèle a-t-il eu lieu pendant l'une des deux périodes ? Si oui, coupez la comparaison à cette date ou prolongez la période au-delà.
Un repère : ne parlez de résultat « en mouvement » que si les prompts cibles dépassent le groupe témoin de plus de 5 points. Dans la fourchette de ±5 points, il n'y a « pas encore de progression ».
Étape 8 : lisez les réponses pour confirmer le mécanisme
Les chiffres vous disent que quelque chose a changé. Les réponses vous disent si votre modification en est la raison.
Ouvrez les réponses à vos prompts cibles, avant et après :
- Votre nouvelle page figure-t-elle parmi les sources citées ?
- La réponse reprend-elle un fait, un chiffre ou une formulation qui n'existe que sur votre page ?
- Un concurrent a-t-il disparu, ou une nouvelle source que vous n'avez pas touchée est-elle apparue ?
Une astuce pratique : placez sur la nouvelle page un fait précis, exact et facile à citer, qui n'est publié nulle part ailleurs, par exemple un chiffre tiré de vos propres données. Quand les réponses commencent à le reprendre, vous avez la preuve directe que l'IA a lu votre page. Les chiffres sur le bruit issus des 111 marques, dans cet article, proviennent des recherches de 3RD. Si vous les voyez dans une réponse de l'IA, vous saurez d'où ils viennent.
Étape 9 : rendez compte du résultat en toute honnêteté
Rédigez le résultat en un paragraphe lisible par la direction :
« Nous avons publié une page comparative le 2 septembre. Au cours des 28 jours suivants, la visibilité sur les 8 prompts cibles est passée de 12 % à 21 %. Nos autres prompts Must-win ont gagné 2 points sur la même période : les prompts cibles ont donc progressé de 7 points de plus. ChatGPT cite désormais la nouvelle page dans 40 % des réponses à ces prompts. Les concurrents sont restés stables. Nous y voyons un effet probable de la page. Ce n'est pas une preuve de causalité, car les modèles et les concurrents évoluent eux aussi. »
Exemple fictif, à titre d'illustration.
C'est cette dernière phrase qui vous protège. Les clients les plus expérimentés avec qui nous échangeons ne demandent pas de preuve. Ils vérifient si vous allez prétendre en avoir une.
Les pièges les plus courants
Voici les erreurs que nous observons le plus souvent dans les comptes que nous suivons.
|
Erreur |
Ce qui se passe |
Solution |
|---|---|---|
|
- |
- |
- |
|
Le relevé unique |
Un relevé avant, un relevé après. Avec une variation mensuelle médiane de 12,5 points, vous « prouverez » des gains et des pertes qui n'ont jamais eu lieu. |
Comparer des périodes de 14 ou 28 jours. |
|
L'ensemble de prompts qui bouge |
De nouveaux prompts modifient la moyenne, même si rien d'autre n'a bougé. |
Figer les prompts cibles et témoins pendant le test. |
|
L'ensemble de concurrents qui bouge |
Le rang dépend des concurrents suivis. En ajouter un modifie votre rang sans que les réponses changent. |
Garder le même ensemble de concurrents pendant le test. |
|
L'accumulation |
Trois modifications sur les mêmes prompts en une semaine. Vous saurez que quelque chose a marché, mais pas quoi. |
Une seule modification à la fois par groupe de prompts. |
|
Le verdict prématuré |
Juger une modification de contenu au bout d'une semaine. |
Lui laisser quatre à six semaines, et regarder d'abord les citations. |
|
Le total agrégé |
Une hausse sur les prompts de recherche masque une baisse sur les prompts les plus proches de l'achat. |
Lire les prompts Must-win séparément. |
|
La prévision prise pour un résultat |
Un score d'impact estimé est présenté comme une progression obtenue. |
Séparer « attendu » et « mesuré » dans deux colonnes distinctes. |
|
La lecture limitée à la visibilité |
La page est citée, les mentions n'ont pas encore bougé, et le test est arrêté. |
Suivre les citations comme signal précurseur. |
|
Le changement de modèle |
Une version de modèle change en cours de test, et la progression vient en réalité du nouveau modèle. |
Noter les changements de modèle et couper les périodes à cette date. |
Exemple concret dans 3RD : la réécriture d'une page
Voici une vraie tâche issue d'un espace de démonstration. Elle ne montre pas le résultat qu'une équipe espérerait, et c'est précisément ce qui la rend utile.
La modification. 3RD a signalé une page danoise de déstockage de chaussures de running comme tâche de qualité du contenu, intitulée « Optimize lob sko outlet ». La page a été réécrite et la tâche marquée comme résolue.
Ce que 3RD a mesuré ensuite. Quand une tâche est terminée, 3RD mesure ce qui a bougé entre ce jour-là et le dernier relevé :
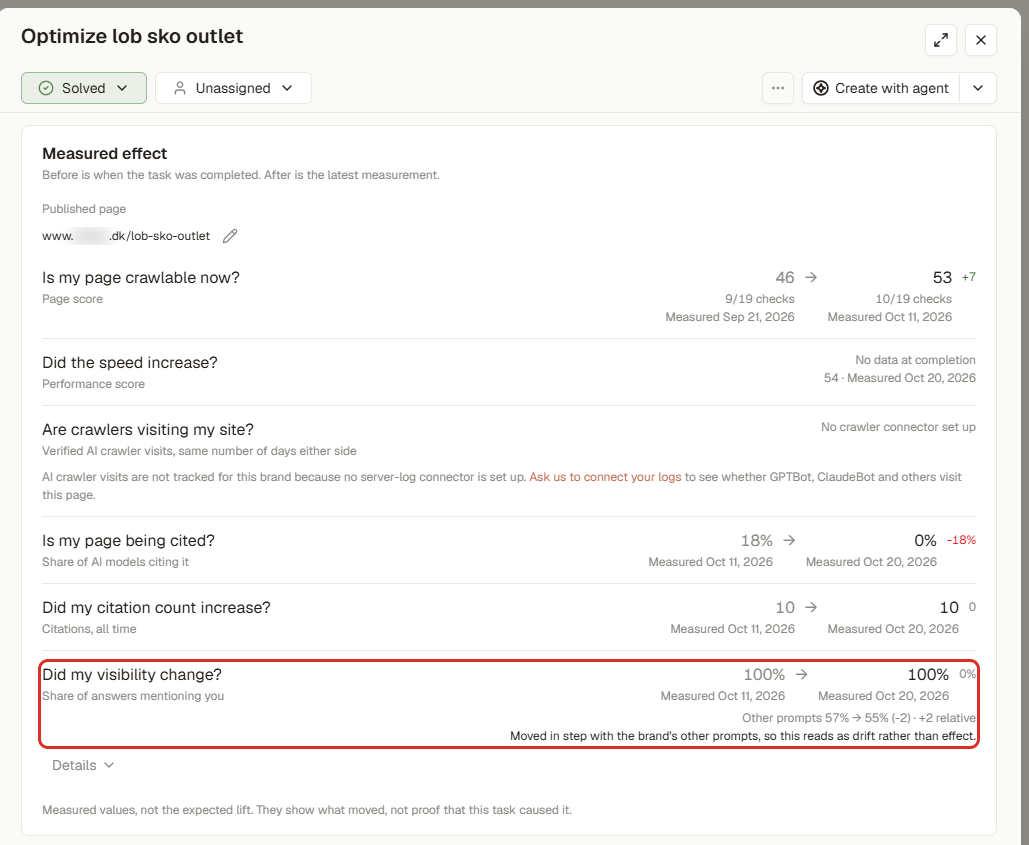
L'effet mesuré de la réécriture d'une page. Le score de la page est passé de 46 à 53, mais la visibilité a évolué au même rythme que les autres prompts de la marque : 3RD y voit donc une dérive plutôt qu'un effet. Espace de démonstration ; noms de marques floutés.
- La page s'est-elle améliorée ? Son score est passé de 46 à 53, avec 10 contrôles réussis sur 19 au lieu de 9.
- La page est-elle citée ? La part des modèles d'IA qui la citent est passée de 18 % à 0 %. Le nombre de citations est resté à 10.
- La visibilité a-t-elle évolué ? Sur les prompts de la tâche, elle est restée à 100 %. Sur la même période, les autres prompts de la marque sont passés de 57 % à 55 %. Cela fait 2 points de mieux que le groupe témoin, bien en deçà du bruit. 3RD le formule sans détour : la page « a évolué au même rythme que les autres prompts de la marque, il s'agit donc d'une dérive plutôt que d'un effet ».
La note en bas de l'écran le résume le mieux : ce sont des valeurs mesurées, pas la progression attendue. Elles montrent ce qui a bougé, et non la preuve que cette tâche en est la cause.
Comment l'interpréter. Selon les contrôles de 3RD, la réécriture a amélioré la page, mais elle n'a produit aucun effet visible dans les réponses. Les prompts étant déjà à 100 %, ils n'avaient aucune marge de progression, et moins de modèles ont cité la page ensuite. La réécriture d'une seule page ne constitue pas encore un résultat. Consignez-la comme « pas encore de progression » et continuez à surveiller les citations.
C'est un résultat sur lequel vous pouvez agir. Sans groupe témoin, l'équipe aurait pu annoncer « score de la page en hausse de 7, visibilité maintenue à 100 % » et crier victoire.
Comment le reste de la boucle se déroule dans 3RD :
- Fixez l'objectif. Créez un Playbook avec un objectif pour un groupe de prompts, par exemple « améliorer la visibilité sur les prompts comparatifs Must-win au Danemark, sur ChatGPT et Google AI Overviews ». L'objectif fixe les prompts, le marché, les modèles et l'indicateur : c'est l'étape 1, mise par écrit.
- Lisez la référence et le bruit. Dans la Vue d'ensemble, passez la période à 90 jours pour voir comment le chiffre évolue de lui-même, avec les changements de modèle signalés sur la chronologie.
- Livrez le travail et marquez la date. Prenez la tâche en tête du Playbook. 3RD Agent rédige la page à partir du brief de la tâche ; vous la vérifiez et la publiez sur votre propre site. Marquez le lancement sur la chronologie pour pouvoir ensuite lire les chiffres au regard de cette date.
- Vérifiez que l'IA peut y accéder. Le rapport Préparation aux agents IA teste si les robots d'exploration des IA peuvent atteindre et lire vos pages.
- Servez-vous de vos témoins. Le classement des concurrents montre vos concurrents sur les mêmes prompts. Filtrez la Vue d'ensemble par sujet ou par type de prompt pour comparer votre groupe cible aux prompts que la modification n'a pas touchés. Quand une tâche est clôturée, son effet mesuré compare pour vous les prompts visés aux autres prompts de la marque.
- Confirmez dans les réponses. Ouvrez les réponses aux prompts cibles et vérifiez si votre page figure parmi les citations.
- Rendez compte. Transformez la période en rapport aux couleurs de votre marque pour la direction. Pour mener votre propre analyse, récupérez les données via l'Export API ou le connecteur Looker Studio.
Ce que 3RD ne fait pas : publier à votre place, ou affirmer que votre travail a causé le changement. C'est vous qui décidez quoi publier, et vous qui lisez le résultat au regard de vos témoins.
Les données : l'avant-après, c'est presque un pile ou face
Nous avons aussi regardé ce qui se passe chez nos clients une fois les tâches terminées. Nous avons retenu les 117 tâches terminées, réparties sur 44 marques, pour lesquelles 3RD a mesuré les prompts visés par rapport à un groupe témoin composé des prompts non travaillés de la même marque (taille médiane du groupe témoin : 37 prompts).
|
Résultat par rapport au groupe témoin |
Tâches |
Part |
|---|---|---|
|
- |
- |
- |
|
Progression de plus de 5 points |
34 |
29 % |
|
Dans la fourchette de ±5 points (« pas de progression ») |
52 |
44 % |
|
Recul de plus de 5 points |
31 |
26 % |
La variation relative médiane était nulle.
Cela ne veut pas dire que le travail ne compte pas. La visibilité par tâche repose sur une poignée de prompts, et la première partie a montré à quel point les petits échantillons sont bruités. Cela veut dire qu'un simple relevé avant-après ne permet pas de distinguer une vraie progression de la variation normale. Il vous faut le groupe témoin, la période et de la patience.
C'est aussi pourquoi nous ne promettons jamais qu'« une tâche vous fera gagner X points ». Une estimation vous dit par quoi commencer. Seule la mesure vous dit ce qui s'est passé.
Quel outil peut prouver qu'une action GEO a fait évoluer votre visibilité ?
Aucun outil ne peut prouver une causalité à partir des seules réponses de l'IA. Méfiez-vous de ceux qui le prétendent. Ce qu'un outil peut faire, c'est vous fournir les éléments d'un dossier solide. Recherchez :
|
Fonctionnalité |
Pourquoi elle compte pour la preuve |
|---|---|
|
- |
- |
|
Des analyses répétées et programmées |
Transforme une réponse bruitée en tendance lisible |
|
Une taille d'échantillon visible |
Indique si un changement dépasse le bruit |
|
Le suivi des concurrents sur les mêmes prompts |
Votre témoin pour neutraliser les mises à jour des modèles |
|
Des marqueurs de changement de modèle |
Vous évite d'attribuer à votre page l'effet d'une nouvelle version de modèle |
|
Les réponses brutes et les citations par prompt |
Confirme le mécanisme : l'IA a-t-elle utilisé votre page ? |
|
Un effet mesuré par rapport à un groupe témoin |
Compare ce que vous avez visé à ce que vous n'avez pas touché, une fois le travail terminé |
|
Des estimations séparées des mesures |
Distingue « ce que nous attendons » de « ce que nous avons mesuré » |
|
L'export des données |
Permet à un analyste de mener la comparaison de son côté |
Voici comment certaines options couvrent ces besoins en octobre 2026, d'après leurs propres sites :
- 3RD couvre la boucle décrite plus haut : suivi quotidien au regard de l'objectif d'un Playbook, changements de modèle signalés sur la chronologie, effet mesuré des tâches terminées par rapport aux autres prompts de la marque, vues concurrentielles, réponses et citations, et export via API, CSV, MCP et Looker Studio.
- Profound propose Agent Analytics, qui montre comment les robots d'IA consultent vos pages, les citent et y renvoient. Les données sur les visites des robots constituent un signal complémentaire utile pour l'étape 5.
- Peec AI suit la visibilité, la position et le sentiment dans le temps, avec des exports CSV, une API et un connecteur Looker Studio : un analyste peut ainsi construire la comparaison dans ses propres outils.
- La méthode manuelle fonctionne pour un ou deux prompts, mais vous collecterez rarement assez de réponses pour dépasser le bruit.
À propos des données
Les chiffres sur les 111 marques proviennent des marques suivies dans 3RD entre le 19 septembre et le 18 octobre 2026 : plus de 18 000 prompts et 732 000 réponses de l'IA issues de 11 assistants au maximum, anonymisées et agrégées, principalement sur les marchés nordiques. Les résultats des tâches portent sur 117 tâches terminées avec un groupe témoin, réparties sur 44 marques (de février à octobre 2026). Ces données sont observationnelles : elles montrent une corrélation, pas une causalité.
Questions fréquentes
Combien de temps attendre avant de juger une action GEO ? Quatre à six semaines pour une modification de contenu. Les modèles réexplorent et réapprennent à leur propre rythme : comptez de quelques jours à quelques semaines avant qu'une page apparaisse dans les réponses. Les citations de la page arrivent souvent avant la hausse des mentions.
Pourquoi ma visibilité IA a-t-elle bondi du jour au lendemain sans aucune modification ? Parce que les réponses de l'IA varient d'une analyse à l'autre. Sur les 111 marques que nous suivons, la marque médiane varie de 12,5 points entre son meilleur et son pire jour du mois. Comparez des périodes de 14 ou 28 jours, regardez si les concurrents ont évolué de la même façon et vérifiez s'il y a eu un changement de version de modèle.
Combien de prompts faut-il pour un test fiable ? Assez de réponses pour dépasser le bruit. Les marques qui recueillent moins d'une centaine de réponses par jour connaissent une variation quotidienne deux fois plus forte que celles qui en recueillent 230 ou plus. Cinq à quinze prompts cibles, analysés chaque jour sur au moins deux modèles pendant quatre semaines, donnent quelques centaines de réponses par période. C'est suffisant pour détecter un changement de l'ordre de 4 à 8 points.
Puis-je prouver que la visibilité IA a fait progresser le chiffre d'affaires ? Pas entièrement. La plupart des réponses de l'IA ne génèrent aucun clic, si bien qu'aucun outil ne peut retracer chaque décision influencée par l'IA. Vous pouvez afficher le trafic issu de l'IA remonté par GA4 à côté de votre visibilité, et demander à vos nouveaux clients comment ils vous ont connus. Voir comment relier la visibilité IA au chiffre d'affaires.
Quel est le meilleur signal unique que ma page a fonctionné ? Que l'IA cite la page sur les prompts qu'elle vise, et reprenne des faits qui n'apparaissent que sur cette page. C'est la preuve directe que l'IA a utilisé votre travail. La visibilité, la position et les recommandations suivent généralement, mais plus lentement. Une meilleure page ne garantit ni l'un ni l'autre à elle seule, comme le montre l'exemple de réécriture ci-dessus.
Commencez cette semaine : choisissez un sujet Must-win, notez ce que vous attendez et enregistrez deux semaines de référence avant de publier. Découvrez comment 3RD le suit, ou lancez votre essai gratuit.
Head of Marketing