Recherche IA
Comment choisir une plateforme de visibilité IA : la check-list 2026
14 critères, les questions à poser en démo, les signaux d'alerte et une grille de notation pour choisir une plateforme de visibilité IA, avec une sélection de 8 outils vérifiés.
 Magnus Windeløv19 oct. 2026 · 25 min de lecture
Sommaire
Choisissez la plateforme qui vous explique pourquoi l'IA choisit un concurrent et ce qu'il faut faire, sur les modèles et les marchés qu'utilisent vos clients, avec des chiffres que l'on peut toujours rattacher à de vraies réponses.
La plupart des outils de visibilité IA savent afficher un score. Bien moins nombreux sont ceux qui l'expliquent, et plus rares encore ceux qui aident votre équipe à le faire évoluer. C'est dans cet écart que se jouent la plupart des erreurs d'achat.
J'achète des logiciels marketing depuis dix ans, des deux côtés de la table : en interne, dans des entreprises SaaS et e-commerce, et en agence, pour plus de 30 marques clientes. La visibilité IA est la catégorie la plus difficile que j'aie eu à évaluer. Les chiffres bougent tous les jours, chaque éditeur compte à sa façon, et le compte de démonstration est toujours impeccable.
Ce guide est donc la check-list que j'aurais voulu avoir : les 14 critères qui départagent les plateformes, les questions à poser en démo, les signaux d'alerte, une grille de notation à copier et une sélection de huit plateformes vérifiées à partir de leurs propres pages publiques.
Une précision : je travaille chez 3RD, qui fait partie de la sélection. Pour illustrer chaque critère, j'utilise des captures d'écran d'un espace de démonstration : une marque d'articles de sport suivie par rapport à six concurrents au Danemark, en Suède, au Royaume-Uni et aux États-Unis, sur sept modèles d'IA et 207 prompts. Les noms de marques sont floutés, et les chiffres ne sont pas des résultats clients.
La réponse courte
Si vous ne deviez lire qu'une section, ce serait celle-ci.
- Le suivi est devenu un produit de base. Toutes les plateformes sérieuses envoient des prompts aux assistants IA et comptent les citations de marque. Ne payez pas un supplément pour un tableau de bord.
- Les vraies différences se jouent sur trois points : la façon dont les réponses sont collectées, la capacité de la plateforme à expliquer pourquoi vous perdez, et qui fait le travail après le diagnostic.
- Les prix sont difficiles à comparer. Chaque éditeur compte un « prompt » différemment. Convertissez chaque devis en nombre de réponses par mois avant de comparer.
- Faites un pilote avant de signer. Lancez 20 à 40 questions réelles de vos clients pendant au moins deux semaines, sur vos vrais marchés. Un compte de démonstration ne vous apprend rien sur votre catégorie, et quelques jours de données ne vous apprennent pas grand-chose, quel que soit le sujet.
Voyons ce que chacun de ces points signifie en pratique.
Ce qu'il vous faut avant de parler aux éditeurs
Consacrez-y d'abord une heure. Chaque démo sera plus courte, et chaque devis comparable.
- Les 20 questions de vos clients qui comptent le plus. Formulez-les comme un client les poserait à un assistant IA : « Quel est le meilleur logiciel de paie pour une entreprise de 50 personnes au Danemark ? », et non « logiciel de paie ». Ce seront vos prompts de pilote.
- Vos marchés. Listez chaque pays et chaque langue dans lesquels vous vendez. Le Danemark en danois et le Danemark en anglais sont deux marchés distincts, car l'IA ne répond pas de la même façon dans chaque langue.
- Les assistants IA qu'utilisent vos clients. ChatGPT figure presque toujours sur la liste. Ajoutez Google AI Overviews si vous dépendez de la recherche Google, Copilot si vous vendez à des entreprises très équipées en Microsoft, et Perplexity ou Claude si vos clients ont un profil technique.
- Cinq concurrents. Nommez les marques qui vous prennent des affaires, pas seulement les plus grands noms de votre secteur.
- Qui fera le travail. Notez le nom des personnes qui agiront sur les résultats, et le nombre d'heures par semaine dont elles disposent. C'est ce point, plus que n'importe quelle liste de fonctionnalités, qui détermine le type de plateforme dont vous avez besoin.
Voici à quoi ressemble cette configuration dans un espace de démonstration : 207 questions de clients pour une marque d'articles de sport, réparties en huit sujets et suivies au Danemark, en Suède, au Royaume-Uni et aux États-Unis.
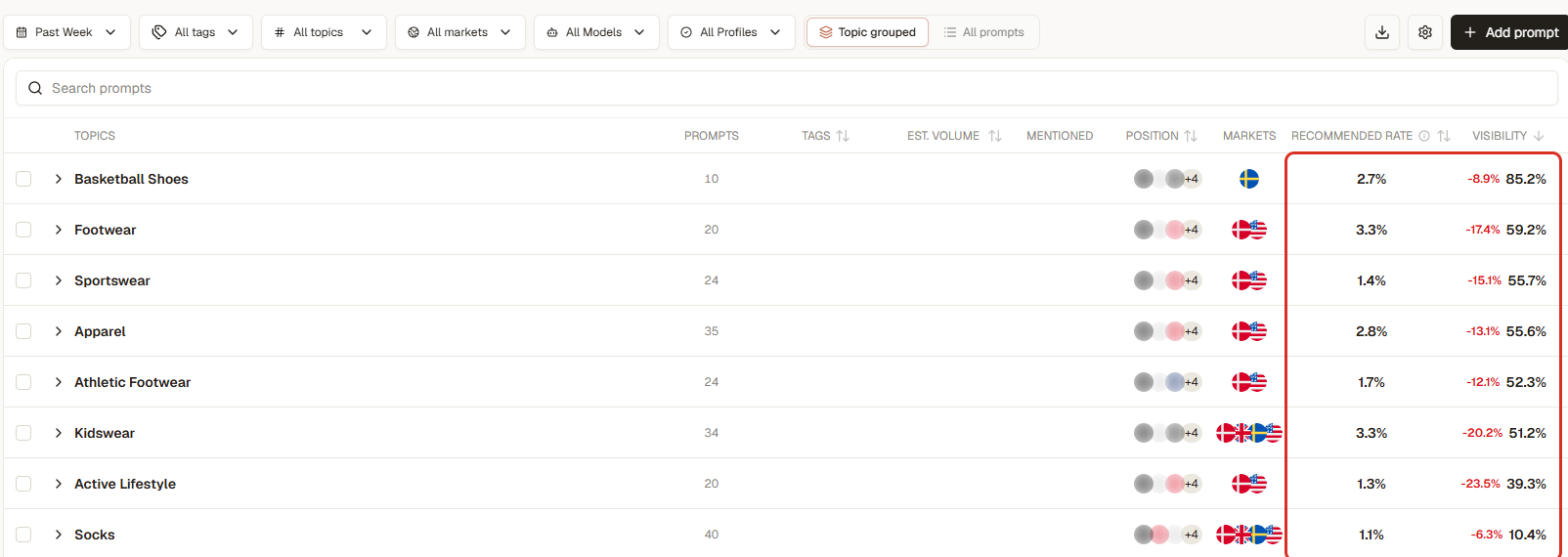
Les questions des clients regroupées par sujet, des chaussures de basket à 85,2 % de visibilité aux chaussettes à 10,4 %, chacune suivie par marché. Espace de démonstration ; noms de marques floutés.
Les 14 critères qui départagent les plateformes de visibilité IA
Les critères suivent l'ordre dans lequel on les rencontre quand on évalue un outil : peut-on se fier aux données, la plateforme explique-t-elle le résultat, peut-on agir dessus, et convient-elle à notre entreprise ?
Peut-on se fier aux données ?
1. La façon dont les réponses sont collectées. Les plateformes obtiennent les réponses de l'IA de deux manières. Certaines envoient les questions via l'API (interface de programmation) de chaque fournisseur d'IA. D'autres récupèrent les réponses dans l'interface de chat grand public, celle que les gens utilisent vraiment. Les réponses issues de l'interface peuvent contenir des éléments absents des réponses API, comme des fiches shopping ou une recherche web en direct. Les réponses API, elles, se déploient plus facilement à grande échelle et sur de nombreux marchés. Aucune des deux méthodes n'est mauvaise. L'important, c'est que l'éditeur vous dise laquelle il utilise pour chaque modèle.
2. Les modèles d'IA couverts, et ceux que vous pouvez activer. Demandez la liste exacte pour chaque offre. Beaucoup de plateformes annoncent neuf moteurs ou plus, mais n'en incluent que deux à quatre dans leurs offres d'entrée. Vérifiez aussi que vous pourrez changer de modèles plus tard, car les habitudes de vos clients évoluent.
Ce critère compte plus que la plupart des équipes ne le pensent, car les assistants ne désignent pas tous le même gagnant. Dans les données agrégées de 3RD sur 60 marques, le concurrent le plus visible changeait d'un assistant à l'autre pour 37 d'entre elles (62 %), avec le même jeu de prompts. Pour une même marque, l'écart entre son meilleur et son moins bon assistant atteignait 16 points en médiane (83 marques).
Voici ce que cela donne dans un espace de démonstration. La semaine dernière, sur les mêmes questions, la marque d'articles de sport était citée dans environ 60 % des réponses de ChatGPT, mais dans seulement 20 % environ de celles de Google AI Mode.
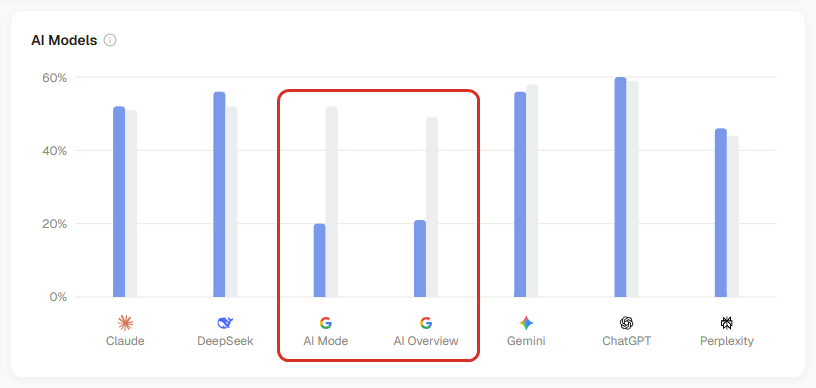
La visibilité par modèle : environ 60 % sur ChatGPT, environ 20 % sur Google AI Mode et AI Overviews. Espace de démonstration ; noms de marques floutés.
3. Les marchés et les langues. Demandez comment la plateforme définit un marché. Une bonne réponse : un pays et une langue, suivis séparément, le marché étant transmis au modèle d'IA comme contexte. Une réponse faible : « Nous couvrons plus de 50 pays », sans rien dire de la langue.
4. Le décompte des prompts. C'est là que commence la plupart des confusions sur les prix. Un éditeur compte un prompt une seule fois, quel que soit le nombre de modèles. Un autre le compte une fois par modèle. Un troisième, une fois par modèle et par marché. Demandez à chaque éditeur d'exprimer son décompte sous cette forme :
réponses par mois = questions × modèles × marchés × analyses par mois
5. La fréquence des analyses et la variabilité des réponses. Les modèles d'IA sont probabilistes : la même question peut recevoir une autre réponse demain. Une plateforme qui lance chaque question une fois par semaine ne peut pas distinguer un vrai changement du bruit.
Quelle est l'ampleur de ce bruit ? Dans des données agrégées portant sur 111 marques et 732 000 réponses d'IA, la visibilité quotidienne de la marque médiane a varié de 12,5 points entre son meilleur et son plus mauvais jour sur un mois, sans aucun changement de prompts. Pour 7 marques sur 10, au moins une mesure journalière s'écartait de plus de 5 points de la moyenne sur 30 jours. Et plus le jeu de prompts était petit, plus le bruit était fort : les marques avec moins d'environ 100 réponses par jour variaient à peu près deux fois plus que celles qui en avaient 230 ou plus.
Une tendance sur 90 jours rend ce bruit visible. Les courbes quotidiennes montent et descendent, et quand un fournisseur d'IA change le modèle qui se cache derrière un assistant, la série est rompue.
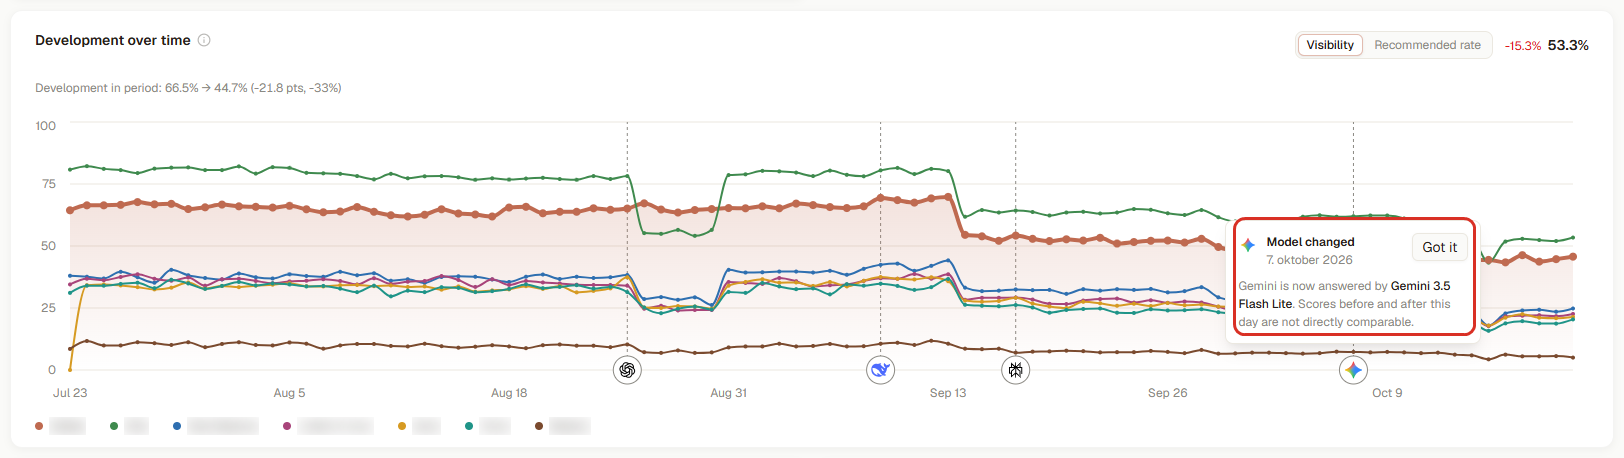
Trois mois de visibilité quotidienne. Les scores varient d'un jour à l'autre, et un marqueur « Model changed » au 7 octobre signale le moment où Gemini a changé de version de modèle : les scores d'avant et d'après ne sont donc pas directement comparables. Espace de démonstration ; noms de marques floutés.
Posez donc deux questions : à quelle fréquence chaque question est-elle lancée, et comment la plateforme vous montre-t-elle qu'un changement est réel ? Une bonne réponse inclut des analyses quotidiennes et un moyen de signaler les changements de modèle.
6. La traçabilité. Chaque score doit pouvoir s'ouvrir sur les réponses elles-mêmes et sur les sources citées par l'IA. Si vous ne pouvez pas passer en un clic de « la visibilité a baissé de 8 points » aux réponses qui ont changé, vous ne pourrez pas expliquer le chiffre à votre direction marketing. Vérifiez aussi que le score affiche sa base. Dans un espace de démonstration, les 44,5 % de la marque d'articles de sport sur la semaine écoulée correspondent à 4 051 citations dans 9 105 réponses, la marque apparaissant sur 172 des 207 prompts. C'est bien plus parlant qu'un pourcentage seul, car vous voyez quel volume de données se trouve derrière.
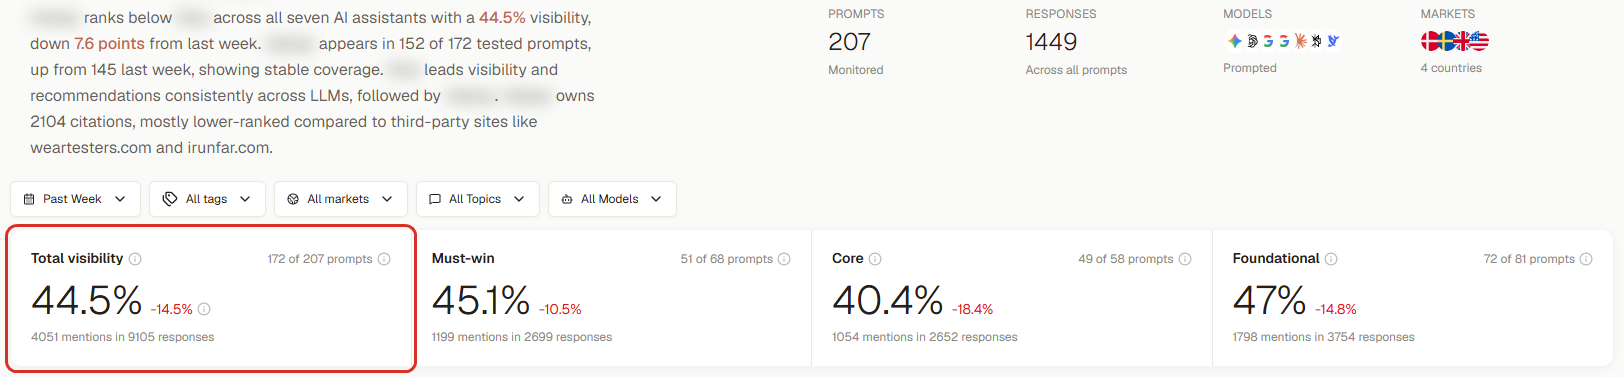
Vue d'ensemble de la visibilité sur la semaine écoulée : 44,5 %, avec sa base de 4 051 citations dans 9 105 réponses et une répartition par niveau de prompt. Espace de démonstration ; noms de marques floutés.
La plateforme explique-t-elle pourquoi vous n'êtes pas choisi ?
7. Un diagnostic, pas seulement une description. Un score vous dit où vous en êtes. Un diagnostic vous dit pourquoi l'IA choisit un concurrent : une page comparative manquante, un classement tiers qui le cite et pas vous, une page que l'IA n'arrive pas à lire. Demandez à l'éditeur de vous montrer un diagnostic pour un vrai concurrent de votre catégorie.
Voici à quoi ressemble un diagnostic en langage clair, dans un espace de démonstration. Au Danemark, la marque d'articles de sport est à 43,4 %, contre 49,3 % pour le leader : elle est donc absente d'environ 6 réponses d'IA sur 10. Le diagnostic donne trois raisons, avec des mots simples : la qualité des pages limite la façon dont l'IA cite la marque, sa présence dans les publications que lit l'IA est inégale, et les clients qui interrogent l'IA tombent d'abord sur le leader.
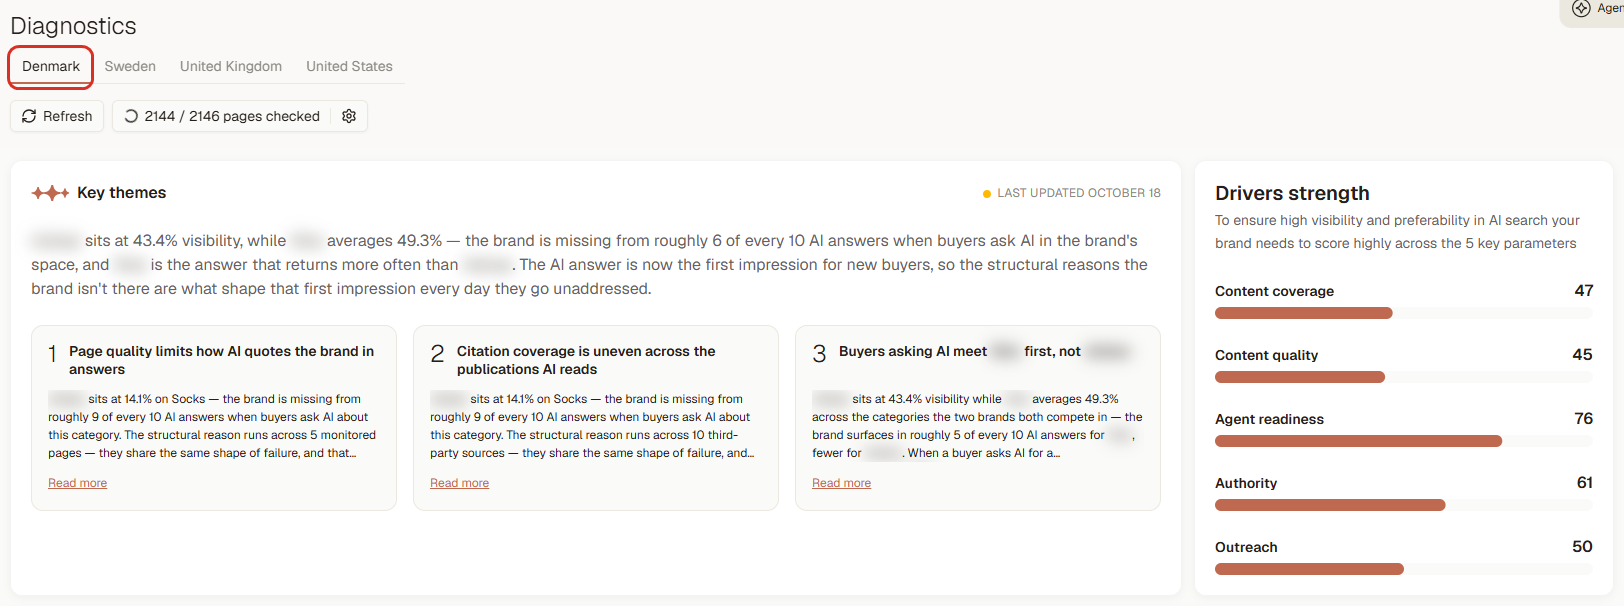
Le diagnostic d'un marché, le Danemark : les thèmes clés derrière le score, en langage clair, à côté des cinq facteurs. Espace de démonstration ; noms de marques floutés.
Un bon diagnostic vérifie aussi votre propre site. Dans l'espace de démonstration, le rapport Agent readiness porte sur 2 144 des 2 146 pages et relève 15 problèmes. Deux des quatre domaines, Reachable et Actionable, sont signalés comme critiques. Les agents ne trouvent pas comment acheter, car le bouton d'achat ne fonctionne qu'en JavaScript. Les produits n'ont pas d'identifiants comme un GTIN ou un SKU. Et le titre ou la description manquent sur 1 315 pages. Ces problèmes sont fréquents, et faciles à manquer sans contrôle.
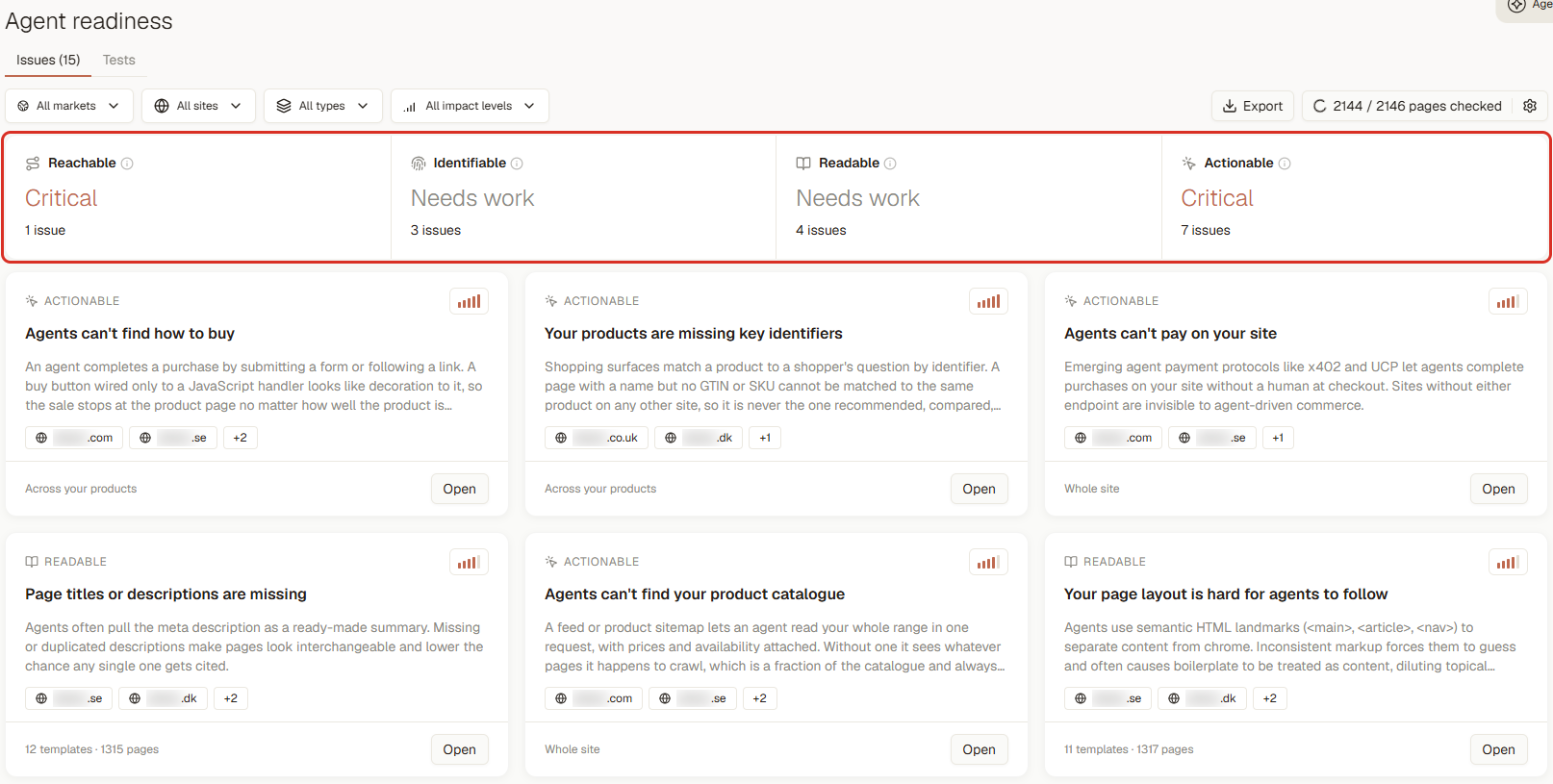
Un rapport Agent readiness qui liste les problèmes empêchant les agents d'accéder au site, de le lire ou d'y acheter. Espace de démonstration ; noms de marques floutés.
Une mise en garde, toutefois : l'accès technique est rarement le problème principal. Dans des données agrégées sur 60 marques, le score médian d'accessibilité aux robots d'indexation était de 99 sur 100, et ce facteur n'était le plus faible pour aucune des 54 marques dont les cinq facteurs étaient mesurés. Pour 42 d'entre elles, le frein était l'autorité ou la qualité du contenu. Si un éditeur met en avant « nous allons corriger votre accessibilité aux robots », demandez-lui ce qu'il trouve d'autre.
8. Les citations et les sources. Les réponses de l'IA s'appuient sur les pages qu'elles citent. Vous devez voir quelles pages sont citées, si ce sont les vôtres ou celles de tiers, et quelles pages tierces mentionnent vos concurrents mais pas vous. Cette liste, c'est votre plan d'outreach.
9. Recommandation ou simple citation. Être cité dans une liste et être recommandé sont deux résultats différents, et l'écart est important. Dans les données agrégées de 3RD sur 60 marques et 494 000 réponses analysées, la marque médiane était citée dans 19,8 % des réponses, mais recommandée plutôt que les autres options dans 0,2 % seulement. Cela fait environ une recommandation pour 65 citations, et un quart des marques (15 sur 60) n'a jamais été recommandé de tout le mois.
La définition de 3RD est stricte : la réponse doit vous choisir plutôt que les autres options, et apparaître en premier dans une liste ne suffit pas. Posez deux questions à chaque éditeur. L'outil distingue-t-il « cité » et « recommandé » ? Et les questions contenant le nom de votre marque sont-elles exclues de la mesure ? Une question qui cite déjà votre marque gonfle le résultat.
Votre équipe peut-elle agir ?
10. Du diagnostic à un plan priorisé. Demandez ce que vous obtenez après le diagnostic. Une liste de conseils génériques (« ajoutez un schéma FAQ ») n'est pas un plan. Un plan rattache chaque tâche à un objectif, à un ensemble de prompts et à un impact estimé, pour que les tâches les plus utiles passent en premier.
11. Qui fait le travail, et ce qui est automatisé. Les plateformes se répartissent en trois familles :
- Suivi uniquement : vous obtenez les données, et votre équipe ou votre agence fait tout le reste.
- Brouillons avec validation : la plateforme rédige des pages, des briefs ou des messages d'outreach, et une personne les vérifie et les publie.
- Exécution autonome : des agents réalisent les tâches à votre place, parfois en publiant directement.
Aucune ne convient à tout le monde. Une équipe qui a une solide fonction contenu peut se contenter des données. Une équipe marketing de deux personnes aura sans doute besoin de brouillons. Une entreprise réglementée peut exiger qu'une personne valide chaque modification. Décidez de ce qu'il vous faut avant la démo.
12. La mesure de l'impact. Une fois que votre équipe a publié une modification, pouvez-vous voir si elle a fonctionné ? Cherchez une mesure avant-après rattachée aux prompts précis visés par le travail, comparée aux prompts auxquels vous n'avez pas touché, et tenue à l'écart de l'estimation faite au départ.
Ce groupe de contrôle est essentiel, car une simple mesure avant-après revient presque à jouer à pile ou face. Dans les données agrégées de 3RD, nous avons étudié 117 tâches terminées pour lesquelles la visibilité sur les prompts visés a été comparée à un groupe de contrôle composé des prompts non travaillés de la même marque. 29 % ont progressé de plus de 5 points par rapport au groupe de contrôle, 26 % ont reculé de plus de 5 points, et 44 % sont restées à moins de 5 points d'écart. Cela ne veut pas dire que le travail échoue. Cela veut dire qu'une plateforme sans groupe de contrôle ne peut pas vous dire lequel de ces résultats vous avez obtenu. Comptez de quelques jours à quelques semaines entre la publication et un changement mesurable, car les modèles d'IA réexplorent et réapprennent à leur propre rythme.
La plateforme convient-elle à votre entreprise ?
13. Le reporting et l'accès aux données. Votre direction marketing veut une page, pas une visite guidée du tableau de bord. Vérifiez la présence de rapports programmés, d'un export CSV, d'une API et d'un connecteur vers votre outil de business intelligence. Si le trafic issu de l'IA vous intéresse, vérifiez quels outils d'analytics se connectent (par exemple GA4 ou Adobe Analytics), et avec quelle offre.
Le trafic issu de l'IA mérite qu'on s'y arrête, car les clics peuvent venir des citations de sources comme des mentions de marque. Demandez quelle configuration il faut prévoir. Dans 3RD, il n'y a qu'une étape : connecter votre propriété GA4. Tant que ce n'est pas fait, la vue trafic affiche un écran de connexion. Une fois la connexion établie, les sessions et les indicateurs d'utilisateurs venant des assistants IA s'affichent à côté de votre visibilité, dans le même tableau de bord.
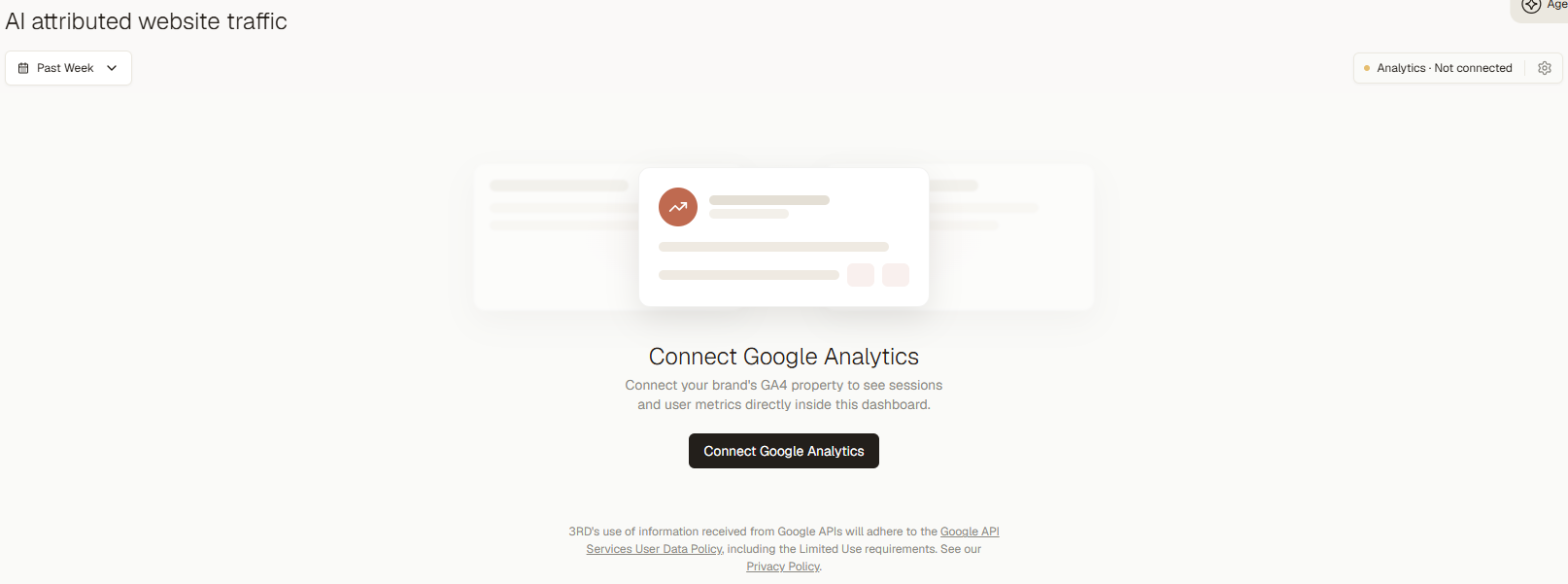
Tant que GA4 n'est pas connecté, la vue trafic vous demande votre propriété. Ensuite, les sessions issues de l'IA s'affichent à côté de la visibilité. Espace de démonstration ; noms de marques floutés.
14. Sécurité, localisation des données et conditions commerciales. Demandez où les données sont stockées, quels fournisseurs d'IA les traitent, si vos données servent à entraîner des modèles publics, et quelles certifications l'éditeur détient aujourd'hui, par opposition à celles qu'il « est en train d'obtenir ». Demandez si l'authentification unique (SSO) est disponible, et avec quelle offre. Enfin, vérifiez que les prix sont publiés et qu'un essai peut se faire sur vos propres prompts.
Les questions à poser à chaque démo
Reprenez-les telles quelles. Un bon éditeur répond à chacune en moins d'une minute.
- « Montrez-moi une réponse obtenue par l'un de nos concurrents, et les sources que l'IA a citées. »
- « Comment collectez-vous les réponses de ChatGPT : par l'API, par l'interface, ou les deux ? »
- « Si je suis 30 questions sur 3 modèles et 2 marchés, combien de prompts cela représente-t-il dans vos tarifs ? »
- « À quelle fréquence chaque question est-elle lancée, et comment me montrez-vous qu'un changement est réel et non du bruit ? »
- « Pourquoi notre principal concurrent remporte-t-il cette question ? Montrez-moi les éléments qui le prouvent. »
- « Distinguez-vous le fait d'être cité et celui d'être recommandé ? »
- « Que se passe-t-il exactement après le diagnostic ? Qui rédige la page, et qui la publie ? »
- « Après une correction, où puis-je voir si elle a fait bouger le chiffre, par rapport aux prompts auxquels nous n'avons pas touché ? »
- « Puis-je exporter les réponses brutes et les citations ? »
- « Où nos données sont-elles stockées, et quelles certifications détenez-vous aujourd'hui ? »
- « Pouvons-nous faire un essai sur nos propres questions et nos propres marchés avant de signer ? »
Les signaux d'alerte
- Un score global unique, sans filtres. Une même marque peut être à 50 % sur un modèle et à 30 % sur un autre pour les mêmes questions. Une moyenne masque le modèle sur lequel vous perdez.
- Un « volume de recherche » pour les prompts. Aucune plateforme ne dispose d'un vrai volume de recherche pour les prompts d'IA. Tout indicateur de demande est une estimation, et l'éditeur doit expliquer comment il est construit.
- Des conseils qui conviendraient à n'importe quelle entreprise. Si les recommandations ne citent ni vos concurrents, ni vos pages, ni les sources en jeu, elles n'ont pas été écrites pour vous.
- Aucun moyen de voir les réponses. Si l'éditeur ne montre que des graphiques, vous ne pouvez rien vérifier.
- Des « preuves » avant-après sans groupe de contrôle. Comme le montrent les données sur les tâches citées plus haut, une mesure avant-après brute monte à peu près aussi souvent qu'elle baisse.
- Des promesses de chiffre d'affaires. Aucune plateforme ne peut aujourd'hui attribuer un chiffre d'affaires à la visibilité organique dans l'IA, car la plupart des réponses de l'IA ne génèrent aucun clic. Un éditeur qui le promet fait des suppositions.
- Une démo qui ne montre qu'une marque d'exemple. Demandez à voir votre propre catégorie, ou faites un essai.
Une grille de notation à copier
Pondérez chaque critère selon votre situation, notez chaque éditeur de 1 à 5, puis multipliez. Les pondérations ci-dessous conviennent à une équipe marketing de taille moyenne qui vend sur plusieurs marchés européens. Adaptez-les à la vôtre.
|
Critère |
Poids (1–3) |
Éditeur A |
Éditeur B |
Éditeur C |
|---|---|---|---|---|
|
1. Méthode de collecte des réponses |
2 |
|
|
|
|
2. Modèles couverts et modifiables |
2 |
|
|
|
|
3. Marchés et langues |
3 |
|
|
|
|
4. Décompte clair des prompts |
2 |
|
|
|
|
5. Fréquence des analyses et variabilité |
2 |
|
|
|
|
6. Traçabilité jusqu'aux réponses |
3 |
|
|
|
|
7. Diagnostic des raisons de la défaite |
3 |
|
|
|
|
8. Citations : vos pages et pages tierces |
2 |
|
|
|
|
9. Recommandation ou citation |
2 |
|
|
|
|
10. Plan priorisé |
3 |
|
|
|
|
11. Qui fait le travail |
3 |
|
|
|
|
12. Impact mesuré, avec groupe de contrôle |
2 |
|
|
|
|
13. Reporting et accès aux données |
2 |
|
|
|
|
14. Sécurité et conditions |
2 |
|
|
|
|
Total pondéré |
|
|
|
|
Un pilote de deux semaines pour trancher
Deux semaines, c'est le minimum. Avec une variation mensuelle médiane de 12,5 points, quelques jours de données peuvent pencher d'un côté comme de l'autre.
- Jour 1 : chargez les mêmes 20 à 40 questions de clients dans chaque plateforme présélectionnée, sur les mêmes marchés et les mêmes modèles.
- Jours 2 à 7 : ne réagissez pas aux chiffres quotidiens. Lisez les réponses et vérifiez que les plateformes repèrent correctement votre marque et vos concurrents. Si le nom de votre marque est court, ou s'il s'agit aussi d'un mot courant, vérifiez-le avec soin : des pages sans rapport peuvent être comptées comme des citations.
- Jour 8 : demandez à chaque plateforme les trois principales raisons pour lesquelles un concurrent vous devance, preuves à l'appui.
- Jours 9 à 14 : mettez en œuvre une recommandation de chaque plateforme et notez le temps qu'il a fallu à votre équipe.
- Jour 14 : notez chaque éditeur avec la grille ci-dessus. Les heures gagnées par votre équipe font généralement la différence.
La sélection : huit plateformes de visibilité IA comparées
Les informations proviennent des pages tarifs ou produit de chaque éditeur, consultées les 18 et 19 octobre 2026. Quand un éditeur ne publie pas une information, le tableau l'indique. Les prix changent souvent : vérifiez-les avant d'acheter. Pour une lecture des mêmes outils selon votre type d'équipe, voir Alternatives à Profound en 2026.
|
Plateforme |
Modèles d'IA (publics) |
Prix d'entrée (public) |
Marchés |
Au-delà du suivi |
Essai |
|---|---|---|---|---|---|
|
Profound |
Jusqu'à 9 sur Enterprise ; 3 pendant l'essai |
Non publié (Enterprise sur devis) |
1 région et 1 langue pendant l'essai ; sur devis avec Enterprise |
Les agents rédigent et publient dans votre CMS après une étape de validation |
Gratuit : 50 prompts, chaque jour pendant 7 jours |
|
Peec AI |
3 par offre, d'autres en option payante |
85 €, 205 €, 425 € par mois pour 50, 150 et 350 prompts (vérifié le 18 octobre) |
Plusieurs pays à partir de l'offre Pro |
Actions recommandées, analyse des écarts, optimisation de contenu |
Non précisé sur la page tarifs |
|
Otterly |
4 inclus (ChatGPT, AI Overviews, Perplexity, Copilot) ; Gemini, AI Mode et Claude en option |
De 29 $ par mois (15 prompts) à 489 $ (400 prompts) |
Prise en charge multipays |
Recommandations et audits GEO d'URL |
Non précisé sur la page tarifs |
|
Semrush AI Visibility Toolkit |
Citations dans ChatGPT, Google AI, Gemini et Perplexity |
99 $ par mois et par domaine, en facturation annuelle ; 25 prompts suivis |
Non précisé sur la page tarifs |
AI Visibility Score, part de voix, sentiment et audit de site pour la recherche IA, au sein de la suite Semrush |
Essai Semrush de 7 jours ; non précisé pour le toolkit |
|
Scrunch |
ChatGPT, Claude, Gemini, Perplexity, AI Mode, AI Overviews, Meta |
300 $ par mois sans engagement (250 $ en facturation annuelle), 350 prompts personnalisés |
Non précisé |
Audits de pages ; AXP, une version de votre site pensée pour l'IA |
7 jours, sans carte bancaire |
|
AthenaHQ |
5 dans l'offre gratuite ; 11 sur Starter |
Offre gratuite (300 crédits) ; Starter à 295 $ par mois (3 600 crédits) |
Une région et une langue sur Starter ; multirégion sur Enterprise |
Agent d'optimisation de contenu, actions on-page et off-page |
Offre gratuite |
|
KIME |
2 (Explorer), 3 (Core), tous sur Enterprise |
99 € par mois (50 prompts) ; 399 € (200 prompts) |
Pays et langues illimités |
Les agents AWX réalisent les tâches à votre place (10 ou 30 par mois) |
7 jours |
|
3RD |
Jusqu'à 2, 3 ou 4 selon l'offre ; jusqu'à 13 sur Enterprise |
99 € par mois (40 prompts) ; 299 € (100) ; 499 € (300) ; 84 €, 254 €, 424 € en facturation annuelle |
1 marché sur Starter ; n'importe quel marché à partir de Pro ; un marché correspond à un pays dans une langue |
Diagnostic des raisons pour lesquelles l'IA choisit un concurrent, Playbooks avec tâches priorisées, brouillons de 3RD Agent que vous validez |
7 jours, sans carte bancaire |
Pour qui chaque plateforme est faite
- Profound convient aux grandes entreprises qui veulent une large couverture des moteurs et une suite complète d'outils de travail, et qui peuvent acheter via un processus commercial. Les prix ne sont pas publics : prévoyez une négociation.
- Peec AI convient aux équipes qui veulent un suivi clair et abordable, avec plusieurs modèles inclus dans toutes les offres. Il donne plus de réponses par euro que la plupart des plateformes de cette liste.
- Otterly convient aux petites équipes et aux responsables marketing indépendants qui veulent le prix d'entrée le plus bas, audits GEO inclus.
- Semrush AI Visibility Toolkit convient aux équipes qui vivent déjà dans Semrush. Avec 25 prompts suivis, le volume reste faible.
- Scrunch convient aux équipes qui veulent de gros volumes de prompts et une version de leur site destinée aux agents.
- AthenaHQ convient aux équipes qui veulent démarrer gratuitement et essayer de nombreux modèles grâce à un système de crédits.
- KIME convient aux équipes qui veulent que des agents réalisent les tâches sans qu'une personne rédige chacune d'elles.
- 3RD convient aux équipes marketing qui veulent savoir pourquoi l'IA choisit un concurrent et obtenir un plan priorisé, avec des brouillons que leur équipe vérifie avant toute mise en ligne. Il suit chaque couple pays–langue comme un marché à part entière, ce qui compte pour les marques européennes qui vendent en plusieurs langues.
Exemple concret : évaluer 3RD avec cette check-list
Voici comment tester 3RD sur ces critères pendant l'essai de sept jours. Appliquez les mêmes étapes à chaque plateforme de votre sélection.
- Chargez vos questions et vos marchés. Ajoutez vos 20 questions de clients, classez-les en Must-win, Core ou Foundational, et choisissez votre marché. Connectez Google Search Console pour obtenir des suggestions de questions à partir des recherches sur lesquelles vous apparaissez déjà. (Critères 3 et 4.)
- Lisez les réponses, pas seulement le score. Ouvrez Conversations pour voir chaque réponse de l'IA, l'endroit où votre marque apparaît et les sources citées. Chaque score affiche sa base, par exemple « 4 051 citations dans 9 105 réponses ». (Critères 5 et 6.)
- Demandez pourquoi vous perdez. Ouvrez Diagnostics. L'outil vous compare aux concurrents suivis et rattache chaque constat à des éléments concrets, par exemple la page comparative d'un concurrent, citée dans la plupart des réponses, alors que vous n'avez rien d'équivalent. (Critères 7 et 8.)
- Transformez le diagnostic en plan. Créez un Playbook avec un objectif. Dans l'espace de démonstration, un Playbook pour le Danemark vise à porter le score de visibilité à 27 % sur les prompts Must-win du sujet « active lifestyle », en partant de 11 %. 3RD génère des tâches assorties d'une estimation d'impact, si bien que les tâches les plus porteuses remontent en tête de liste. (Critère 10.)
- Confiez l'étape suivante à 3RD Agent. Demandez-lui « Que devons-nous corriger en premier ? », puis demandez-lui de rédiger la page. Chaque modification apparaît sous forme de fiche que vous pouvez modifier, valider ou refuser. Rien n'est mis en ligne sans votre accord, et c'est toujours vous qui publiez. (Critère 11.)
- Vérifiez comment l'impact est mesuré. Chaque tâche terminée montre ce qui a réellement bougé sur les prompts visés, par rapport aux autres prompts de la marque, séparément de l'impact estimé. (Critère 12.)
Les limites, en toute honnêteté : l'offre d'entrée de 3RD couvre un marché et deux modèles d'IA. Le trafic issu de l'IA via GA4 ou Adobe Analytics est inclus à partir de l'offre Growth. 3RD n'est pas encore certifié SOC 2 ni ISO 27001 ; ses contrôles suivent ces référentiels et les données sont stockées dans des régions de l'UE. Le SSO via SAML peut être mis en place pour les clients Enterprise, sur accord. Voir Sécurité.
Un constat que la plupart des comparatifs oublient : le leader change selon le modèle
Sur 60 marques clientes suivies dans 3RD, le concurrent le plus visible changeait d'un assistant à l'autre pour 62 % d'entre elles, avec le même jeu de prompts.
L'espace de démonstration montre à quel point les chiffres d'une même marque diffèrent selon l'assistant. La visibilité porte sur la semaine écoulée ; le taux de recommandation est tiré de la réponse de 3RD Agent dans le même espace.
|
Modèle d'IA |
Visibilité de la marque de démonstration |
Taux de recommandation de la marque de démonstration |
|---|---|---|
|
ChatGPT |
environ 60 % |
non communiqué |
|
Claude |
environ 52 % |
3,8 % |
|
DeepSeek |
environ 56 % |
3,7 % |
|
Gemini |
environ 56 % |
0,3 % |
|
Google AI Mode |
environ 20 % |
0,3 % |
Mêmes questions, lectures très différentes. Gemini cite souvent la marque, mais ne la recommande presque jamais. Google AI Mode ne fait ni l'un ni l'autre. Deux enseignements en découlent, quel que soit l'outil que vous choisissez :
- Ne vous fiez pas à un score unique qui mélange tout. Il masque le modèle sur lequel vous perdez.
- Suivez les modèles qu'utilisent vos clients. Une plateforme avec moins de modèles, mais les bons, vaut mieux qu'une plateforme avec beaucoup de modèles qui ne correspondent pas à vos clients.
À propos des données
Les captures d'écran et les exemples détaillés (vue d'ensemble, diagnostic, graphique par modèle, rapport Agent readiness, écran de connexion du trafic et tableau par modèle) proviennent d'un espace de démonstration pour une marque d'articles de sport, dont les noms de marques sont floutés. Ce ne sont pas des résultats clients. Les constats clients proviennent de données 3RD agrégées et anonymisées, collectées du 19 septembre au 18 octobre 2026 : la variation quotidienne sur 111 marques et 732 000 réponses d'IA ; le désaccord entre modèles, l'écart entre recommandation et citation et les scores des facteurs sur 60 marques au maximum, à raison de trois par organisation cliente au plus ; les résultats des tâches sur 117 tâches terminées avec groupe de contrôle, pour 44 marques (de février à octobre 2026). L'échantillon compte une majorité de marques nordiques. Aucune marque, aucun domaine et aucun prompt n'est nommé. Il s'agit de données d'observation, pas d'une expérience contrôlée.
FAQ
Quelle différence entre une plateforme de visibilité IA et un outil de GEO ? Il s'agit en grande partie de la même catégorie. « Visibilité IA » décrit ce que l'on mesure : votre présence dans les réponses de l'IA. La GEO (generative engine optimization) désigne le travail qui permet de l'améliorer. Les meilleures plateformes font les deux : elles mesurent, expliquent et vous aident à agir.
De combien de prompts avons-nous besoin ? Commencez par 20 à 40 questions de clients à forte valeur par marché. Couvrir vos questions Must-win compte plus que le volume, mais les très petits ensembles sont bruités : dans nos données, les marques avec moins d'environ 100 réponses par jour variaient d'un jour à l'autre à peu près deux fois plus que celles qui en avaient 230 ou plus. Multipliez par le nombre de modèles et de marchés pour connaître votre consommation réelle dans les tarifs de chaque éditeur.
Quels modèles d'IA faut-il suivre ? Ceux qu'utilisent vos clients. Pour la plupart des marques B2B et B2C, cela veut dire ChatGPT, plus Google AI Overviews ou Gemini, puis Copilot, Perplexity ou Claude selon votre audience. Les résultats varient beaucoup d'un modèle à l'autre : dans nos données, la marque médiane présentait un écart de 16 points entre son meilleur et son moins bon assistant.
Une plateforme peut-elle garantir notre présence dans ChatGPT ? Non. Les modèles d'IA choisissent eux-mêmes leurs réponses et les font évoluer avec le temps. Une plateforme peut vous montrer pourquoi vous n'êtes pas choisi et vous aider à en corriger les causes : pages manquantes, faible présence dans les sources tierces, pages que l'IA n'arrive pas à lire.
Combien de temps avant de voir des résultats ? Comptez de quelques jours à quelques semaines entre la publication d'une modification et son effet dans les réponses de l'IA, car les modèles réexplorent et réapprennent à leur propre rythme. Suivez la tendance sur plusieurs semaines plutôt que le chiffre du jour, et comparez les prompts que vous avez travaillés à ceux que vous n'avez pas touchés.
Étape suivante
Notez dès aujourd'hui vos 20 questions de clients, puis démarrez un essai gratuit de 3RD avec elles, ou comparez 3RD aux autres plateformes.
Head of Marketing